SQL Server 存储过程分页:取消游标,使用临时表与联合查询实现精准结果
在 SQL Server 中处理主从表关联分页时,直接使用 ROW_NUMBER 会导致记录数被明细行放大。本文对比了游标与临时表两种方案,详细展示了如何通过“先分页提取主表 ID,再关联查询明细”的方式,在不使用低效游标的情况下,获得准确的主表分页结果及对应的完整明细数据。
2026-10-16
0



在 SQL Server 中处理主从表关联分页时,直接使用 ROW_NUMBER 会导致记录数被明细行放大。本文对比了游标与临时表两种方案,详细展示了如何通过“先分页提取主表 ID,再关联查询明细”的方式,在不使用低效游标的情况下,获得准确的主表分页结果及对应的完整明细数据。
面对MySQL千万级数据,直接使用LIMIT offset, size会导致严重的延迟。本文解析深层原因,提供基于主键自增的回表优化、区间查询及业务层游标分页等实战方案,显著提升大偏移量下的查询性能。
本文详解MySQL中非空约束(NOT NULL)的用法。通过具体案例演示如何在创建表时定义非空字段,如何修改现有表添加或移除非空约束,并提供完整的SQL语句及运行结果参考,帮助用户规范数据库设计。
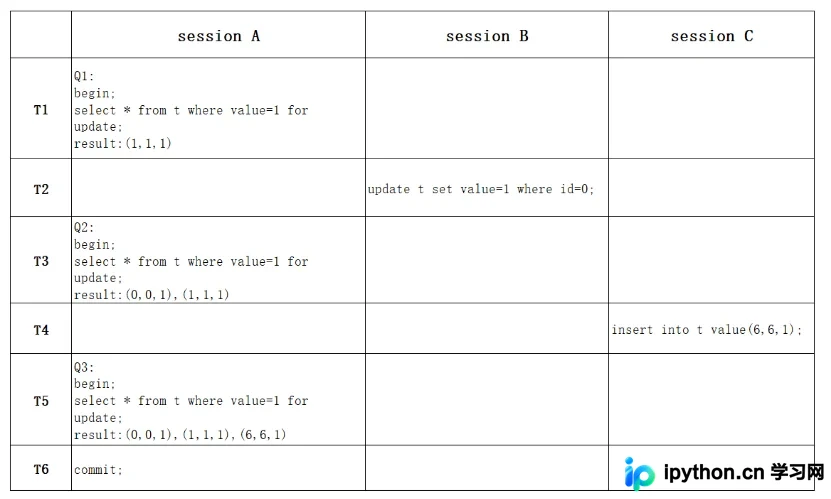
本文探讨MySQL在“可重复读”(RR)隔离级别下如何彻底解决“幻读”问题。普通查询(快照读)依靠MVCC机制保证一致性,而加锁查询(当前读)则引入间隙锁(Gap Lock)锁定记录间的逻辑区间。文章通过Next-Key Lock机制分析并发控制策略,并指出在高并发场景下RC隔离级别的替代方案及其潜在风险。
本文介绍如何仅凭借 .frm 文件恢复 MySQL 数据表的定义结构。针对 InnoDB 引擎,通过在同名数据库重建空表并覆盖 .frm 文件实现;针对 MyISAM 引擎,则需建立 .MYI/.MYD 占位文件后执行 REPAIR TABLE ... USE_FRM 命令。该方法适用于备份丢失但保留基础文件时的紧急恢复场景。
在MySQL开发中,处理重复数据插入是常见需求。本文详细解析INSERT IGNORE、ON DUPLICATE KEY UPDATE和REPLACE INTO三种核心语法的使用场景与差异,涵盖主键与唯一索引前提。同时提供基于CASE WHEN的高效批量更新方法,以及百万级数据的批量插入优化策略,帮助开发者避免错误日志并提升数据写入性能。
当MySQL Slave节点的Slave_SQL_Running状态为No导致主从不同步时,可根据数据一致性要求选择不同修复方案。若业务允许短暂数据差异,可通过设置sql_slave_skip_counter跳过报错语句快速恢复;若需严格数据一致,则需锁定主库、备份并重置从库同步点(CHANGE MASTER TO),重新建立复制链路。
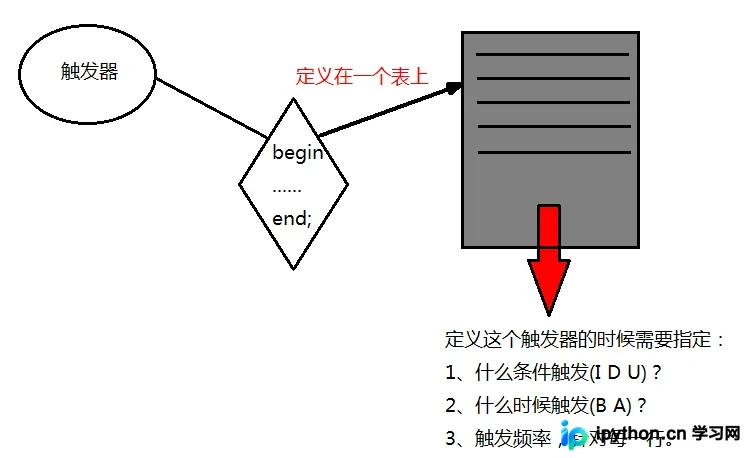
本文详解MySQL中触发器Trigger的创建、查看与删除方法。涵盖BEFORE/AFTER时机、INSERT/UPDATE/DELETE事件类型,以及NEW和OLD变量的具体应用示例,帮助开发者掌握数据完整性校验与自动化操作技巧。
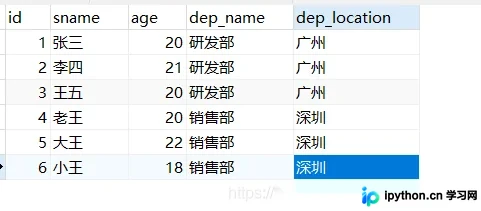
本文详解MySQL数据库中表设计的五大约束(主键、非空、唯一、外键、默认),涵盖其概念作用、创建时的列级与表级语法、修改表结构时的添加与删除操作,以及自增长列的设置方法。通过员工与部门的外键关联实例,直观展示如何保障数据完整性并防止冗余。
针对PHP内置日期处理函数的局限性,本文介绍一种通过连接数据库直接调用MySQL函数来增强日期计算能力的方法。文章提供了一个基于SELECT语句执行DATE_ADD操作的具体示例,展示了如何在PHP代码中获取并返回计算结果,从而简化复杂的日期逻辑处理。尽管该方法在特定场景下具有实用价值,但在现代开发中更推荐使用PDO或原生Date类库进行重构。
在MySQL中查询部门等树形目录时,若在WHERE子句中直接调用自定义树状遍历函数,会导致每行记录触发一次函数执行,造成严重的性能下降。本文通过对比实验揭示该问题,并提供一种先预计算树状ID集合、再关联过滤的优化方案,将单次查询耗时从0.5秒降至0.06秒。同时提供两种通用的树形节点提取SQL实现供参考。
本文深入解析 MySQL 中用于 SQL 高级过滤的 LIKE 通配符,详细演示 %(匹配任意字符)与 _(匹配单个字符)的实际应用案例。针对以星号开头导致的搜索缓慢问题,提供具体优化建议,同时强调尾空格干扰及 NULL 值处理的注意事项,帮助开发者实现高效且准确的模糊查询。



