






RAG典型应用场景:企业知识库问答与智能客服落地案例
本文探讨检索增强生成(RAG)在企业知识库与智能客服中的实际应用。通过分析内部制度查询、技术文档检索及客户服务场景,指出RAG的核心价值在于缩短依据查找路径并保留核对能力。文章强调权限控制、内容更新机制及“资料不足”时的处理策略,为企业落地RAG提供务实建议。
2026-11-01
0



Python 编程、数据分析、AI应用与自动化开发。
从基础语法到真实项目,在实践中学好。
def hello(name):
    return f"Hello, {name}!"

for name in ["Python", "Data", "AI"]:
    print(hello(name))
# 点击运行代码,进入在线编辑器Hello, Python!
Hello, Data!
Hello, AI!
本文探讨检索增强生成(RAG)在企业知识库与智能客服中的实际应用。通过分析内部制度查询、技术文档检索及客户服务场景,指出RAG的核心价值在于缩短依据查找路径并保留核对能力。文章强调权限控制、内容更新机制及“资料不足”时的处理策略,为企业落地RAG提供务实建议。
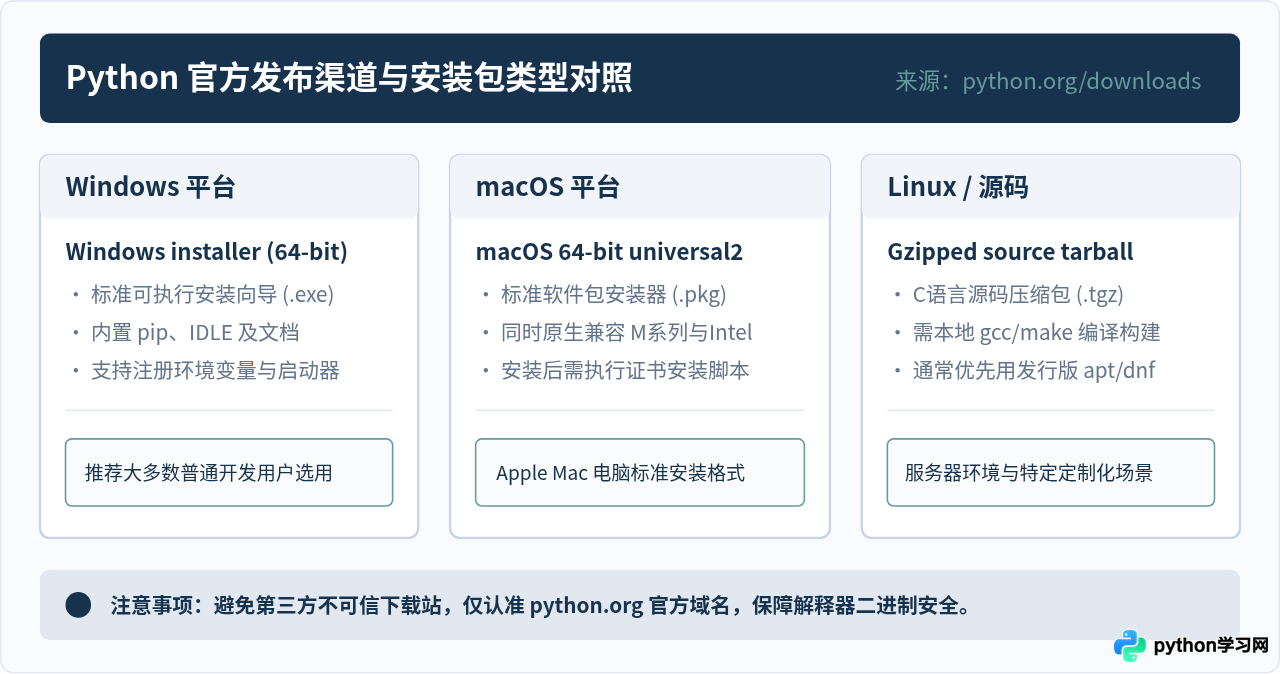
详细介绍从Python官网下载与安装官方Python解释器环境的标准流程,包括Windows与macOS平台的安装配置、环境变量PATH设置及安装验证方法。
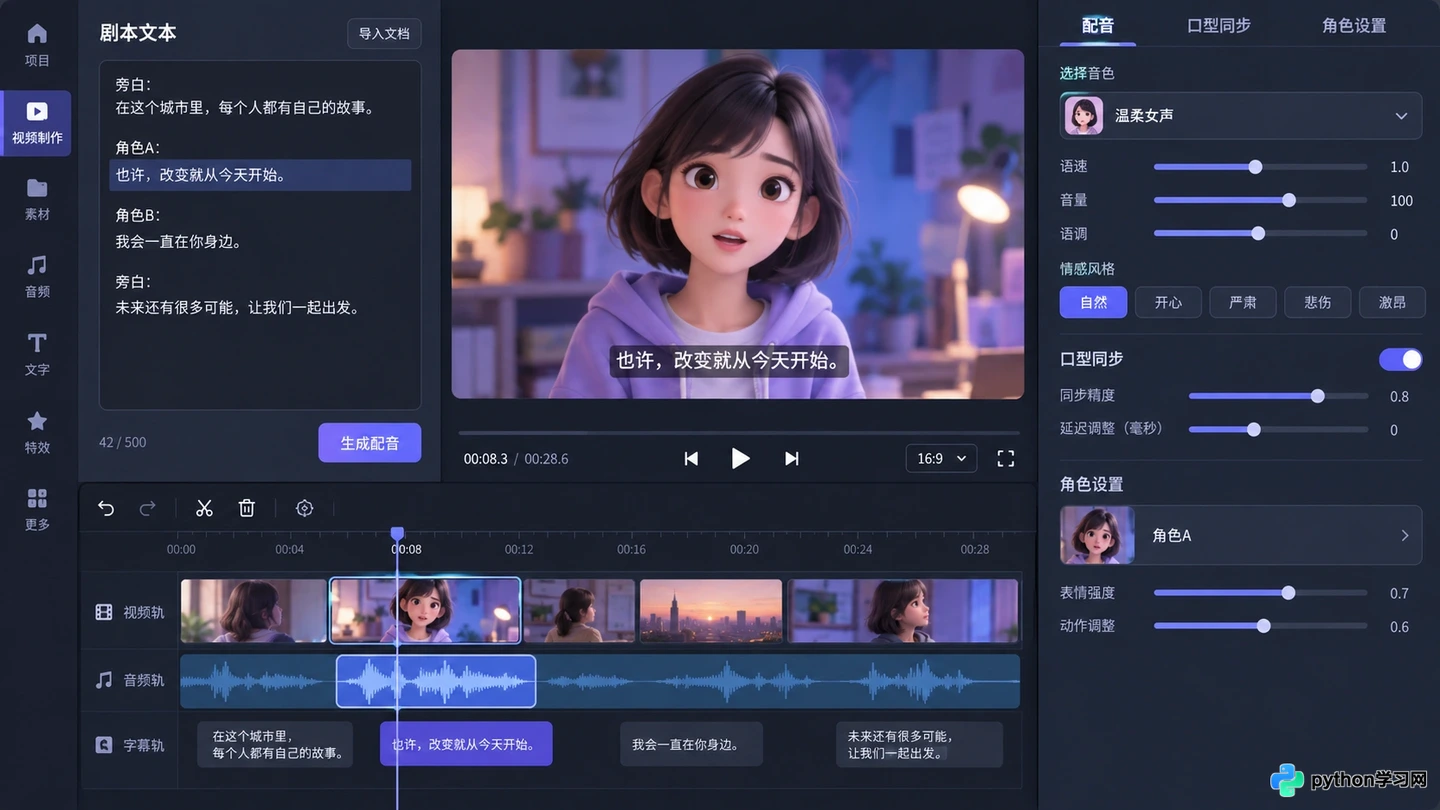
本文介绍在AI短剧制作中,如何通过优化配音文本、调整语速节奏以及利用后期工具微调,解决数字人声音与口型不匹配的问题,提升视频的自然度和观看体验。
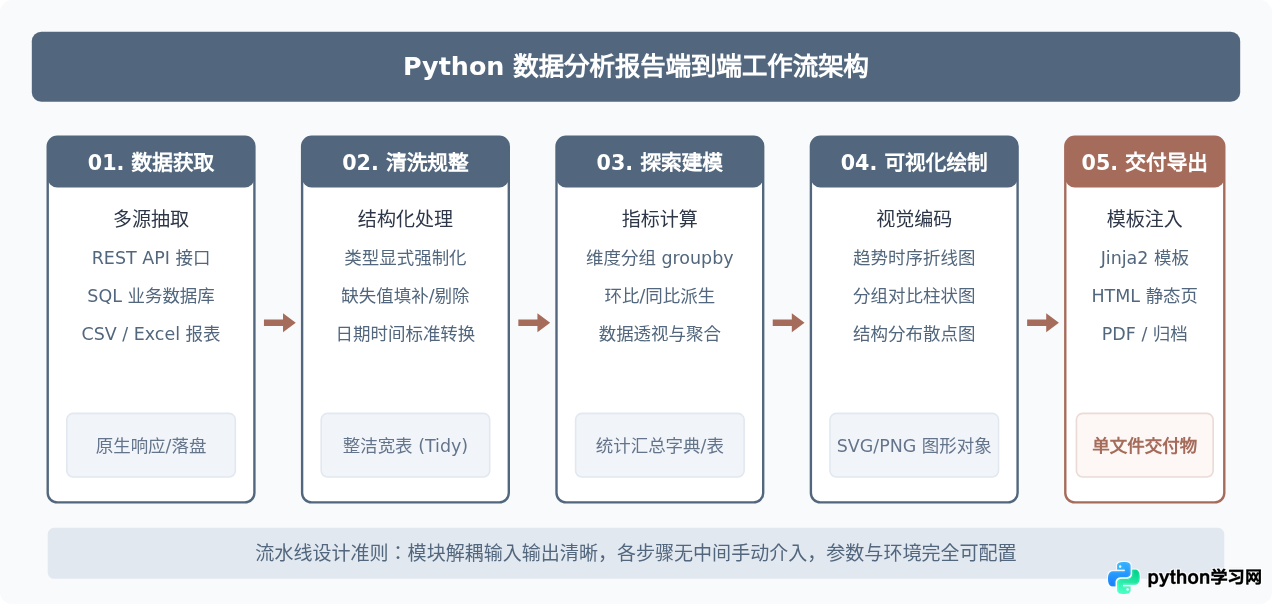
本文系统拆解基于Python的数据分析报告工程化工作流,涵盖多源数据获取、链式清洗规整、探索性指标建模、多维可视化呈现以及Jinja2自动化报告输出的全流程实操与注意事项。
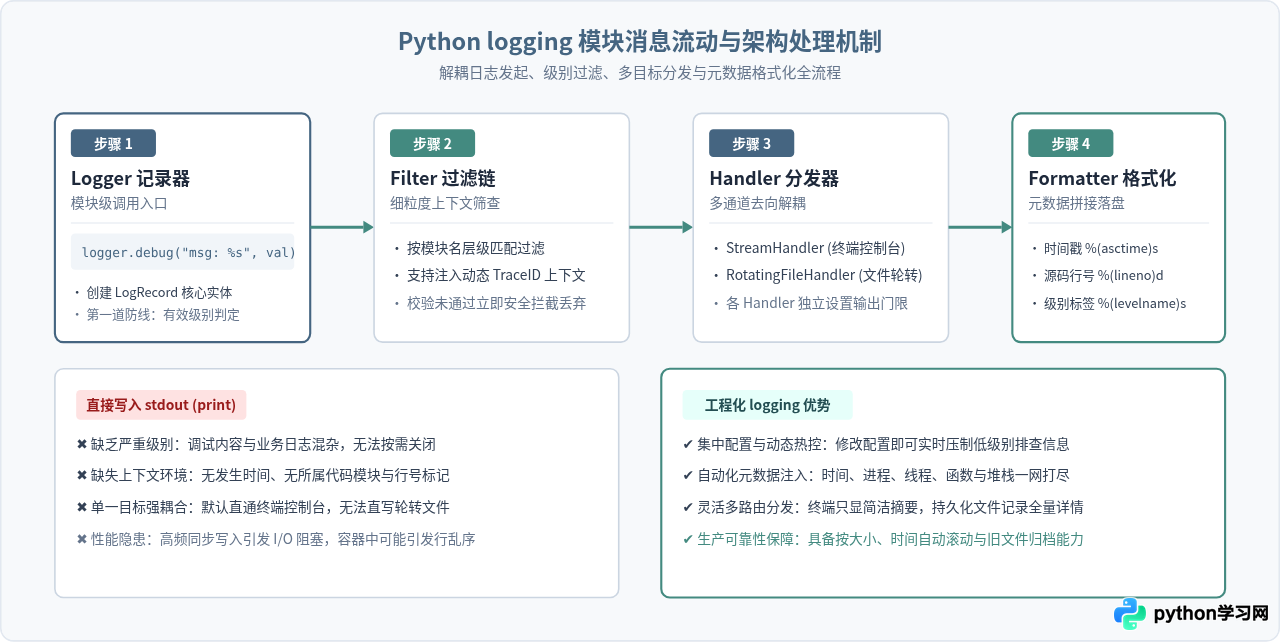
深入解析Python调试中print打印变量与logging日志记录的核心区别、适用场景及最佳实践。涵盖运行机制、架构流程、代码示例及生产演进方案。
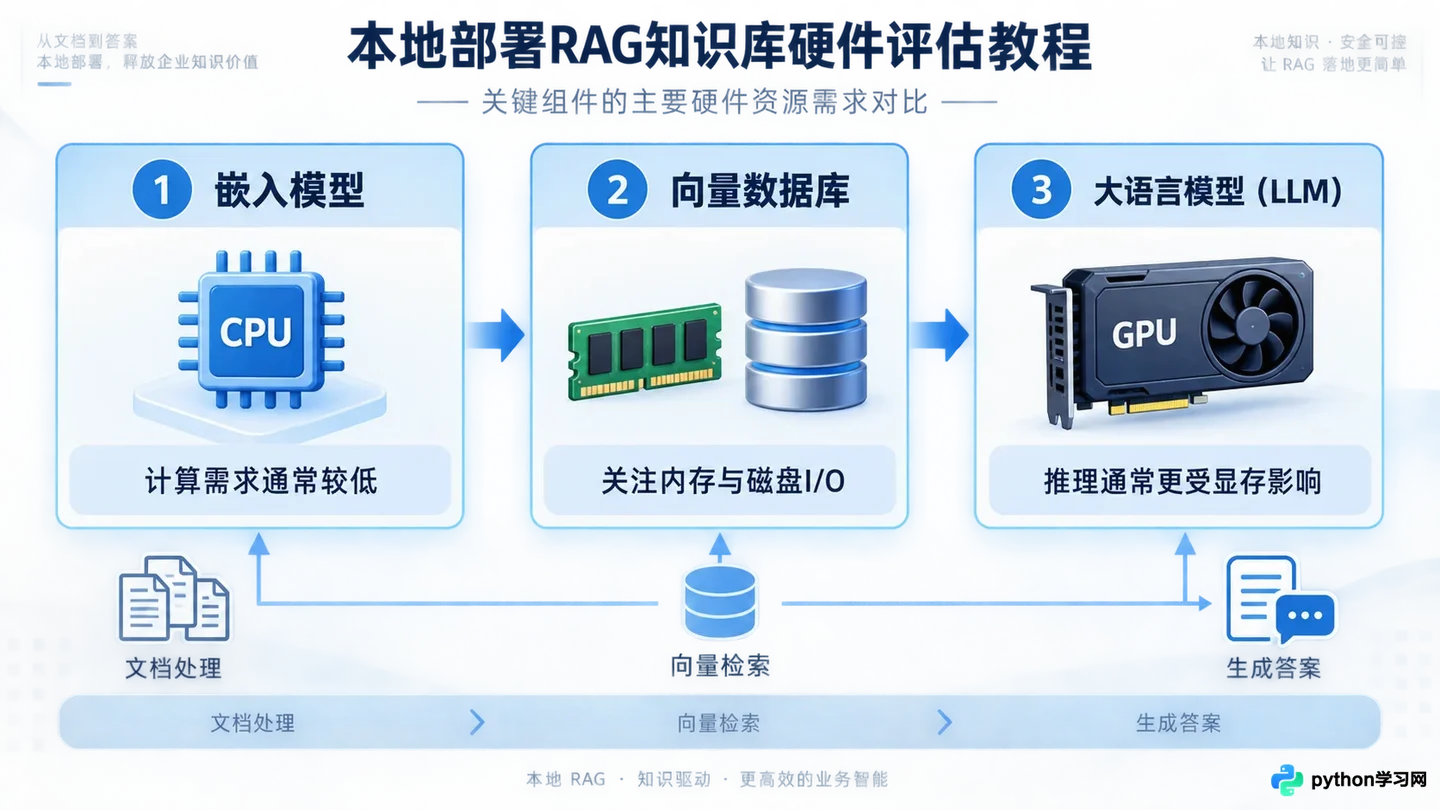
本文针对个人开发者和小团队,拆解本地部署RAG(检索增强生成)系统的真实硬件需求。通过对比纯CPU方案与GPU加速方案,明确嵌入模型、向量数据库和大语言模型各自的资源占用,提供从4GB显存到24GB显存的分级配置建议,帮助读者在预算与性能间找到平衡点。
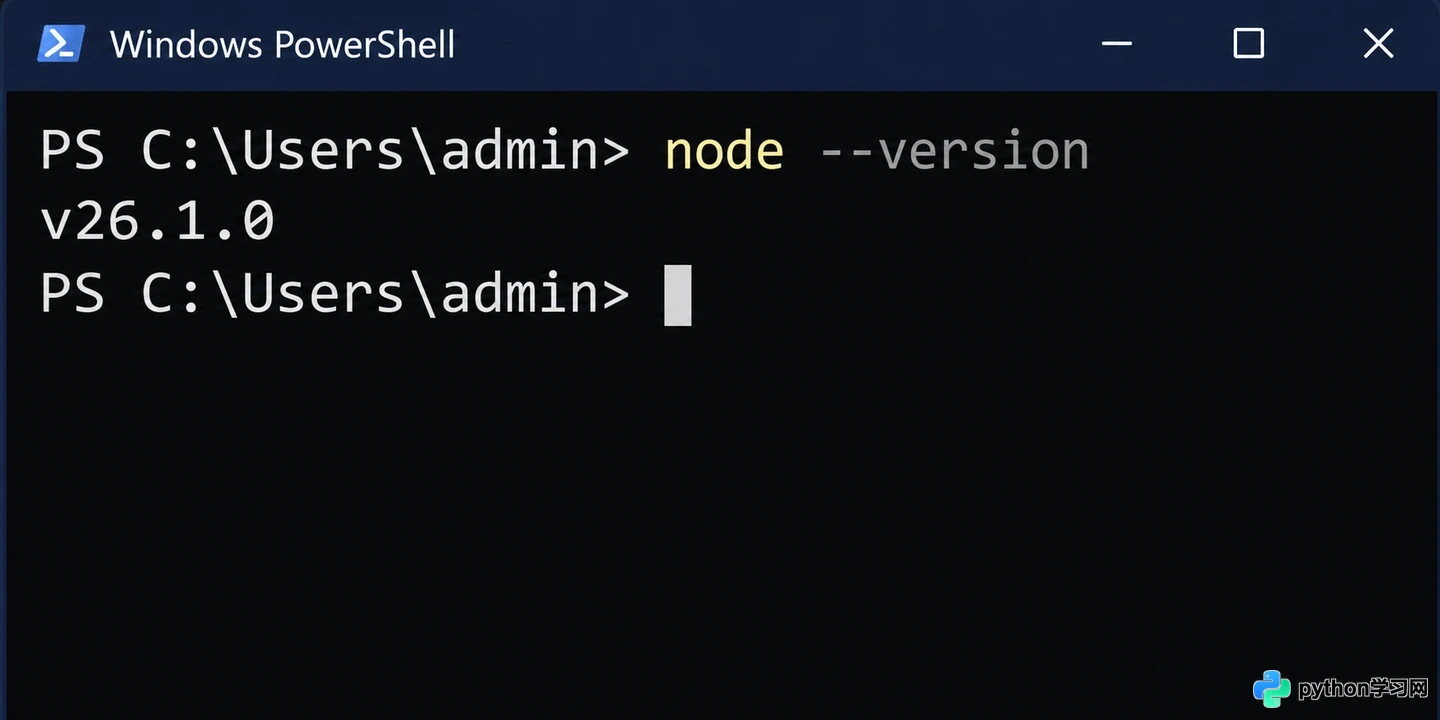
本文详解 OpenClaw 在 Windows、macOS 和 Linux 下的本地部署流程。从 Node.js 版本核对、PowerShell 与 Bash 安装脚本执行,到 Gateway 前台测试与后台服务配置,帮助读者避开环境混淆陷阱,快速跑通本地 AI 助手。
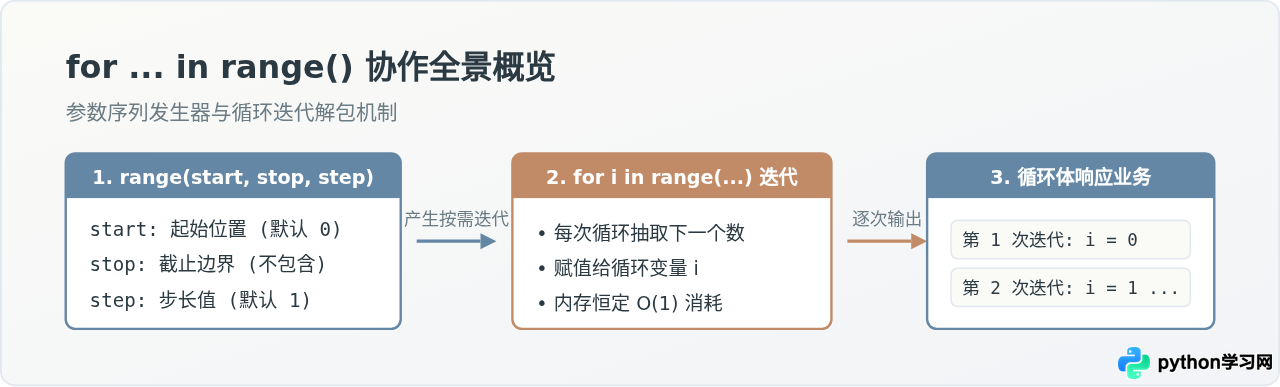
详细讲解在Python中使用range()函数配合for循环生成数字序列的方法,涵盖单参数、双参数、步长设置、反向递减循环、底层原理及常见边界避坑指南。
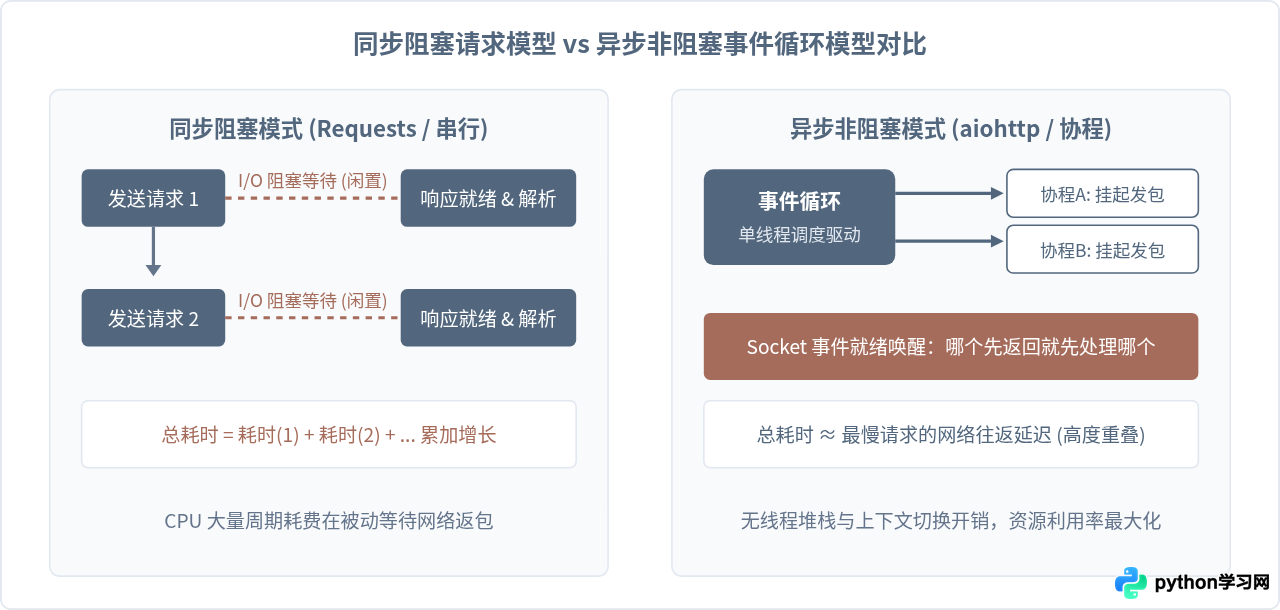
深入讲解如何使用Python的asyncio与aiohttp构建高并发异步爬虫,剖析事件循环原理、ClientSession连接池复用、信号量并发控制及阻塞排查实战方案。