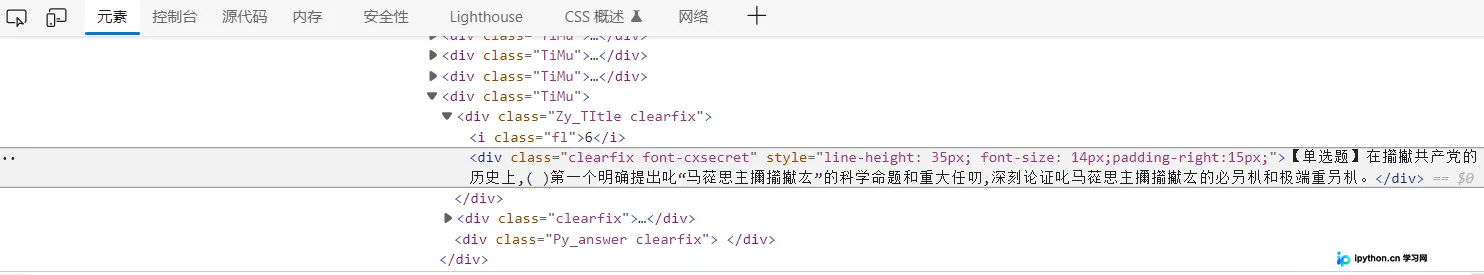
详解超星脚本出现乱码问题的解决方法(Python)
本文详细解析超星学习通脚本运行时的乱码问题。通过对比分析发现,乱码源于繁体与简体编码差异。利用Python的zhconv库进行繁简转换,可有效还原题目内容。文章提供了具体的代码实现及JS脚本修改思路,帮助开发者快速修复脚本异常。
2026-10-15
0



本文详细解析超星学习通脚本运行时的乱码问题。通过对比分析发现,乱码源于繁体与简体编码差异。利用Python的zhconv库进行繁简转换,可有效还原题目内容。文章提供了具体的代码实现及JS脚本修改思路,帮助开发者快速修复脚本异常。
本文详细介绍使用Python实现的简易学生信息管理系统,涵盖录入、查找、修改、删除、排序、统计及显示等核心功能。文章基于Win7和PyCharm环境,演示了完整代码逻辑,并提供了使用PyInstaller将Python脚本打包为独立.exe可执行文件的详细步骤,适合Python初学者参考学习。
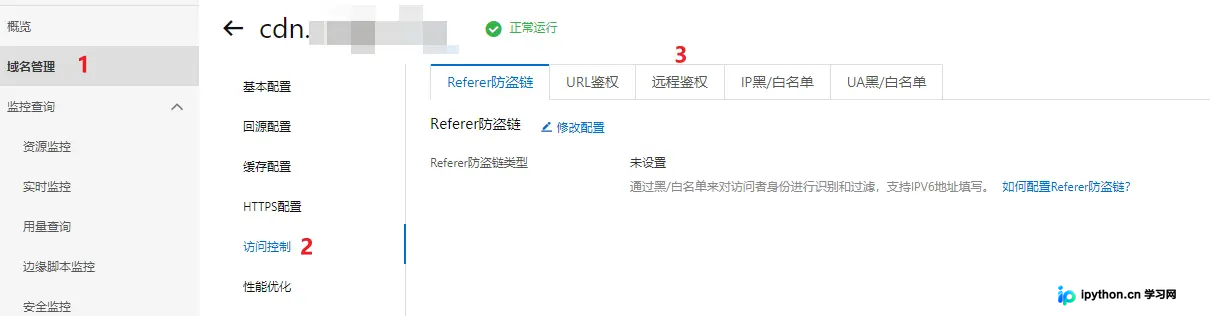
本文介绍如何利用Python Flask搭建远程鉴权服务器,实现CDN资源的精细化访问控制。通过配置CDN控制台开启远程鉴权,指定服务器地址、请求方法及参数,结合Python代码接收请求并记录日志,最终返回200或403状态码以控制资源访问。该方法可替代传统的Referer或IP黑白名单,提供更灵活的权限判定机制。
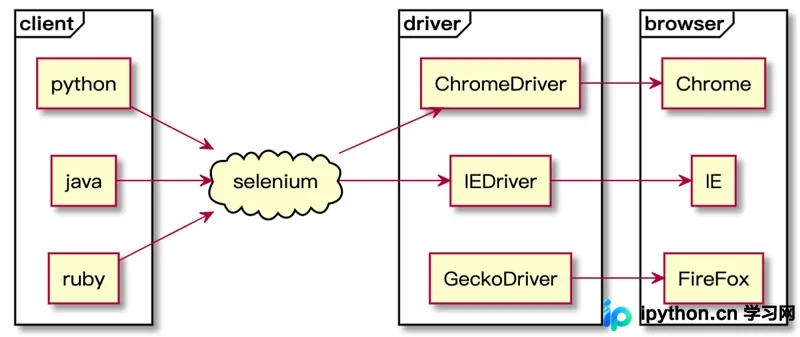
本文介绍如何在Python Selenium自动化测试中指定截图文件名。通过结合time.strftime()生成动态时间字符串,利用WebDriver的get_screenshot_as_file()方法保存页面快照。适用于异常捕获与测试信息存档,支持多浏览器与跨平台环境,提供完整代码示例与时间格式化符号说明。
本文介绍如何利用Python的subprocess模块安全调用外部程序,包括处理返回值、超时机制及捕获输出。同时详解shutil模块在文件复制、移动、目录遍历及归档创建中的高级用法,涵盖符号链接处理、忽略模式及错误处理,为运维自动化提供实用代码示例。
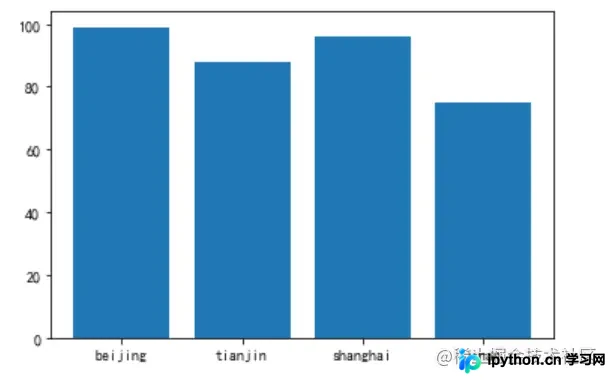
本文详细介绍如何使用Python的Matplotlib库绘制柱状图。重点讲解bar()方法的基本语法及x、height、width等关键参数,并展示如何通过barh()方法实现横向柱状图。包含完整代码示例及参数说明,帮助开发者快速掌握数据可视化基础技巧。
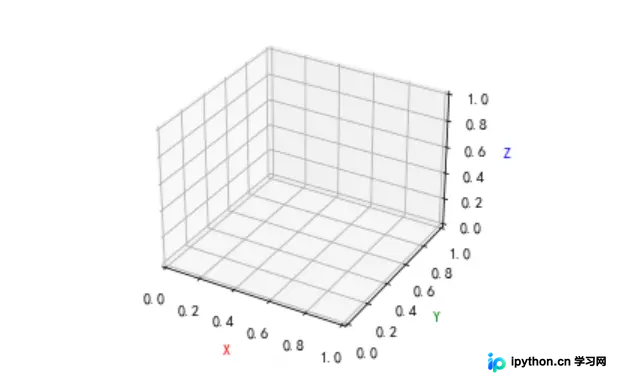
本文介绍如何在Python中使用Matplotlib库绘制3D图形。通过导入mpl_toolkits.mplot3d工具包,利用projection='3d'参数创建三维子图,并设置坐标轴标签。示例展示了plot3D绘制折线图、scatter3D绘制散点图及bar3D绘制柱状图的方法,帮助开发者快速掌握三维数据可视化技巧。
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
本文深入解析Python列表的底层实现,重点阐述PyList_New创建流程与list_dealloc销毁逻辑。通过解析源码揭示列表缓存池(free_list)如何复用PyListObject对象,同时释放底层数组以平衡时间与空间开销。
本文介绍如何使用Python PIL库实现按比例裁剪图片。通过计算目标宽高比,自动确定裁剪区域并保存结果。同时提供Image.resize方法实现图片等比例缩放,保持画面不变形。
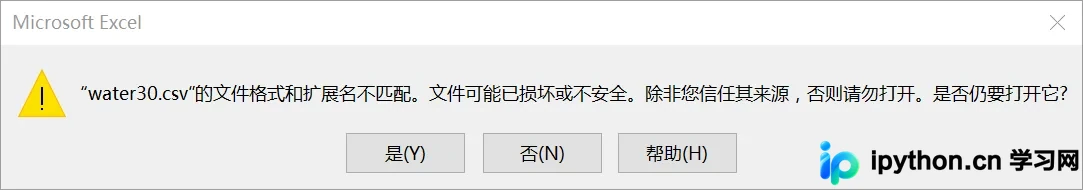
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。