Python Pandas数据分析入门:Series与DataFrame详解
本文详细介绍Python中Pandas库的核心数据结构Series和DataFrame。通过具体代码示例,演示如何利用标量、字典、Ndarray等数据源创建Series,以及如何基于字典、Series和二维数组构建DataFrame,帮助开发者快速掌握Pandas基础操作。
2026-10-16
0



本文详细介绍Python中Pandas库的核心数据结构Series和DataFrame。通过具体代码示例,演示如何利用标量、字典、Ndarray等数据源创建Series,以及如何基于字典、Series和二维数组构建DataFrame,帮助开发者快速掌握Pandas基础操作。
本文详细介绍Python中两种主要的字符串格式化方式:传统的%占位符和更灵活的format方法。内容涵盖%占位符对整数、浮点数、字符及特殊符号的处理,包括对齐方式、精度控制及进制前缀显示;同时解析format方法的三种用法:无位置指定、命名参数及索引指定,帮助开发者掌握高效、规范的字符串输出技巧。
在 SQL Server 中,可以利用内置的 CHARINDEX 函数快速判断一个字符串是否包含特定的单字符或子串。本文介绍了两种实用场景:基于分隔符(如逗号)拆分比对和逐字匹配。通过创建自定义标量函数,可以将这些逻辑封装,以便在复杂的表查询中直接调用,提高数据处理效率。
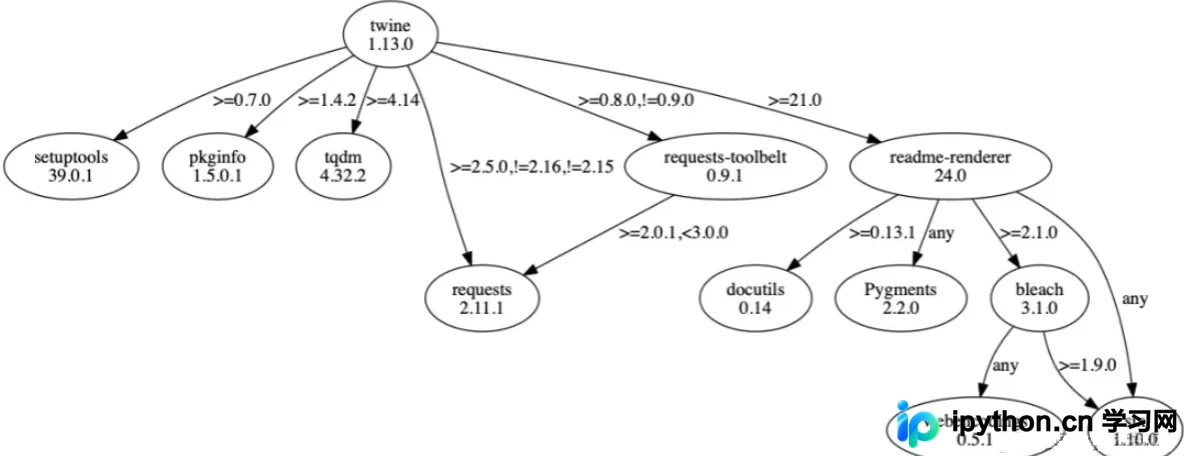
本文介绍如何使用pipdeptree工具可视化Python项目的依赖树。通过对比pip freeze,展示其检测版本冲突和循环依赖的能力,并演示如何生成锁定文件和基于GraphViz的可视化图表,帮助开发者高效清理大型项目的依赖关系。
本文详细介绍 JavaScript 函数的三种常见定义方式(函数声明式、变量赋值式、Function构造函数),解析函数参数传递特性及 return 返回值机制,通过实例演示帮助开发者快速掌握 JS 函数的核心用法。
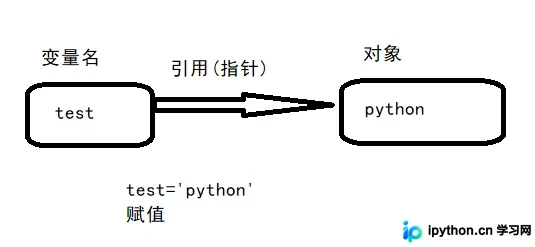
本文详细解析Python中变量赋值、浅拷贝与深拷贝的核心机制。通过对比不可变类型(如字符串)和可变对象(如列表)在三种操作下的内存ID变化,阐明引用传递与对象复制的区别。重点说明浅拷贝仅复制顶层对象而共享嵌套子对象,深拷贝则完全独立复制所有层级元素,帮助开发者避免常见的内存引用错误。
本文详细介绍如何使用Python通过pymongo库操作MongoDB数据库。内容涵盖从环境配置到实际代码实现,包括插入单个或批量文档、指定ID插入、查询单条或所有数据、按条件及修饰符筛选、限制返回数量、修改记录、排序结果以及删除文档和集合的完整操作流程。
本文详解如何利用Python将Excel中的经销商名单批量转换为带有个人专属水印的PDF文件。通过Reportlab生成带透明度的旋转文字水印PDF,再使用Pikepdf将水印图层叠加至目标价目表,实现防泄露追踪。文章提供完整代码逻辑与参数配置说明,适合初学者学习模块化编程思路。
本文深入解析Python中列表、字符串和元组的索引与切片机制。详细讲解索引从0开始的规则、切片左含右不含的特性,以及如何通过index()查找元素。重点对比pop()与del()在删除元素时的返回值差异及边界报错处理,并探讨元组索引的特殊性,帮助开发者掌握高效的数据访问技巧。
本文详细解析Python中函数的定义、参数传递(默认值与可变参数)、模块管理机制以及变量作用域规则。通过具体代码示例,讲解如何利用import和from...import避免命名冲突,使用__main__保护执行代码,以及通过global关键字修改全局变量,帮助开发者掌握Python函数式编程的核心实践。
本文深入解析Python中super()函数的执行机制,重点探讨多继承场景下的方法解析顺序(MRO)。通过三个典型案例,展示如何因调用super()时未指定类参数导致AttributeError,以及如何通过super(类名, self)精确控制搜索起点。文章结合Person3与D类的继承结构,详细演示了__mro__属性在确定父类调用路径中的核心作用,帮助开发者避免多继承中的常见陷阱。
本文详细解析numpy中reshape(-1,1)与reshape(1,-1)的具体用法。通过多个代码示例,说明当指定新数组shape为-1时,Numpy如何根据剩余维度自动计算。重点区分单特征数据使用reshape(-1,1)转为列向量,以及单样本数据使用reshape(1,-1)转为行向量的场景,帮助开发者准确处理数据维度。



