Python Pandas数据排序实战:索引、列名与数值排序全解析
本文详细介绍Python中Pandas库的两种核心排序方法:sort_index用于按索引或列名排序,sort_values用于按数值大小排序。涵盖单列与多列排序、升降序控制、inplace参数应用及缺失值处理策略,帮助开发者高效完成数据整理任务。
2026-10-16
0



本文详细介绍Python中Pandas库的两种核心排序方法:sort_index用于按索引或列名排序,sort_values用于按数值大小排序。涵盖单列与多列排序、升降序控制、inplace参数应用及缺失值处理策略,帮助开发者高效完成数据整理任务。
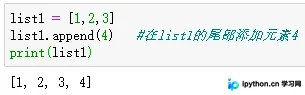
本文详细介绍Python中list append方法的使用。append函数用于在列表末尾添加新对象,无返回值但会修改原列表。文章通过整数、浮点数、字符串、列表、元组、字典及空元素等示例展示具体用法,并强调object参数不可省略。此外,对比了append、extend、insert及“+”号四种添加元素的方式及其区别。
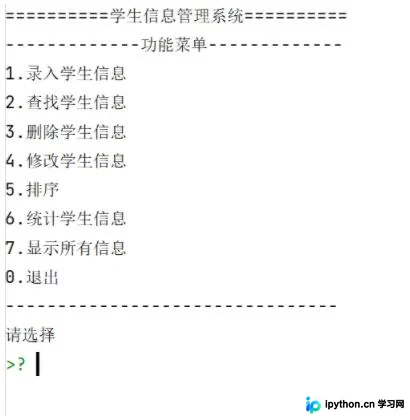
本文介绍使用Python实现的学生信息管理系统,支持学生信息的录入、查找、删除、修改以及全部信息显示。系统还具备按总成绩进行学生成绩排名的功能,数据持久化存储于txt文件。通过主菜单循环调用各功能模块,适合Python初学者理解文件操作与逻辑控制。
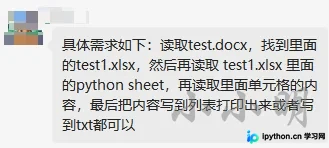
本文详解在Python中读取Word文档内嵌Excel文件的两种方案。第一种利用Windows COM接口调用宏,依赖Office或WPS环境;第二种通过解析Word ZIP结构中的OLE二进制文件,结合olefile与openpyxl实现跨平台快速读取。
本文详细介绍使用Python实现的简易学生信息管理系统,涵盖录入、查找、修改、删除、排序、统计及显示等核心功能。文章基于Win7和PyCharm环境,演示了完整代码逻辑,并提供了使用PyInstaller将Python脚本打包为独立.exe可执行文件的详细步骤,适合Python初学者参考学习。
本文详解如何在Flask框架中集成flasgger库,自动生成符合OpenAPI规范的在线接口文档。通过Python代码与YAML配置文件的配合,实现复杂JSON参数的自动解析与可视化展示。文章提供了从环境安装、代码编写到在线调试的完整流程,帮助开发者提升前后端协作效率,无需手动维护文档即可实现接口的实时同步与在线测试。
本文详细解析Python中六个高频使用的内置函数:Map用于高效转换可迭代对象,Lambda创建匿名函数简化逻辑,Enumerate辅助索引遍历,Reduce执行累积运算,Filter精准过滤数据,以及Zip合并多个列表。通过具体代码示例展示如何简化编程工作,提升代码运行速度与内存效率,帮助开发者掌握Python数据处理的核心技巧。
本文总结了6个常用的Pandas数据处理技巧,帮助开发者高效处理数据。内容涵盖快速定位含缺失值的行、根据条件替换列值、使用pd.cut进行数据分箱统计、利用split拆分文本列、通过正则表达式筛选中文字段,以及调整列顺序的两种方法。掌握这些代码片段能显著提升数据清洗与处理的效率。
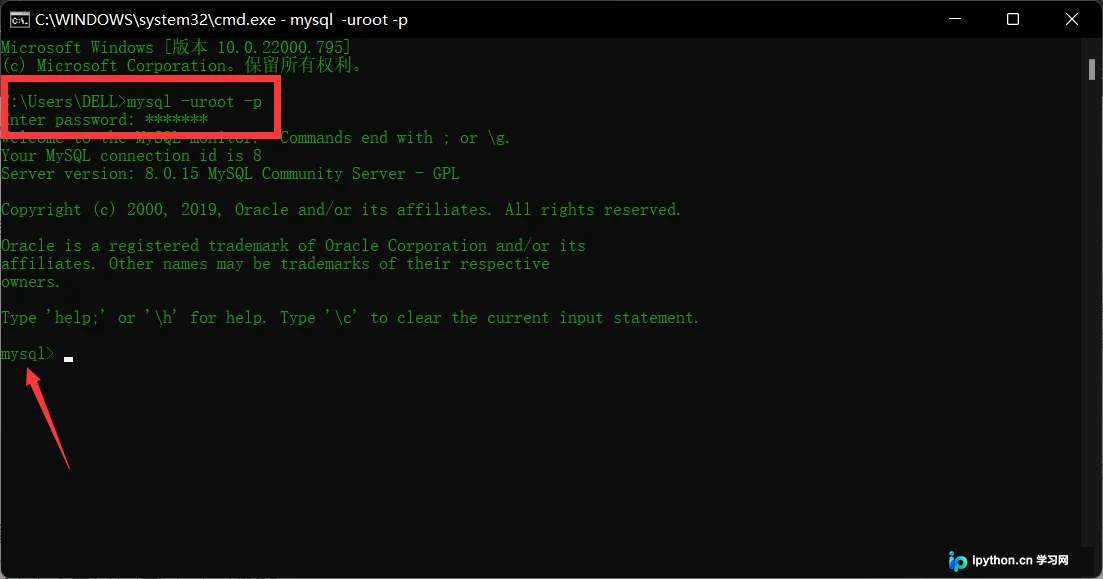
当使用 MySQL 8.0 并连接 IntelliJ IDEA 数据库插件或 Spring Boot 项目时,常出现 unrecognized server time zone value 错误。原因是数据库时区与客户端不匹配。本文介绍两种解决方案:一是通过命令行临时修改全局时区;二是永久修改 my.ini 配置文件并重新设置 JDBC URL 中的 serverTimezone 参数,彻底解决乱码报错。
本文系统介绍JavaScript的组成结构(ECMAScript、DOM、BOM)、三种代码书写形式及注释规范。深入解析变量声明(let/var)、动态类型特性、五大基本数据类型(Number、String、Boolean、Undefined、Null)及其运算规则,并梳理算术、比较(==与===区别)、逻辑等常用运算符,帮助初学者快速掌握JS入门核心知识。