Python中常见的5种爬虫框架解读
本文深入解析Python中五种常见的爬虫框架,包括成熟的Scrapy、高效的Crawley、可视化的Portia、轻量级的Newspaper以及文章提取工具Python-goose。详细对比各框架的功能特点、适用场景及技术优势,帮助开发者根据需求选择合适的爬虫解决方案。
2026-10-16
0



本文深入解析Python中五种常见的爬虫框架,包括成熟的Scrapy、高效的Crawley、可视化的Portia、轻量级的Newspaper以及文章提取工具Python-goose。详细对比各框架的功能特点、适用场景及技术优势,帮助开发者根据需求选择合适的爬虫解决方案。
本文解析Python中Tuple(元组)的命名渊源,追溯至数学中的n-tuple概念。Tuple代表大小固定且元素有序的序列,其命名源自英语中表示倍数的后缀,如couple、triple等。理解这一背景有助于掌握元组不可变且有序的特性,区分其与列表的差异,并深入理解Python数据结构的设计逻辑。
Go标准库未内置enum关键字,开发者通常采用“类型别名+const”模式模拟枚举。本文通过季节和文章状态实例,演示如何定义专用类型以阻止无关常量间的有效比较(如Spring != Draft),并探讨隐式转换带来的潜在风险及规避思路。
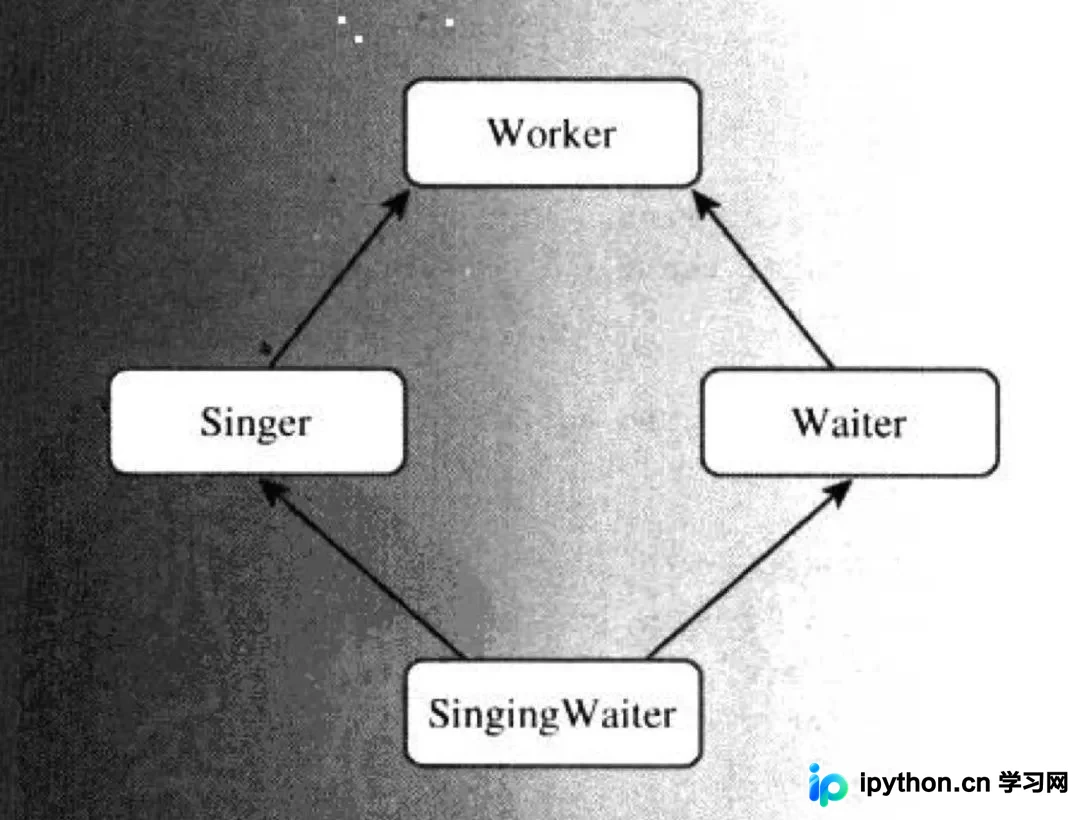
本文深入解析 C++ 多继承机制,探讨其语法规范与常见争议。重点分析当基类存在同名函数时的名称歧义问题,以及经典的“菱形继承”导致的二义性与数据冗余现象,并提供显式调用与虚继承等核心解决方案。
介绍如何在ClickHouse中通过mysql()引擎函数将MySQL表数据全量迁移至本地MergeTree表中。操作需先在MySQL创建具备SELECT和复制权限的专用账户,随后在ClickHouse执行建表语句连接远程库,成功导入后验证数据一致性。
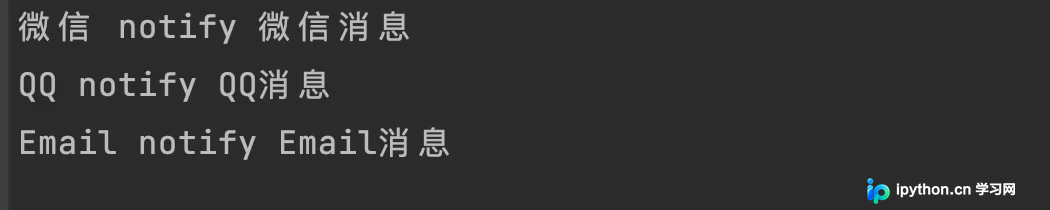
本文解析Go语言中通过接口实现多态的核心机制。通过定义通用接口Notifer并创建不同结构体(如WechatNotifier)实现该接口,展示如何在无需预先指定具体类型的情况下调用差异化方法。文章包含完整的代码示例与运行结果分析,帮助开发者掌握动态绑定与抽象设计的实际应用。
本文介绍了利用Python多线程技术加速GATK变异分析流程的方法。通过将大数据样本按染色体拆分,并行执行HaplotypeCaller生成g.vcf文件,最后使用GATK GatherVcfs工具合并结果。文中提供了具体的Python脚本实现及VCF合并命令示例,旨在提升基因组数据分析效率。
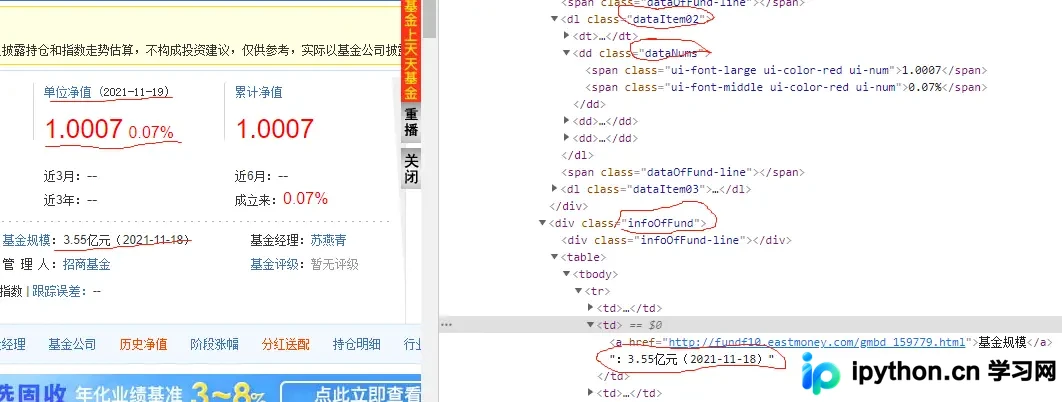
本文详解如何使用Python爬虫获取基金最新交易日的单位净值、涨跌幅及基金规模数据。通过解析HTML标签定位关键信息,并结合pymysql库进行数据库连接配置与SQL操作,实现数据的结构化存储,为后续基金分析与投资决策提供数据支持。
本文介绍了在C#/.NET环境中使用MessagePack进行高效二进制序列化的方法。MessagePack比JSON更紧凑,适合对性能要求较高的场景。通过安装NuGet包并配置[MessagePackObject]和[Key]特性,可以实现快速的数据加密和解密操作,显著提升消息总线和内存缓存等应用的性能表现。
本文深入解析Python中类的私有属性与公共属性。通过双下划线前缀定义私有属性,Python会在内部进行名称改写(Name Mangling)以限制访问。文章展示了直接访问私有属性及子类继承时的异常行为,并对比了单下划线与双下划线的区别,帮助开发者理解Python的封装机制。
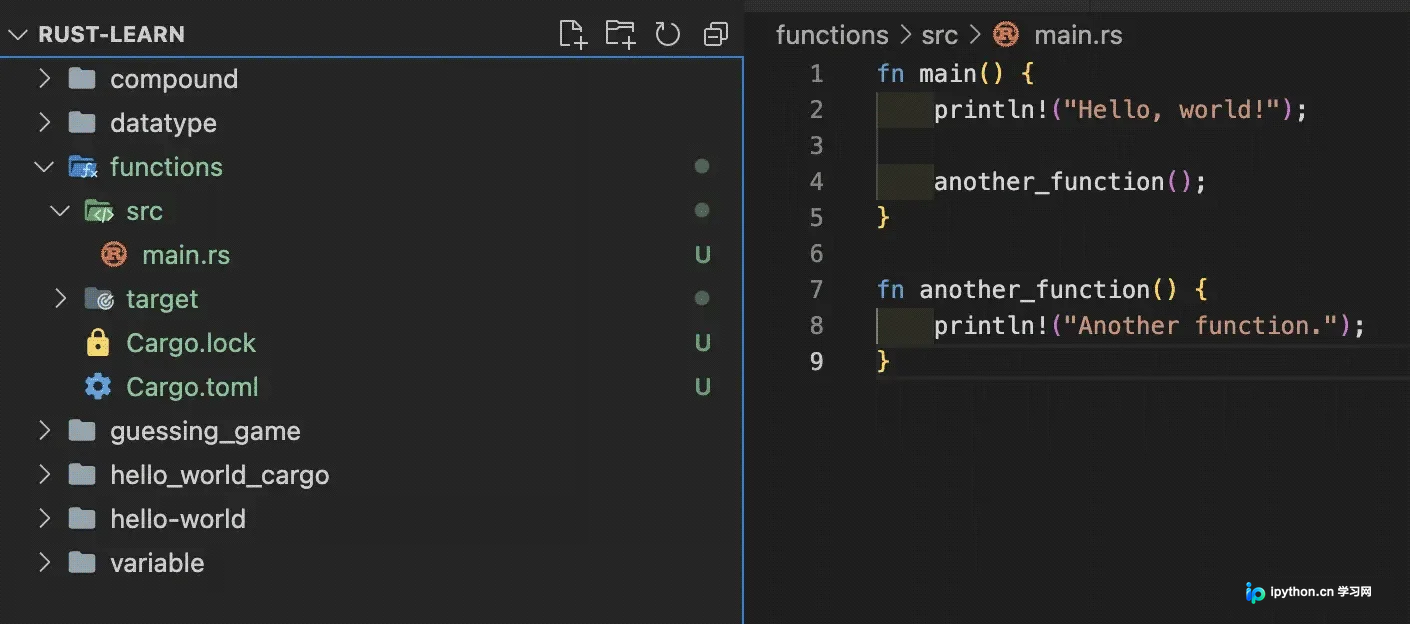
本文讲解Rust中函数的定义规则,强调强制使用冒号指定参数类型的必要性。解析语句与表达式的区别,通过代码说明为何函数体尾部必须避免分号以正确返回结果。最后展示利用Tuple实现多值返回及标准注释编写方法。
本文详解Python 3中bytes与str的核心区别,前者为8位无符号序列,后者为Unicode字符。通过encode和decode方法实现互转,并强调文件读写时mode参数(wb/rb)与encoding设置的重要性,避免类型错误与乱码。



