Python索引与切片核心机制:从基础到NumPy/Pandas实战避坑
本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
2026-10-16
0



本文深入解析Python中的索引与切片机制,涵盖列表、NumPy多维数组及Pandas Series/DataFrame的访问方式。重点剖析一维至N维数组的切片规则、区间差异(闭区间与左闭右开),以及Pandas中ix弃用与iloc/loc的正确用法,结合工程实战中的常见错误与混合数据结构风险,提供完整的避坑指南。
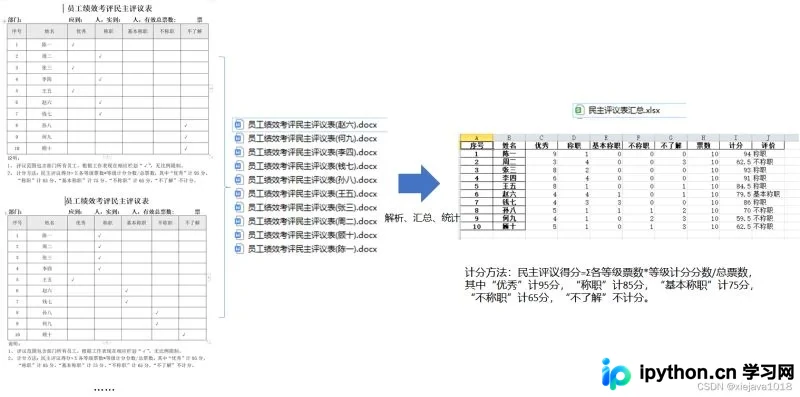
本文介绍利用Python自动化处理年度民主评议表的完整方案。通过docx解析Word文档中的评价表格,使用pandas进行数据汇总与加权计分,最终将结果写入Excel文件。代码不足80行,涵盖从安装依赖、读取目录、解析表格、计算评分到导出文件的全流程,适用于批量处理员工评价数据。
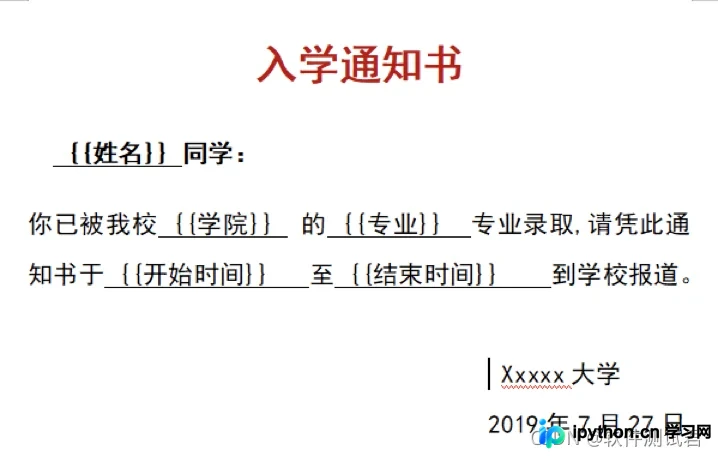
本文介绍如何使用Python的docxtpl和pandas库,通过预设Word模板批量生成包含特定数据的文档。文章详细讲解了环境配置、库安装、CSV数据读取、模板渲染及文件保存的完整流程,并提供了常见错误(如乱码、权限问题)的解决方案,适用于需要处理大量重复性文档生成的场景。
本文详细介绍pandas库中DataFrame.set_index方法的具体使用。涵盖key、drop、append、inplace及verify_integrity等核心参数的含义与配置,通过实例演示如何指定单列或多列作为索引,以及如何构建多级索引和原地修改数据框,帮助开发者高效处理数据索引。
本文介绍在pandas中修改DataFrame列名的两种主要方法:直接重新赋值columns属性和使用rename方法。重点解析rename方法中inplace参数的作用,演示未使用与使用该参数时的结果差异,并展示如何指定修改特定列名。
本文详细介绍如何利用Python的Pandas库高效读写Excel文件。涵盖read_excel函数的核心参数如sheet_name、header、usecols及skiprows的使用方法,演示ExcelFile类对多Sheet的高效读取。同时讲解to_excel写入逻辑,包括自动创建文件、覆盖数据及关闭文件的注意事项,并通过ExcelWriter实现多Sheet一次写入及追加模式操作,提供完整代码示例。
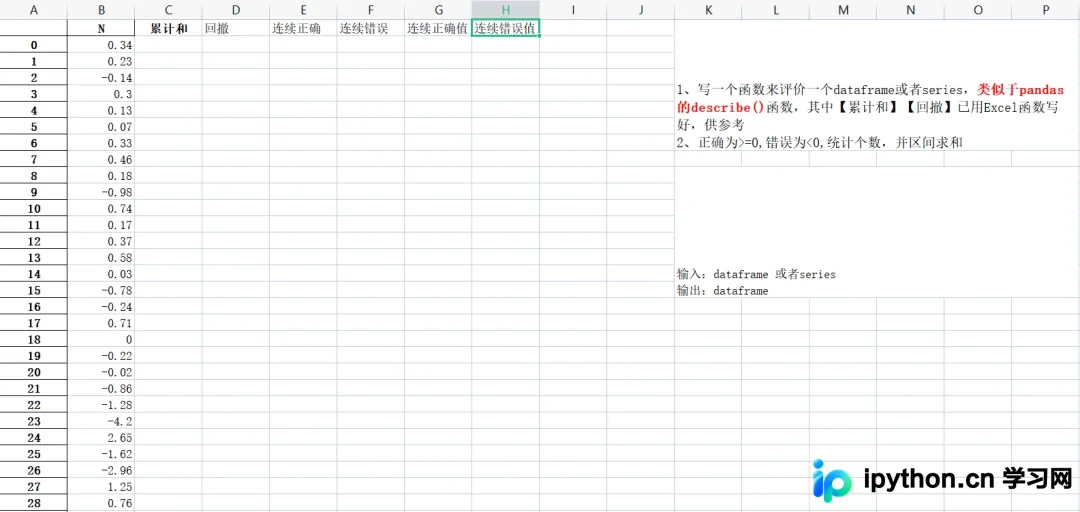
本文介绍如何使用Python和Pandas库,对Excel原始数据进行统计分析。通过基础语法实现累计和、最大回撤、连续正确/错误次数及对应值的计算逻辑,并将结果保存回Excel文件,帮助开发者掌握数据处理的基本流程。
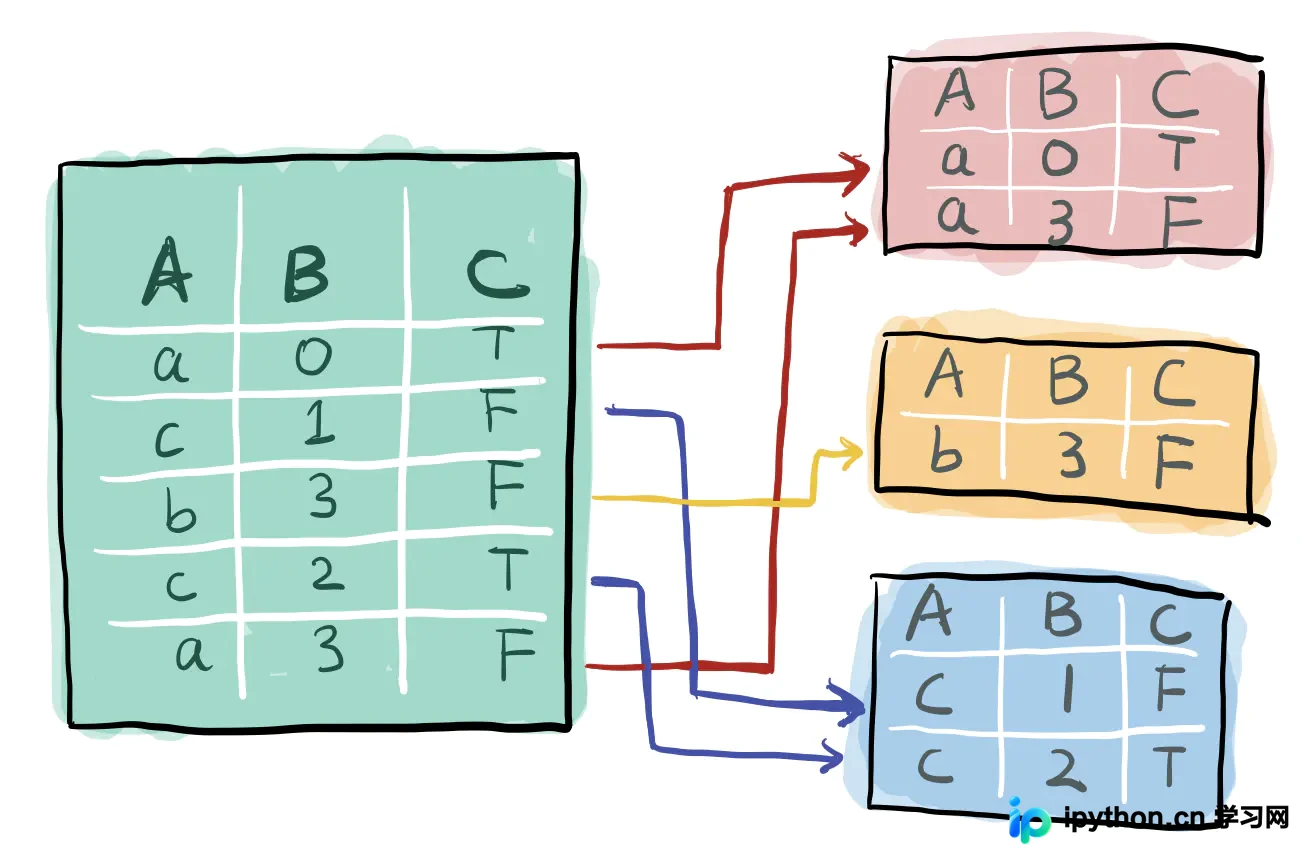
本文深入解析Python Pandas库中groupby函数的核心原理与使用方法。涵盖分组键类型、axis参数设置,详细演示mean、count、size等聚合函数的应用,以及通过agg和apply实现复杂自定义聚合。结合代码实例,讲解多列聚合、字典映射操作及实际数据处理场景,帮助开发者高效掌握数据分组与统计技巧。
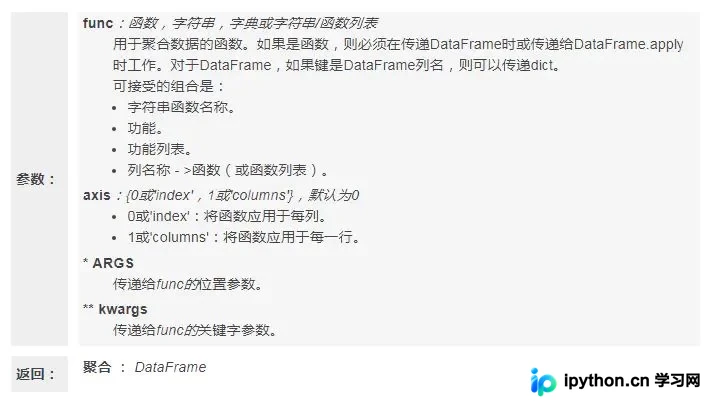
本文详细介绍pandas中DataFrame.agg()聚合函数的使用方法。通过对比numpy聚合函数,解析func参数的多种格式(函数、列表、字典),并演示如何在指定轴上执行单个或不同列的多重聚合操作,包括处理NaN填充的逻辑。
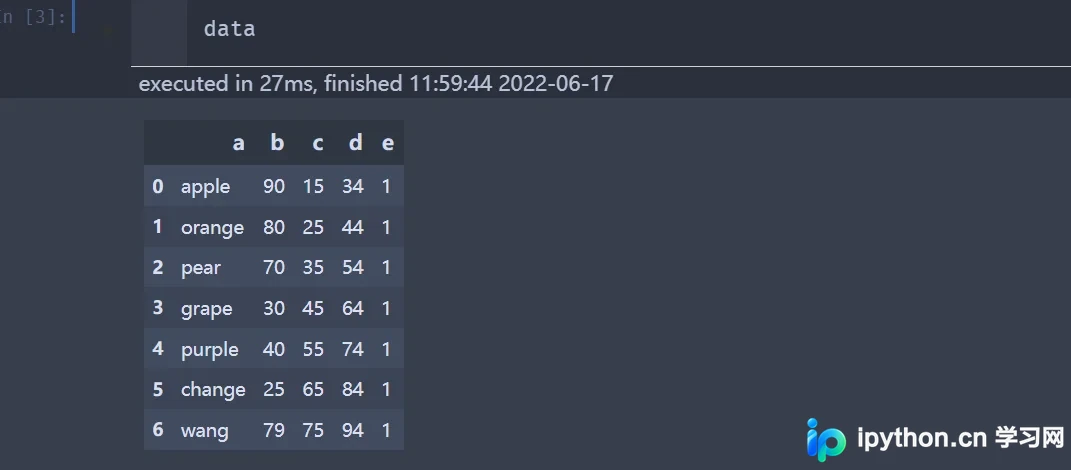
本文详细介绍在pandas DataFrame中批量修改数据的四种常用方法。通过iloc进行行列定位赋值,利用where和mask函数根据条件替换数值,以及使用replace函数处理文本、字典映射及正则表达式。涵盖具体代码示例与参数说明,帮助开发者高效完成数据清洗与预处理任务。
本文介绍如何在Python中使用pandas的groupby函数结合apply和lambda提取每组数据的最大值与最小值。通过异或逻辑筛选极值,并演示如何重置索引及导出Excel,解决直接groupby无法保留完整行的问题。
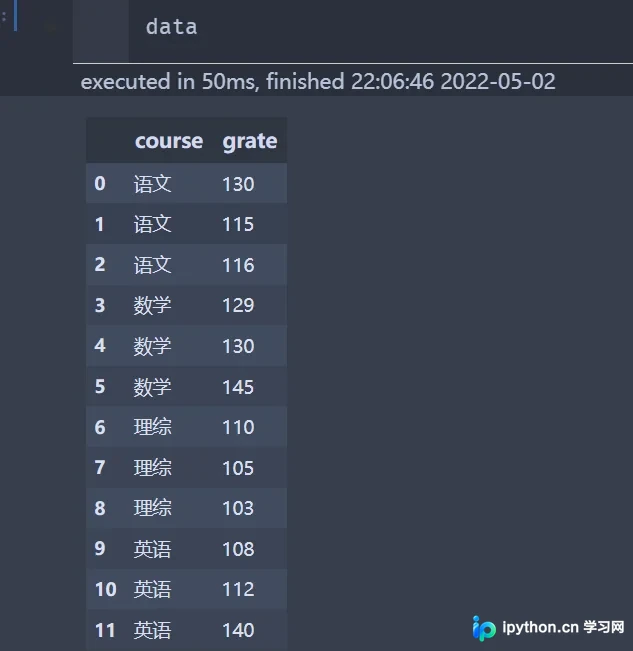
本文详细介绍Pandas中DataFrame.sample()函数的使用方法,涵盖n、frac、replace、weights、random_state等核心参数的配置。通过具体代码示例演示如何按行数、比例或权重进行随机抽样,并解析axis方向控制及结果复现技巧,帮助开发者高效实现数据子集提取。



