
Python深度学习架构优化:残差连接与深度可分离卷积实战
本文总结Python深度学习中的高级架构模式,重点解析残差连接如何解决梯度消失问题,以及深度可分离卷积(SeparableConv2D)在提升训练速度与精度方面的优势。通过Keras代码示例,展示标准化、残差块及轻量级卷积层的实际应用,帮助开发者构建更高效的大规模模型。



本文总结Python深度学习中的高级架构模式,重点解析残差连接如何解决梯度消失问题,以及深度可分离卷积(SeparableConv2D)在提升训练速度与精度方面的优势。通过Keras代码示例,展示标准化、残差块及轻量级卷积层的实际应用,帮助开发者构建更高效的大规模模型。
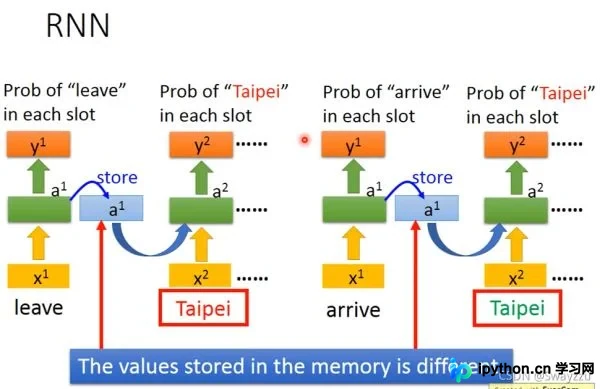
本文详细解析Python中RNN与LSTM模型的核心结构。介绍RNN隐藏层状态传递机制,区分Elman与Jordan网络,并深入讲解LSTM的门控机制(输入门、遗忘门、输出门)及数据流向。通过Python代码示例展示LSTM单元如何控制信息存储与输出,对比其与DNN的参数差异,帮助开发者理解长短期记忆网络的内部流程。
本文介绍Python深度学习框架TensorFlow的基础知识,涵盖张量数据结构、常量与变量定义、占位符用法及计算图原理。通过具体代码示例演示如何创建Session、执行初始化及进行矩阵运算,帮助初学者快速掌握TensorFlow核心操作。
从Python基础与数据处理出发,梳理初学者进入机器学习阶段最值得优先掌握的核心库,明确各库的定位、学习顺序、基本操作与验证方法,避免一开始堆砌过多工具导致学习成本过高。
本文深入解析13个主流Python深度学习库,涵盖Caffe、Theano、TensorFlow、Keras、mxnet等框架。从初学者友好的高层封装到高性能底层实现,详细对比各库在模型构建、分布式训练及特征提取方面的优劣,助你在计算机视觉与模型训练中做出最佳技术选型。
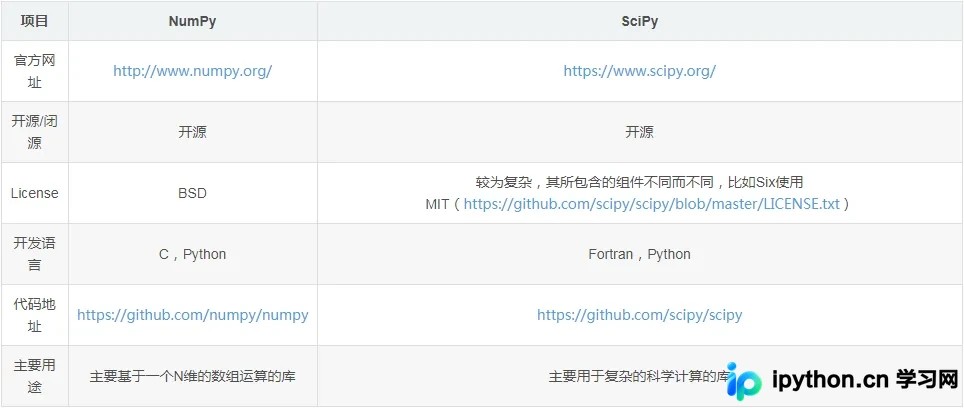
本文详细介绍Python中NumPy库的基础应用,涵盖数组创建、维度转换(ndim/shape)、等差/等比数列生成及初始化方法。作为深度学习的核心计算库,掌握NumPy是理解TensorFlow等框架中张量概念的关键,适合AI初学者入门学习。
大数据开发常面临语言选择难题。Python凭借简洁语法、丰富的数据科学库及胶水语言特性,成为入门首选。相比Java在商业逻辑和底层性能上的优势,Python在快速开发、算法验证及AI生态中表现更佳。本文解析两者差异,助您做出合理选择。
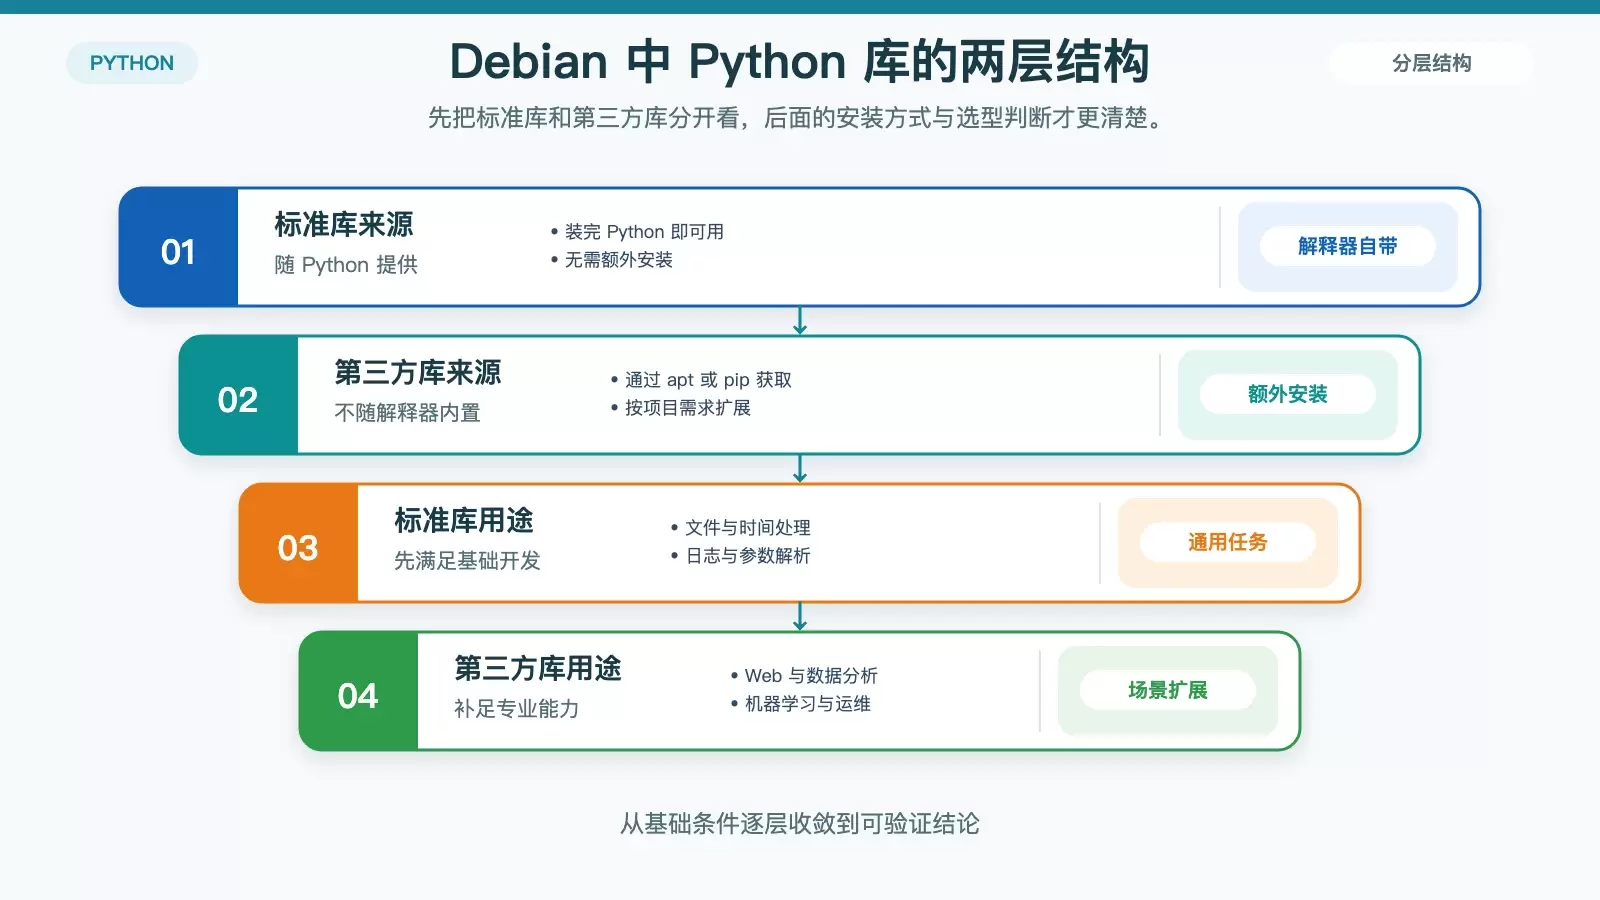
Debian 里的 Python 库大致分为两类:安装 Python 后即可使用的标准库,以及通过 apt 或 pip 额外安装的第三方库。理解两者的边界、适用场景和安装方式,能帮助你在开发、运维和数据处理时更稳妥地选库与管理环境。
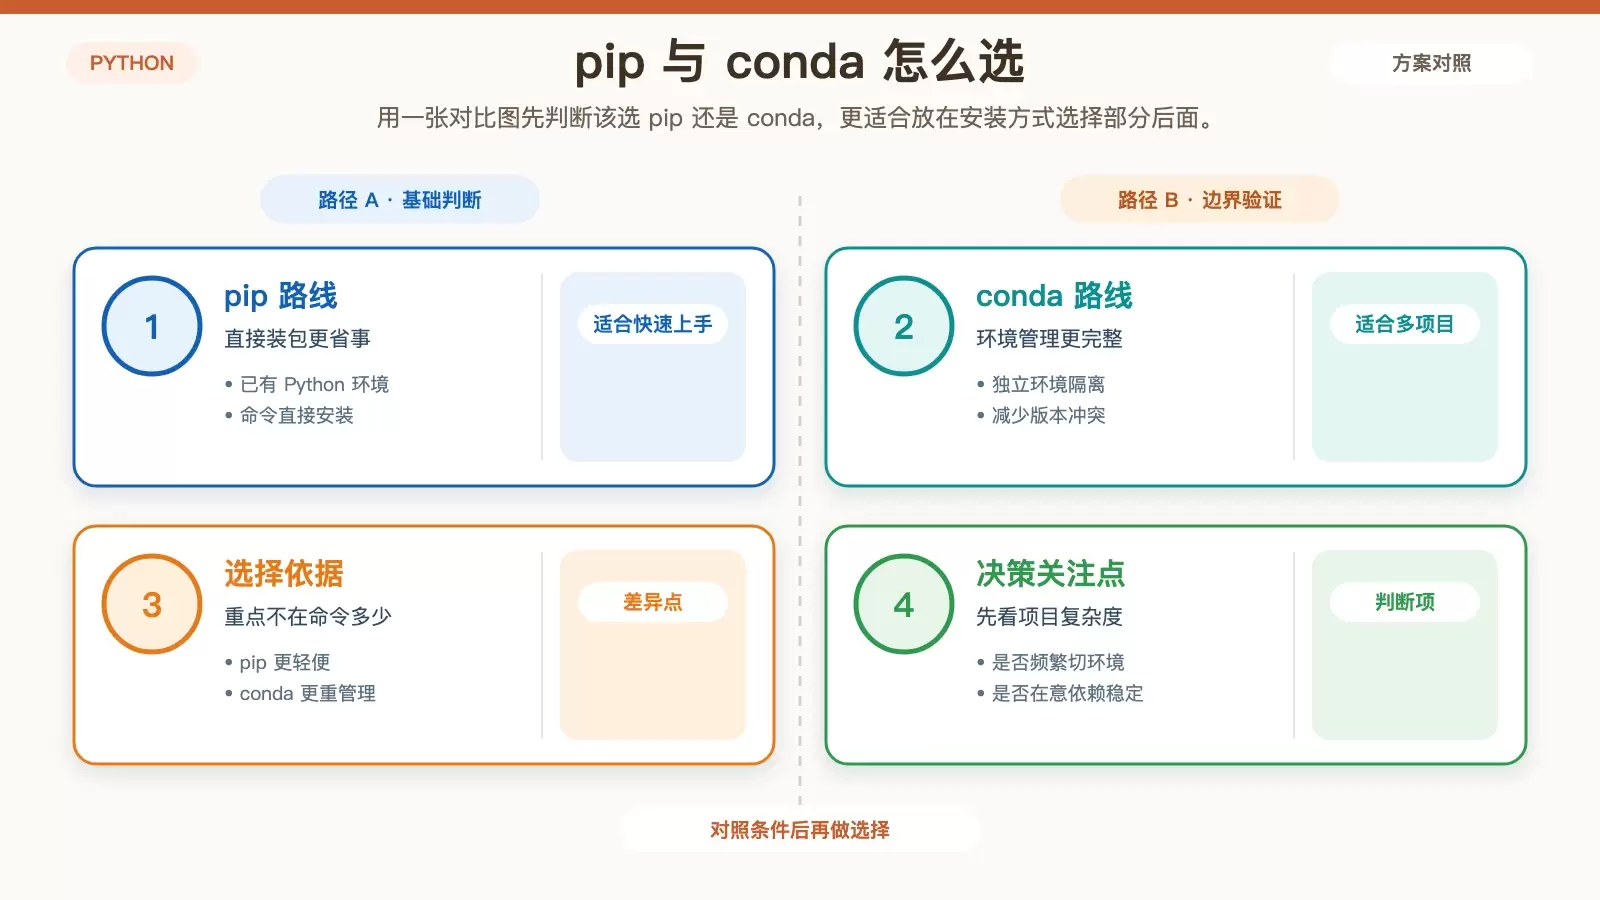
在 Debian 上安装 Python 机器学习库,核心通常就是选 `pip` 还是 `conda`。前者轻便直接,适合已有 Python 环境的用户;后者更强调环境隔离,适合需要控制依赖版本的项目。本文按两条安装路径整理常用命令,并补上 CUDA、权限和基础依赖等关键注意点。
本文详解NumPy中三维数组的元素位置索引规则,通过创建3x5x6数组并赋值示例,解析通道、行、列的下标对应关系。同时深入讲解多维数组axis参数的含义,结合代码演示axis=0,1,2时的求和结果,适用于深度学习特征数据处理场景。
本文详解TensorFlow中实现变量累加的两种方法。由于Python变量引用机制,tf.add仅返回新张量而不修改原变量,适用于无状态计算;而tf.assign_add能原地更新Variable状态,是实现迭代计数器、学习率调度等需要累积状态场景的正确选择。
本文介绍如何使用Python的xml.dom.minidom模块读取XML格式的深度学习标注数据,并提取图片文件名及目标对象的边界框坐标,最终写入TXT文件。通过具体代码示例,展示了从解析XML树结构到格式化输出坐标信息的完整流程,适用于统一不同格式标注数据的场景。



