



CentOS 上的 Java 应用一旦跑久、并发一上来,性能问题通常不会只出在某一个点:可能是系统层资源被无用服务占掉,也可能是 JVM 堆设置、GC 策略、锁竞争或 I/O 模型拖慢了整体吞吐。这篇文章按“系统层、JVM、代码、资源与启动”几个层面拆开讲,保留可直接落地的参数、命令和工具,帮助你判断哪些改动适合当前业务负载,哪些设置需要先压测再上线。
系统层先打底:把 CentOS 资源留给 Java 进程
Java 应用跑得慢,第一步通常不是急着改 GC,而是先确认操作系统本身有没有在无谓消耗 CPU、内存和 I/O。
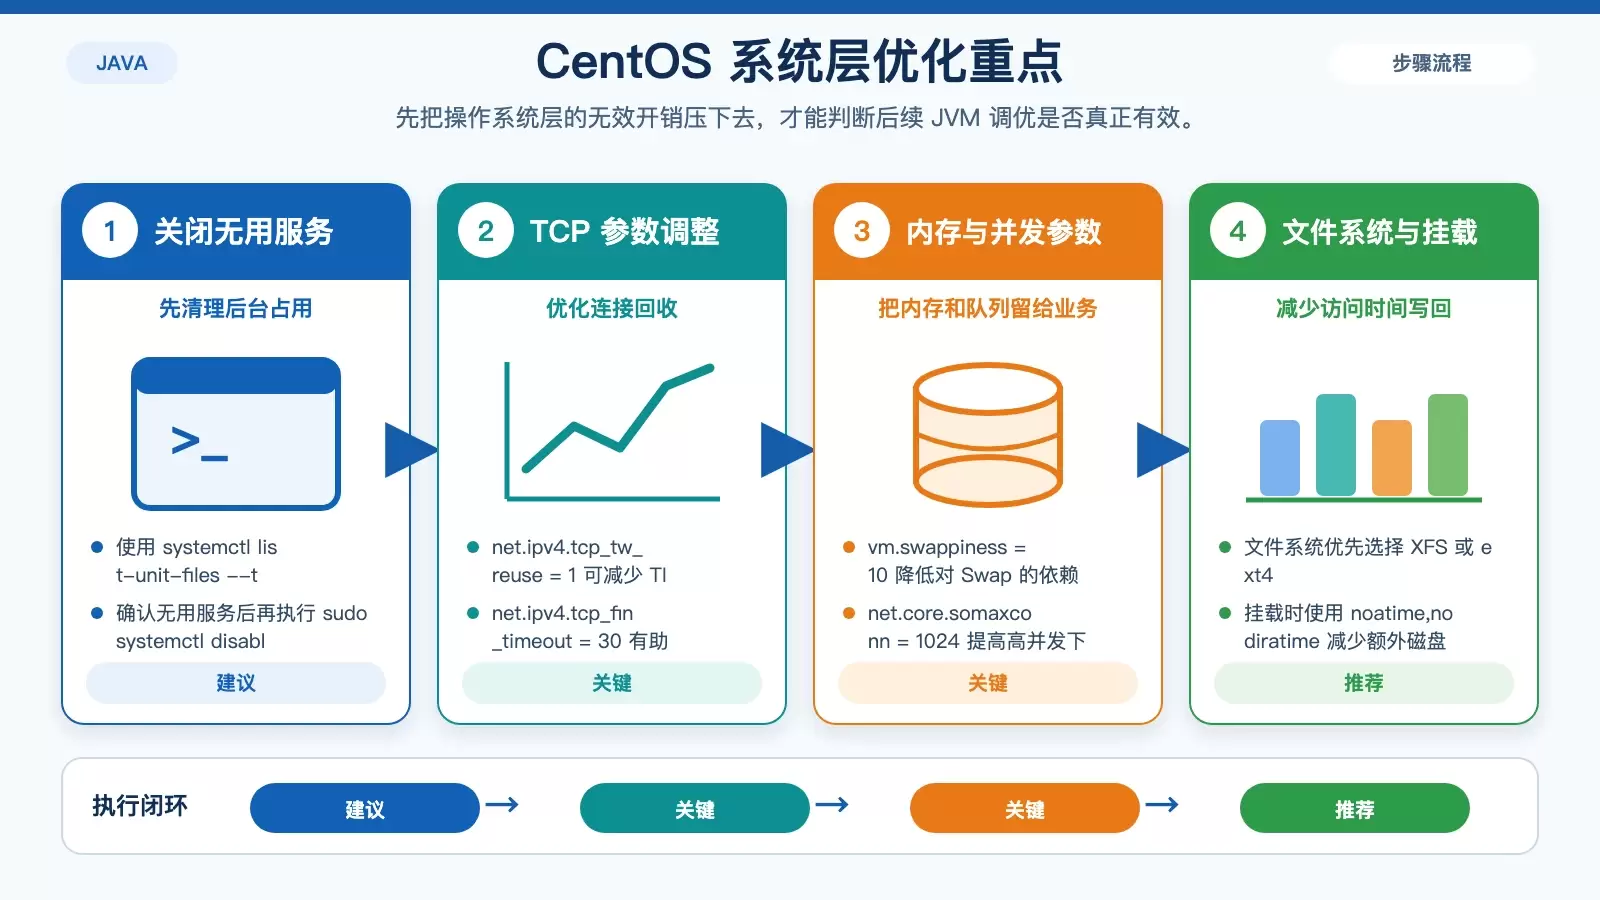
关闭不必要的开机自启服务
很多服务器默认启用了不少当前业务用不到的服务,它们会长期占用系统资源。可以先用下面的命令做一次盘点:
systemctl list-unit-files --type=services确认后,把不需要的服务禁用:
sudo systemctl disable这类调整虽然简单,但往往能立刻减少后台资源争用,尤其适合部署了单一 Java 业务的主机。
调整内核参数,减少连接和内存层面的额外损耗
网络连接多、并发高的场景下,/etc/sysctl.conf 里的几个参数值得优先检查:
net.ipv4.tcp_tw_reuse = 1:重用 TIME-WAIT 连接,减少连接建立开销。net.ipv4.tcp_fin_timeout = 30:缩短 FIN_WAIT2 超时时间,更快释放端口资源。vm.swappiness = 10:降低系统对 Swap 的依赖,尽量把内存留给应用。net.core.somaxconn = 1024:提高 TCP 连接队列长度,适合高并发入口服务。
修改完成后,执行:
sudo sysctl -p这样配置才会立即生效。
文件系统和挂载选项也会影响 I/O 表现
如果业务有大量日志写入或频繁文件访问,文件系统选择和挂载参数同样重要。文中给出的建议是优先使用 XFS 或 ext4,并在挂载时加上 noatime,nodiratime,以减少访问时间更新带来的额外磁盘 I/O。
JVM 调优:先稳住堆内存,再处理 GC 停顿
系统资源准备好之后,下一层就是 JVM。本质上,这一部分要解决两个问题:内存是否稳定、垃圾回收是否可控。
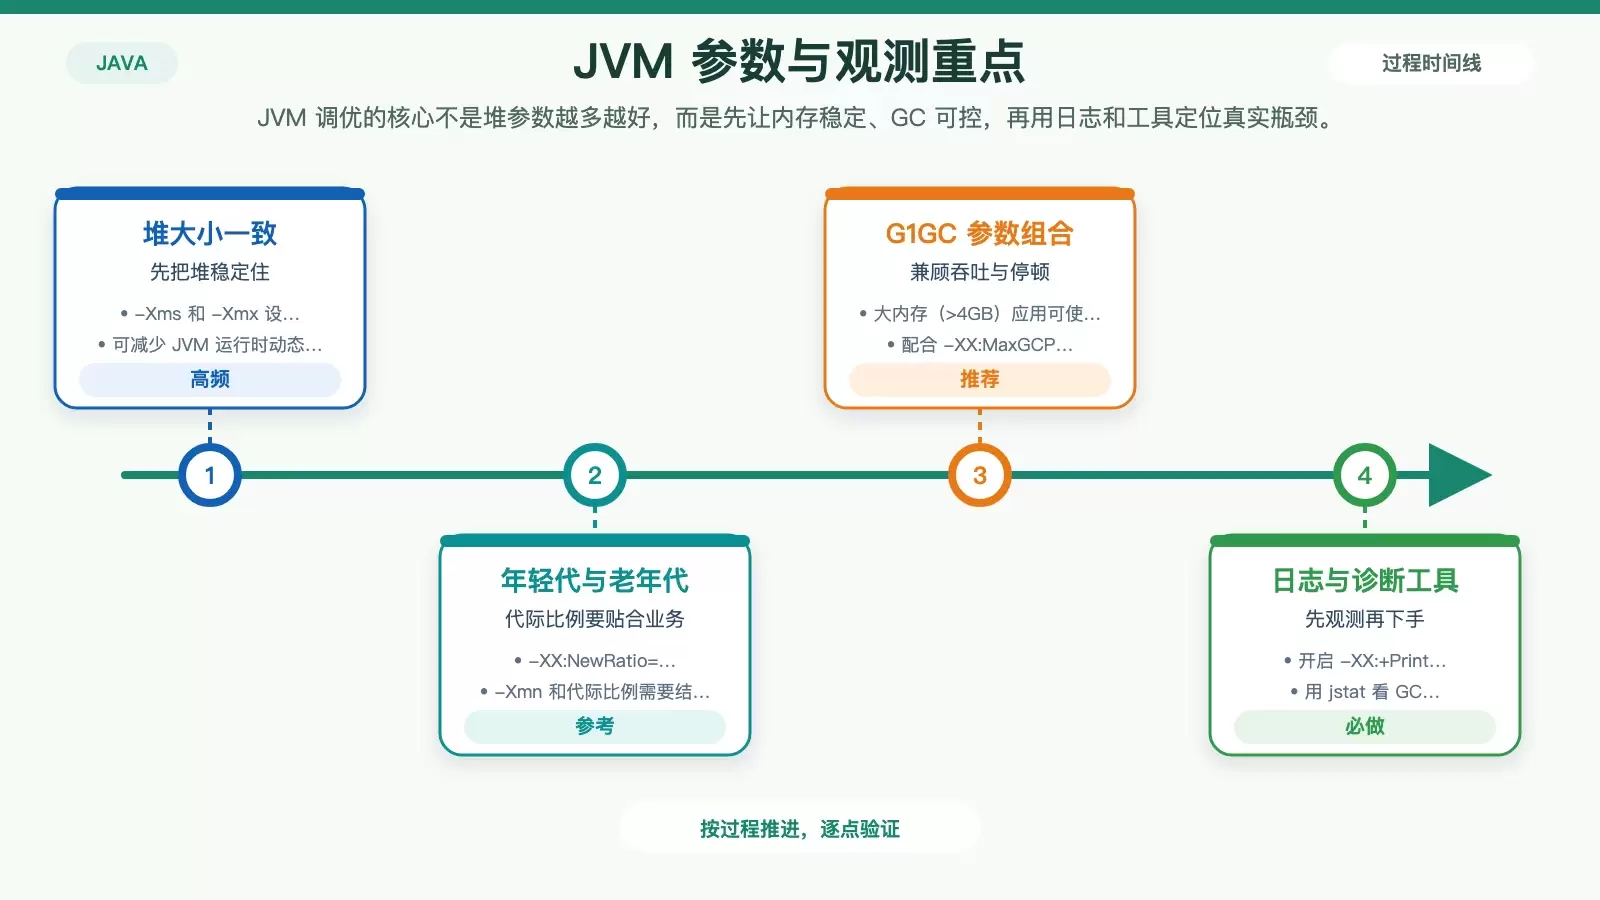
堆内存参数怎么设更稳
堆大小如果频繁动态扩缩,会直接带来额外性能损耗。因此,初始堆和最大堆通常建议设成一致,例如:
-Xms8g -Xmx8g这样可以避免 JVM 运行过程中反复扩容。
同时,年轻代大小 -Xmn 和新生代/老年代比例 -XX:NewRatio 也要结合对象生命周期来调。例如:
-XX:NewRatio=3这表示年轻代大约占整个堆的 1/4。对象朝生夕灭的业务,往往更需要仔细看这部分配置。
大内存应用优先看 G1GC
对于大内存(>4GB)Java 应用,文中推荐优先考虑 G1GC。启用方式如下:
-XX:+UseG1GC如果你更关注停顿时间,可以同时设置:
-XX:MaxGCPauseMillis=200它表示期望把最大 GC 停顿控制在 200 毫秒左右。
当应用对延迟更敏感时,还可以进一步提前并发回收触发时机:
-XX:InitiatingHeapOccupancyPercent=45这个参数用于让 G1 更早开始并发 GC,避免老年代压力积累过高后出现更明显的停顿。
先开 GC 日志,再用工具定位问题
JVM 调优最怕“凭感觉”。比起直接猜参数,先把日志和观测手段打开更靠谱。文中建议启用 GC 日志:
-XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/path/to/gc.log排查时常用的工具包括:
jstat:实时观察 GC 状态。jmap:导出堆转储,分析对象分布和内存占用。jstack:查看线程状态,定位阻塞、死锁或高 CPU 线程。
这一步的重点不是“工具越多越好”,而是先确认瓶颈究竟在 GC、内存泄露,还是线程争用。
代码层优化:减少对象抖动和锁竞争
当系统和 JVM 都没有明显问题时,性能瓶颈往往会落到代码细节上,尤其是高频路径中的对象创建、集合选型和同步方式。
少做无意义对象创建
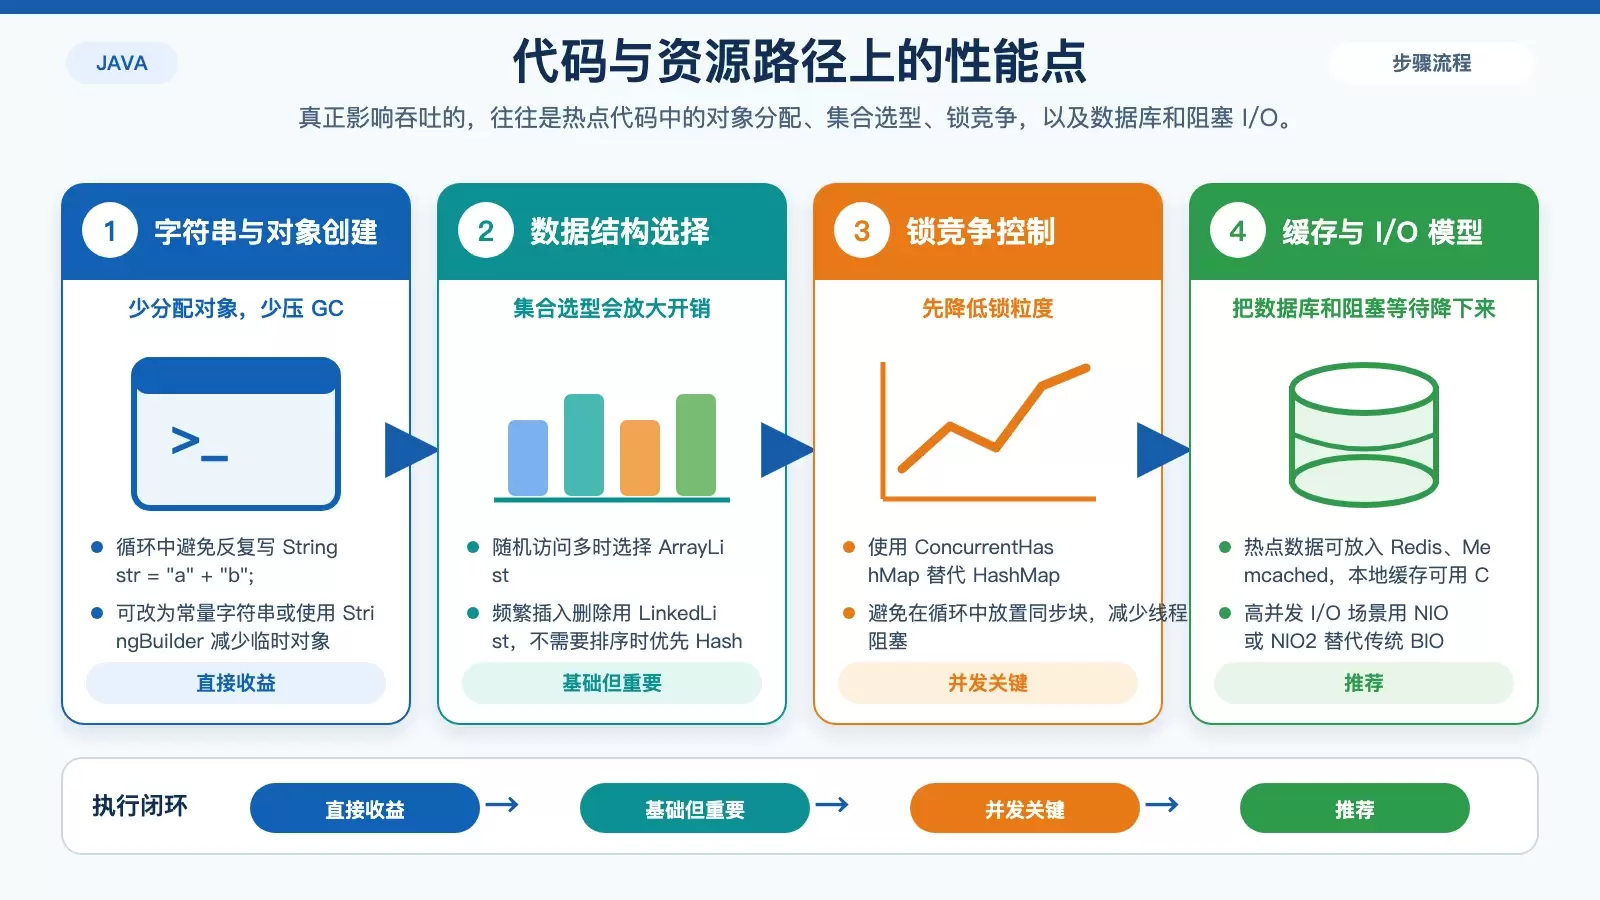
对象分配越频繁,GC 压力越大。文中的例子很典型:
String str = "a" + "b";如果这类写法出现在循环里,就会不断生成新对象。更合适的方式是直接写成:
String str = "ab";或者使用 StringBuilder 处理拼接逻辑,减少临时对象数量。
集合和数据结构别选错
不同集合类的性能特征差异很大,选错了会把基础开销放大:
- 随机访问多:用
ArrayList - 频繁插入、删除:用
LinkedList - 不需要排序:优先
HashMap,不要用TreeMap承担额外排序成本
这些看似基础的选择,往往决定了热点代码的实际吞吐。
合理使用 final,给 JIT 更多优化空间
文中还提到,使用 final 修饰类、方法和变量,可以帮助 JVM 做进一步优化。比如 final 方法更容易被内联,调用时可以直接替换成方法体逻辑,从而减少方法调用开销。
当然,这类收益通常不如内存配置和锁优化来得明显,但在热点路径上依然值得关注。
并发场景下优先降低锁粒度
高并发应用里,锁竞争往往比单次方法调用更致命。文中的建议很直接:
- 用
ConcurrentHashMap代替HashMap+synchronized - 避免在循环中使用同步块,减少线程阻塞
核心思路是:与其让更多线程等待同一把锁,不如先从容器和临界区范围入手,把竞争降下来。
资源管理与 I/O 模型:避免泄露,也别让数据库和阻塞 I/O 拖后腿
很多 Java 服务并不是“算得慢”,而是资源没及时释放、缓存没用好,或者 I/O 模型本身已经不适合当前并发规模。
用 try-with-resources 减少资源泄露
文件句柄、数据库连接、网络 Socket 一旦泄露,问题通常不会马上爆发,但跑久之后会持续放大。Java 7+ 可以直接使用 try-with-resources 自动关闭资源,减少人为遗漏:
try-with-resources这种写法尤其适合 I/O 密集型服务和长时间运行的后端进程。
热点数据要缓存,别让数据库承受所有压力
如果性能瓶颈来自重复查询,缓存通常比继续加机器更直接。文中的建议包括:
- 分布式缓存:
Redis、Memcached - 本地缓存:
Caffeine
前者适合共享热点数据,后者适合高频、小体量、低延迟访问场景。具体怎么选,要看数据一致性要求和部署结构。
高并发 I/O 场景优先考虑 NIO/NIO2
传统 BIO 在连接数上来后,线程和阻塞等待的成本会越来越高。文中建议在高并发场景下改用 NIO 或 NIO2,借助非阻塞 I/O 和多路复用提升处理效率。
如果应用已经出现线程数很多、I/O 等待明显、CPU 利用率却不高的情况,这一层通常值得优先排查。
启动链路与版本选择:缩短冷启动,也别忽略 JDK 升级收益
除了运行时吞吐,启动速度和基础版本也会影响整体体验,尤其是频繁发布、弹性扩缩容或者短生命周期服务。
启动参数可以优化,但要区分测试和生产
如果目标是缩短启动时间,文中给出两个方向。
一是通过:
-Xverify:none禁用字节码验证,减少类验证时间。但这里要注意,文中明确提示这项设置仅适用于测试环境,生产环境需要谨慎使用。
二是延迟加载非必要类,把不影响首屏或首个请求的初始化动作往后放,从而降低启动阶段的集中开销。
CDS 可以减少重复类加载成本
共享类数据(CDS)适合多 JVM 实例并存的环境。开启方式是:
-Xshare:on它会把常用类放进共享内存,多个 JVM 实例可以复用,减少重复加载带来的启动和内存开销。
优先使用 Java 17 LTS 或 Java 21 LTS
如果还停留在更老的版本,升级 JDK 往往是性价比很高的一步。文中建议尽量使用最新稳定版,例如 Java 17 LTS 或 Java 21 LTS。原因很明确:新版本通常自带更成熟的 JIT 优化和 GC 改进,很多性能收益并不需要业务代码大改。
最后一步:修复随机数阻塞,并用压测验证每次优化
性能优化最容易出问题的地方,不是“没调到最好”,而是改动上线后没有验证。
避免安全随机源阻塞
文中提醒了一个很容易忽略的点:修改 /etc/security/java.security,把 securerandom.source 设置为:
file:/dev/urandom这样可以避免 /dev/random 在熵不足时发生阻塞,尤其是在高并发环境下,这类卡顿有时会被误判成应用本身性能差。
每次优化后都要重新压测
最后,任何优化都应该通过压力测试来收尾。文中给出的工具包括 JMeter 和 Gatling。实践上,更关键的是把压测和监控结合起来看:
- 吞吐有没有提升
- 延迟有没有下降
- GC、线程、I/O 指标有没有变好
- 改动是否引入新的抖动或稳定性问题
只有经过这一轮验证,参数调整、代码修改和系统优化才算真正成立。















