Python+Selenium实现浏览器的控制操作
本文详解Python Selenium对浏览器的核心控制操作。涵盖通过ChromeOptions设置无头模式等参数、调整窗口大小与获取页面信息、使用forward/back实现前进后退、利用execute_script执行JS控制滚动条,以及通过window_handles和switch_to.handle进行多窗口切换的完整代码示例与注意事项。



本文详解Python Selenium对浏览器的核心控制操作。涵盖通过ChromeOptions设置无头模式等参数、调整窗口大小与获取页面信息、使用forward/back实现前进后退、利用execute_script执行JS控制滚动条,以及通过window_handles和switch_to.handle进行多窗口切换的完整代码示例与注意事项。
本文详细介绍Python中操作XML文件的两种主要方式:xml.etree.ElementTree和xml.dom.minidom。通过具体代码示例,演示如何解析XML文件、提取元素与属性、修改节点内容以及增删节点,帮助开发者掌握Python处理XML数据的核心技能。
本文深入解析Python Pandas库中query函数的核心用法。涵盖基础值匹配、数学表达式运算、变量引用(@符号)、列表包含(in)及多条件逻辑组合(&和|)。通过具体代码示例展示如何处理含空格列名及筛选后列选取,帮助开发者实现更简洁高效的数据过滤操作。
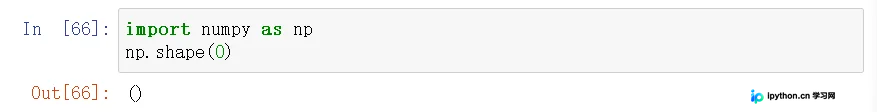
本文详解Python中numpy.core.fromnumeric模块下的shape()函数,用于读取矩阵长度与维度信息。通过解析输入参数为一维或二维矩阵时的返回值,以及利用shape[0]和shape[1]分别获取行数和列数的具体操作,帮助开发者掌握数组维度的判断方法。同时解释了Debug场景中shape(?,2,3)里问号代表的批处理个数含义,为数据分析提供基础支持。
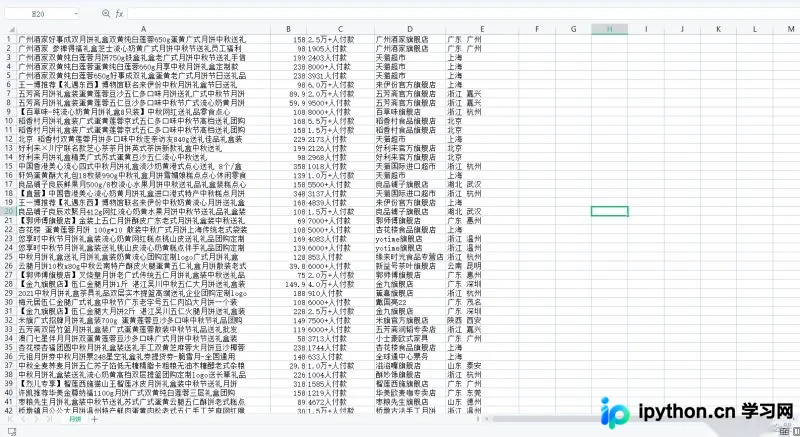
本文介绍如何使用Python对月饼电商数据进行清洗与可视化分析。通过Pandas处理价格、销量及店铺信息,利用Pyecharts生成销量Top10店铺与商品柱状图、不同价格区间销量占比饼图以及各省销量分布地图,帮助直观了解市场趋势与热门产品。
本文详细介绍Python中Pandas库的核心数据结构Series和DataFrame。通过具体代码示例,演示如何利用标量、字典、Ndarray等数据源创建Series,以及如何基于字典、Series和二维数组构建DataFrame,帮助开发者快速掌握Pandas基础操作。
本文详解Python中使用正则表达式re.sub匹配或替换反斜杠\\时的转义问题。由于正则语法与Python字符串解析器的双重转义机制,直接写入单个反斜杠会导致语法错误。文章通过对比分析,解释了为何需要四个反斜杠(\\\\)或使用原始字符串(r'\\')来正确匹配单个反斜杠,并提供了str.replace()作为替代方案。

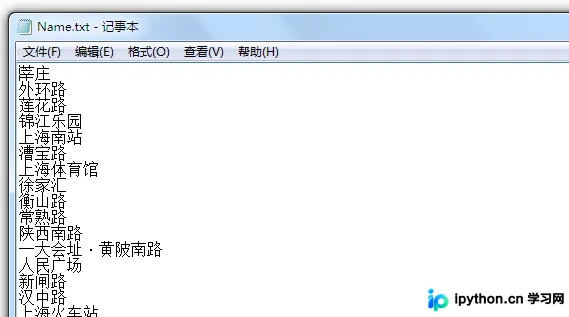
本文介绍如何利用C++语言处理文本数据,统计地铁站点名称中各汉字的出现频率。通过读取包含站名的文件,首先对数据进行去重处理,随后逐字遍历并记录字符次数,最后根据频次进行降序排序输出。该方法展示了基础的文件I/O、字符串操作及数组管理技巧。
本文详细介绍如何使用Python pandas库中的read_json函数将JSON文件或字符串转换为数据框。文章通过具体示例演示了records、index、columns、values及split五种orient格式的参数配置与输出结果,并补充了compression压缩加载与encoding编码设置方法,帮助开发者高效处理结构化JSON数据。
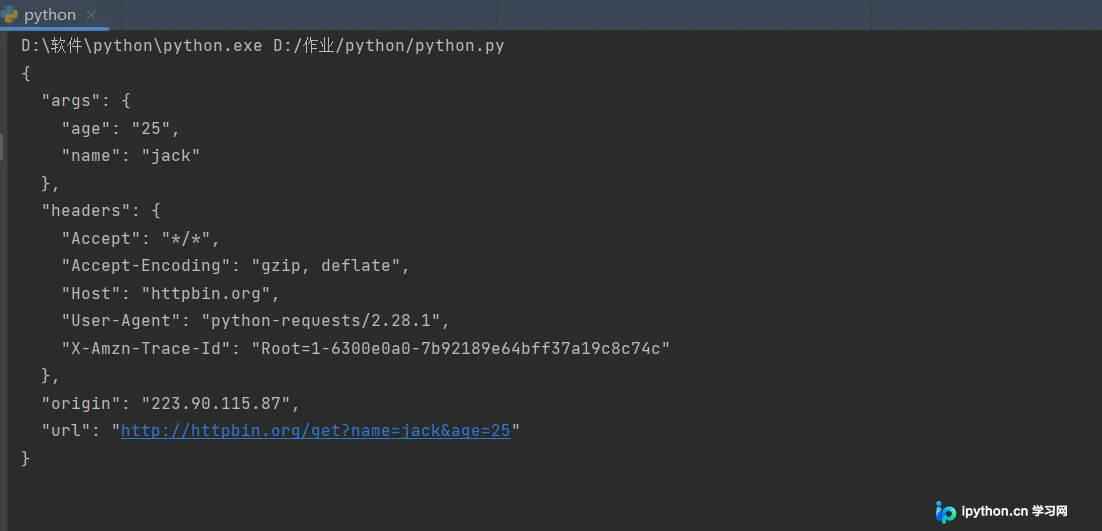
本文详细介绍Python爬虫中requests库的安装方法及GET与POST请求的具体使用。涵盖通过pip或源码安装requests,演示如何构造带参数的GET请求、获取JSON数据、处理二进制文件下载,以及利用data和files参数进行POST请求和文件上传。同时解析响应状态码、异常抛出及JSON转换技巧,帮助开发者高效完成HTTP交互。
本文解析Python爬虫中因服务器使用Brotli压缩导致的中文乱码问题。详细说明了如何识别Accept-Encoding头中的br格式,通过手动导入brotli库或使用httpx自动处理来正确解码数据,并提供了修改请求头以禁用br压缩的替代方案。
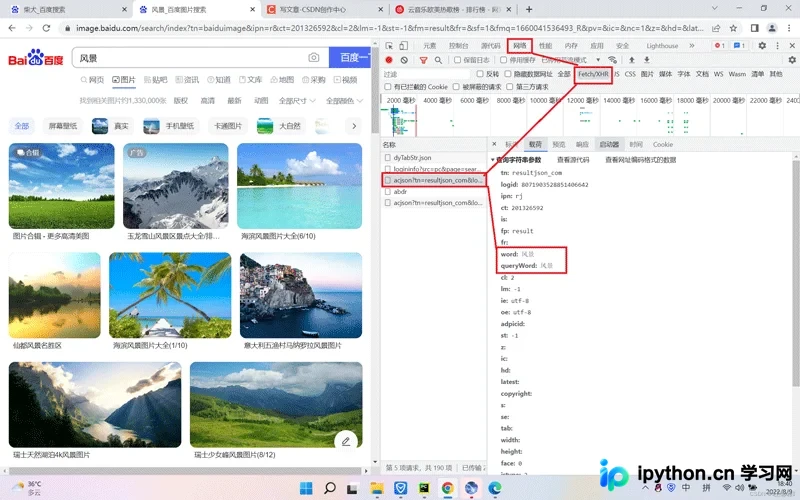
本文详细介绍如何使用Python编写一个简单的图片搜索引擎。通过发送HTTP请求获取网页源码,利用正则表达式筛选图片链接,并模拟浏览器头信息防止被封禁。最终将筛选出的图片二进制数据保存至本地指定文件夹,实现自动化的图片抓取与存储功能。