


零基础转行数据分析:Python实战路径与避坑指南
本文面向无编程背景的数据分析转行者,提供从环境搭建到项目落地的完整学习路径。内容涵盖Python核心语法、Pandas数据清洗、可视化分析及SQL技能补充,重点解析如何构建可复现的项目作品集,并针对转行过程中常见的“重语法轻业务”、“忽视SQL”等误区给出具体修正建议,帮助学习者高效对齐企业岗位需求。
环境搭建与Python基础:从配置到核心语法
转行数据分析的第一步并非死记硬背语法,而是搭建稳定且开箱即用的开发环境。推荐使用Anaconda发行版,它预装了Jupyter Notebook及常用的科学计算库,能极大降低依赖冲突的配置成本。安装完成后,通过终端执行 python --version 验证版本,并使用 jupyter notebook 启动交互式界面。在基础语法层面,需重点掌握变量命名规范、五大基本数据类型(整型、浮点型、字符串、布尔型、None)、条件判断(if-elif-else)与循环结构(for/while)。函数定义使用 def 关键字,需理解位置参数、关键字参数与返回值机制。列表(List)与字典(Dict)是数据处理中最常用的容器,必须熟练运用切片、append、pop、遍历及键值对操作。例如,编写一个统计英文句子中各单词出现频率的练习,结合 for 循环与字典的 get 方法,可快速检验对基础语法的掌握程度。切忌脱离环境死记硬背,应在Notebook中逐行运行代码,观察Traceback报错信息并调试,建立编写、运行、反馈的肌肉记忆。
数据处理核心:NumPy、Pandas与清洗实战
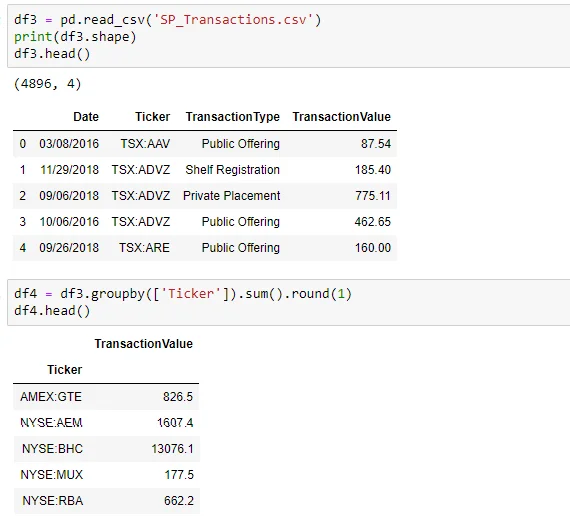
掌握基础语法后,需迅速过渡到数据分析专用库。NumPy提供高效的多维数组对象,是Pandas的底层基础,建议先理解 np.array 的向量化运算与广播机制,避免使用低效的Python原生循环。Pandas则是数据分析的核心工具,其DataFrame结构类似电子表格,但支持更强大的编程操作。学习路径应从数据读取开始:使用 pd.read_csv() 加载本地或网络数据集,通过 .head()、.info()、.describe() 快速探查数据全貌。数据清洗是日常工作的重头戏,需掌握布尔索引筛选(如 df[df['age'] > 25])、.sort_values() 排序、.drop_duplicates() 去重。针对缺失值,可结合业务场景选择 .dropna() 删除或 .fillna() 填充;数据类型转换则通过 .astype() 或 pd.to_datetime() 完成。分组聚合是提炼业务指标的关键,熟练使用 df.groupby('category')['sales'].agg(['sum', 'mean']) 能高效输出多维度统计结果。建议下载公开的电商订单CSV数据集,完整走一遍读取、清洗、转换、聚合的流程,确保每一步操作都有明确的业务目的。
从数据到洞察:统计分析与时序可视化
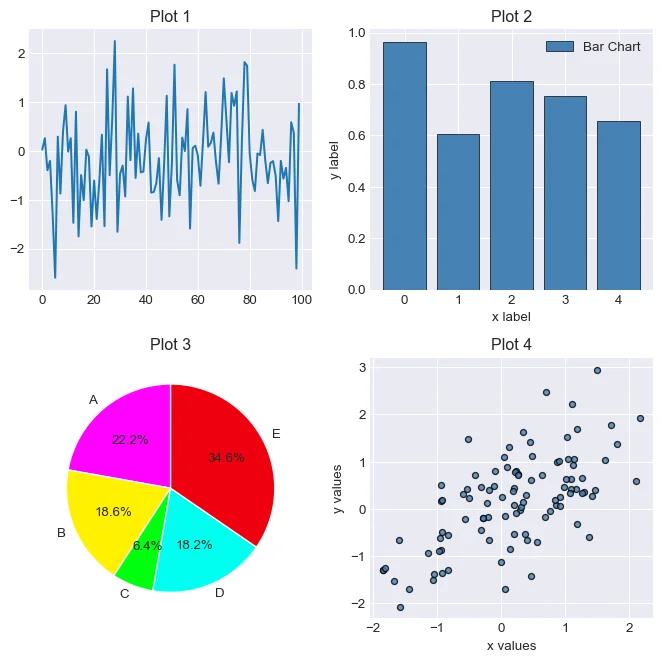
数据清洗完成后,分析的核心在于从数字中提炼业务结论。描述性统计是起点,需掌握均值、中位数、标准差、分位数等指标的计算逻辑,并结合 df.describe() 快速定位数据分布特征。相关性分析可通过 df.corr() 计算皮尔逊系数,辅助判断变量间的线性关系。可视化是表达结论的通用语言,Matplotlib提供底层绘图控制,适合定制复杂图表;Seaborn则基于Matplotlib封装,内置美观的统计图表模板。例如,使用 sns.lineplot() 绘制月度销售额趋势,用 sns.barplot() 对比不同渠道转化率,或通过 sns.heatmap() 展示特征相关性矩阵。绘图时务必注意坐标轴标签、图例、标题的完整性,避免图表无结论的常见错误。更重要的是训练分析思维:先明确业务问题(如为何本月复购率下降),再选择对应指标与图表,最后结合业务背景解释异常点或趋势。建议将清洗后的数据导出为可视化报告,用文字总结数据现象、可能原因与验证建议,完成从数据处理到价值输出的闭环。
岗位技能补齐:SQL、业务思维与项目闭环
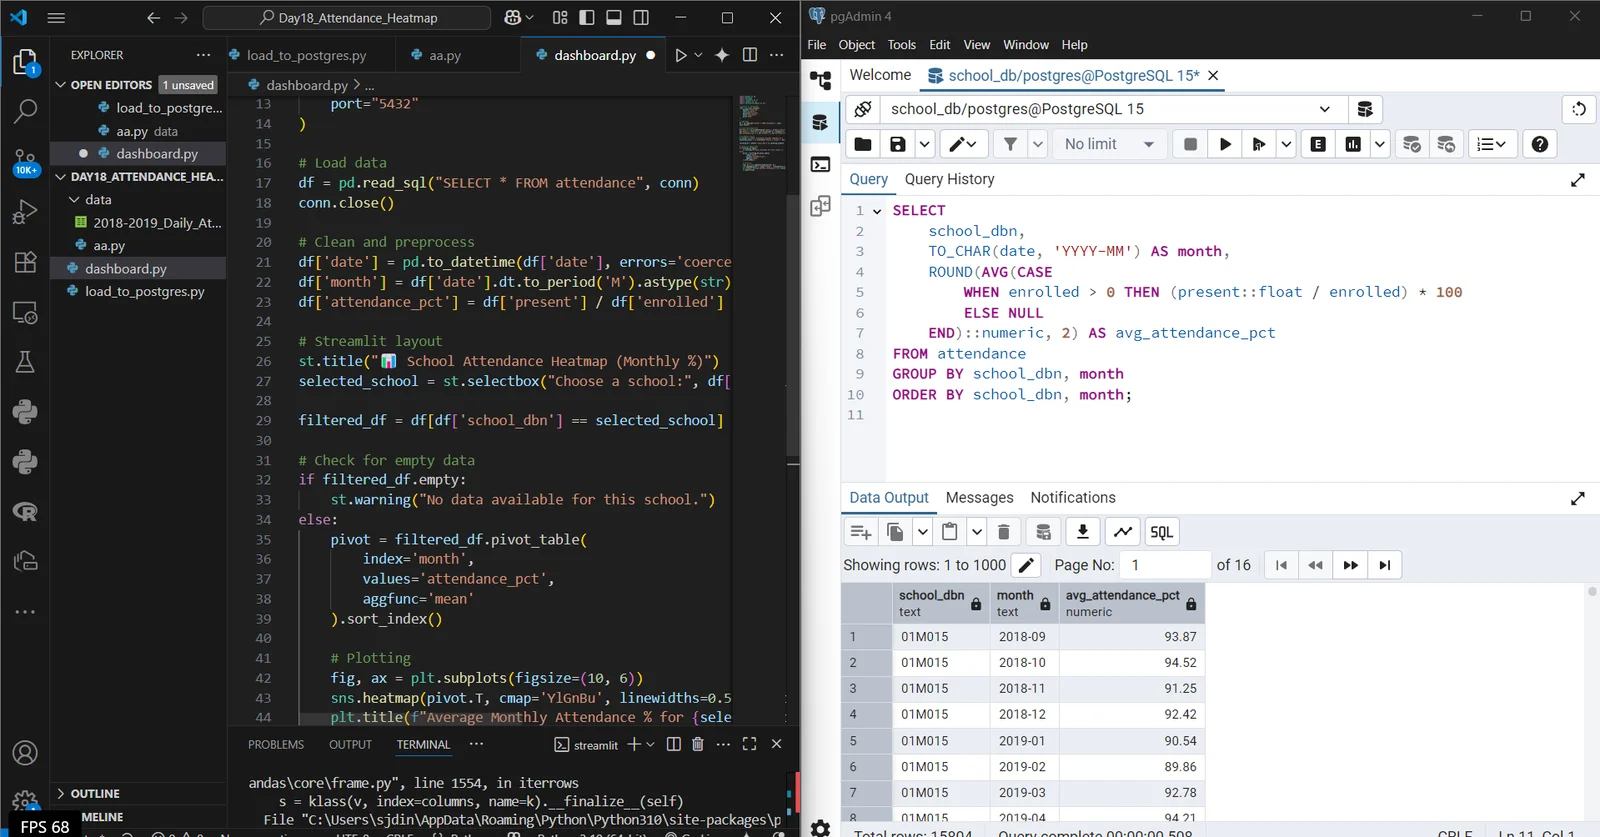
Python仅是数据分析工具箱的一部分,实际岗位更看重综合技能栈。SQL是数据提取的必备语言,需熟练掌握 SELECT、JOIN、GROUP BY、窗口函数等核心语法,能独立完成多表关联与指标计算。Excel在快速验证、透视表分析和汇报场景中不可替代,建议掌握 VLOOKUP/XLOOKUP、数据透视表及基础图表。统计基础方面,理解假设检验、置信区间、A/B测试原理能显著提升分析严谨性。业务思维是区分取数工具人与分析师的关键,需熟悉DAU、留存率、GMV、ROI等核心指标的计算口径与业务含义。项目实战是能力整合的试金石,可选择电商用户复购分析、APP拉新渠道效果评估或零售门店销售诊断等场景,完整经历明确需求、SQL取数、Python清洗分析、可视化呈现、撰写业务报告的全流程。最终成果应包含可复现的代码仓库、交互式图表及结构化PPT,直接对标企业真实工作流,为简历提供扎实背书。
成果验证与转行避坑:以岗位需求为导向
学习成果必须通过客观标准验证,而非自我感觉良好。建议定期对照主流招聘平台的数据分析师岗位描述,逐项核对Python数据处理、SQL查询、统计基础、可视化表达及项目经验是否达标。转行过程中极易陷入五大误区:一是沉迷语法细节而忽视实际数据操作;二是被动观看视频教程却从不亲手敲代码;三是缺乏完整项目经验,简历仅罗列学过某库;四是轻视SQL,导致无法独立完成数据提取;五是过早钻研机器学习算法,脱离业务分析主线。正确的进阶路径应为:环境配置与语法基础、Pandas清洗与SQL基础、统计分析与可视化、综合业务项目实战、简历优化与面试模拟。每个阶段结束后,用一套公开数据集完成端到端分析,并邀请同行或前辈评审。只有将技能沉淀为可展示的项目作品集,并持续对齐岗位真实需求,才能顺利完成从零基础到数据分析师的平稳过渡。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。



