MySQL字符集原理与配置:从client到results的全链路解析
本文详解MySQL字符集工作原理,重点解析client、connection、server及results四层交互机制。通过set names gbk指令统一客户端写入与服务器读取编码,解决乱码问题,并提供查看变量与插入中文数据的完整实操示例。
2026-10-15
0



本文详解MySQL字符集工作原理,重点解析client、connection、server及results四层交互机制。通过set names gbk指令统一客户端写入与服务器读取编码,解决乱码问题,并提供查看变量与插入中文数据的完整实操示例。
本文详解在 SQL Server 中删除表内重复记录的两种实用方案。若表含唯一键(如 ID),可通过聚合筛选保留极值;若无唯一标识,则利用 ROW_NUMBER() OVER(PARTITION BY ...) 窗口函数精准定位并清除冗余行。
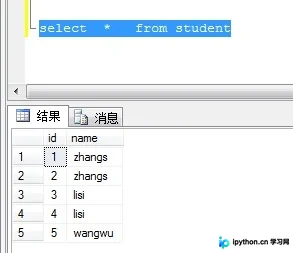
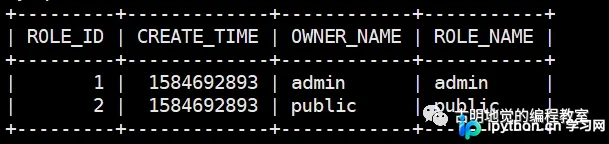
本文介绍Python中prettytable库的使用方法,该库可将数据以类似MySQL客户端的格式输出。内容涵盖添加表头与行列、指定行列输出、设置表格样式(如DEFAULT、MSWORD_FRIENDLY等)、调整列对齐方式及自定义边框字符,帮助开发者在控制台生成结构清晰、美观的文本表格。
本文详解MySQL连接查询核心原理,对比交叉连接(笛卡尔积)、内连接和外连接的区别。通过完整SQL代码演示如何正确使用INNER JOIN、LEFT JOIN及其语法变体如USING关键字,帮助开发者理解主表保留逻辑与匹配规则,提升复杂数据检索能力。
本文详细介绍 MySQL 中数据的排序操作与常用的单行处理函数。通过实际案例演示如何使用 ORDER BY 实现单字段、多字段的升序与降序排列,以及结合 WHERE 子句的复合筛选。同时深入解析 LOWER/UPPER、SUBSTR、CONCAT、LENGTH、TRIM、ROUND 和 NVL 等字符串及数值函数的具体用法与场景,帮助开发者高效完成数据清洗与格式化任务。
本文详解MySQL联合索引的最左前缀匹配原则及其例外情况。重点介绍MySQL 8.0引入的索引跳跃扫描功能:当联合索引首列唯一值较少时,查询未包含该列的条件仍可自动利用索引进行加速,并提供建表语句及EXPLAIN验证示例,帮助开发者掌握更高效的SQL优化技巧。

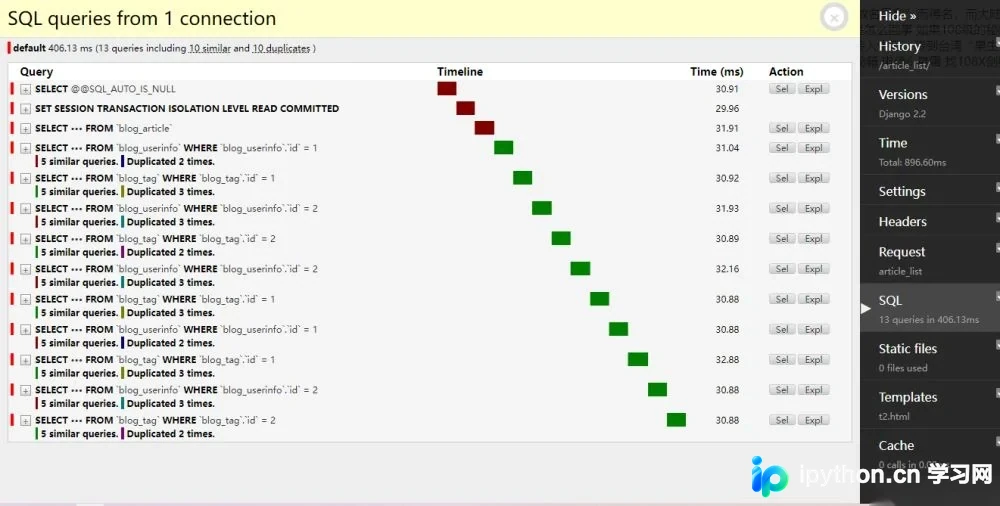
本文详解Django中select_related与prefetch_related的用法与区别。通过django-debug-toolbar展示原生查询导致的N+1问题,对比分析两者在单表关联与多表关联中的性能差异。文章提供完整代码示例,说明如何利用双下划线指定字段及Prefetch对象添加过滤条件,帮助开发者有效减少数据库查询次数,提升应用性能。
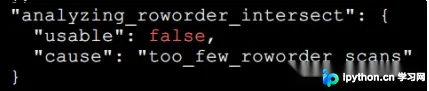
本文详细解析MySQL索引合并机制,涵盖Intersection(交集)、Union(并集)及Sort-Union三种类型。重点说明在等值匹配、主键范围过滤下的适用条件,对比单索引回表与多索引合并的成本差异,并提供通过联合索引替代索引合并以提升查询性能的优化建议。
在PostgreSQL中存储URL时,若需提取协议、主机名或路径等信息,可使用内置的ts_debug函数。该函数通过文本搜索配置对URL进行词法分析,返回协议头、URL完整路径、主机名及具体路径等字段,无需编写复杂正则即可实现结构化解析。
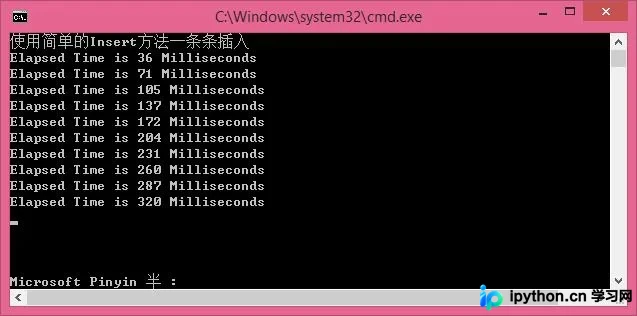
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
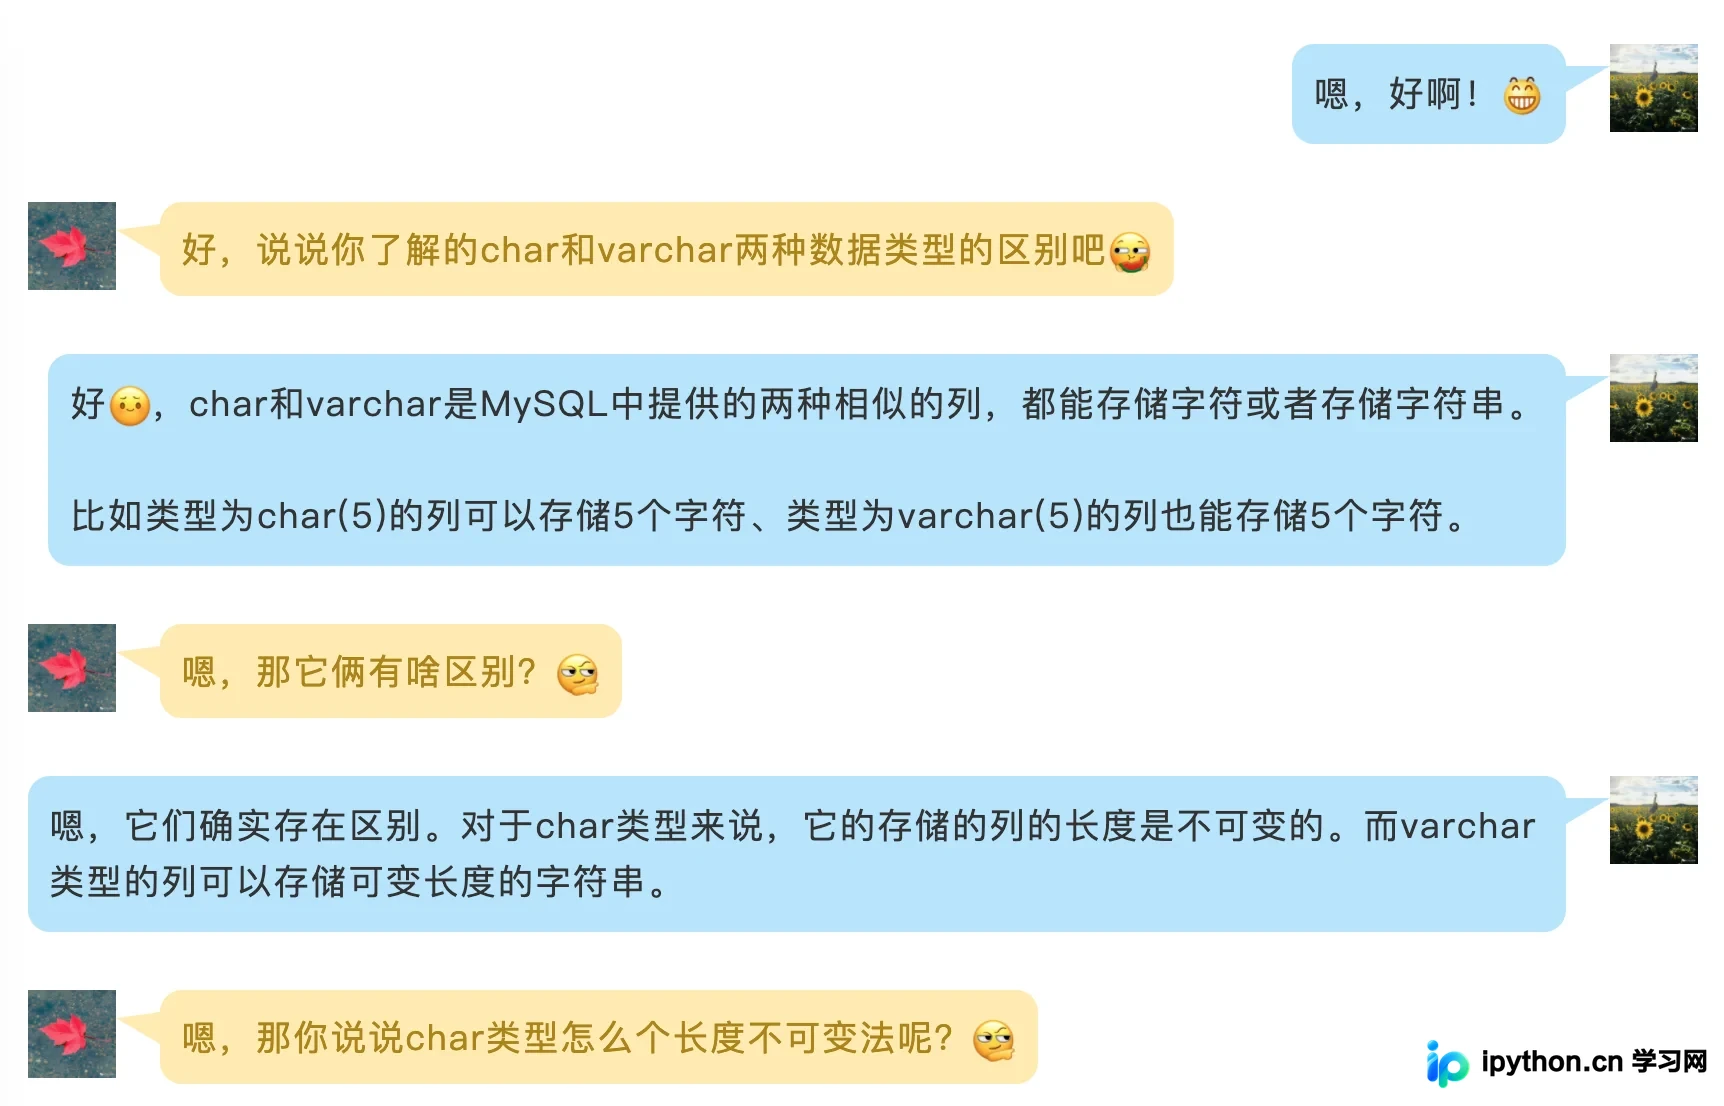
在MySQL中,CHAR是固定长度字符类型,不足补空格;VARCHAR是可变长度,仅存实际内容加1-2字节头信息。CHAR适合定长且短小的数据如MD5哈希,查询速度快;VARCHAR适合不定长文本以节省空间。合理选择能显著提升存储空间利用率与I/O效率,避免不必要的资源浪费。
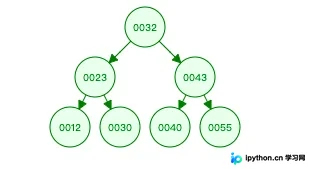
本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。