PHP Memcache 缓存基础用法与数据库查询优化
本文详解 PHP 中使用 Memcache 进行数据缓存的核心方法,涵盖 add、get、replace 和 delete 等操作。通过实际代码示例,演示如何结合 MySQL 查询结果构建缓存机制,以 md5 哈希作为键值标识,有效减轻数据库压力并提升应用响应速度。
10-16
2




本文详解 PHP 中使用 Memcache 进行数据缓存的核心方法,涵盖 add、get、replace 和 delete 等操作。通过实际代码示例,演示如何结合 MySQL 查询结果构建缓存机制,以 md5 哈希作为键值标识,有效减轻数据库压力并提升应用响应速度。
针对SQL Server中大量数据导入需求,传统单条INSERT效率低下。本文通过C#代码实证对比三种方法:普通循环插入、SqlBulkCopy批量复制及表值参数(TVP)。重点详解Bulk与TVP的配置步骤、代码实现及性能差异,提供从建库、定义类型到执行插入的完整流程,帮助开发者在高并发场景下选择最优数据写入策略。
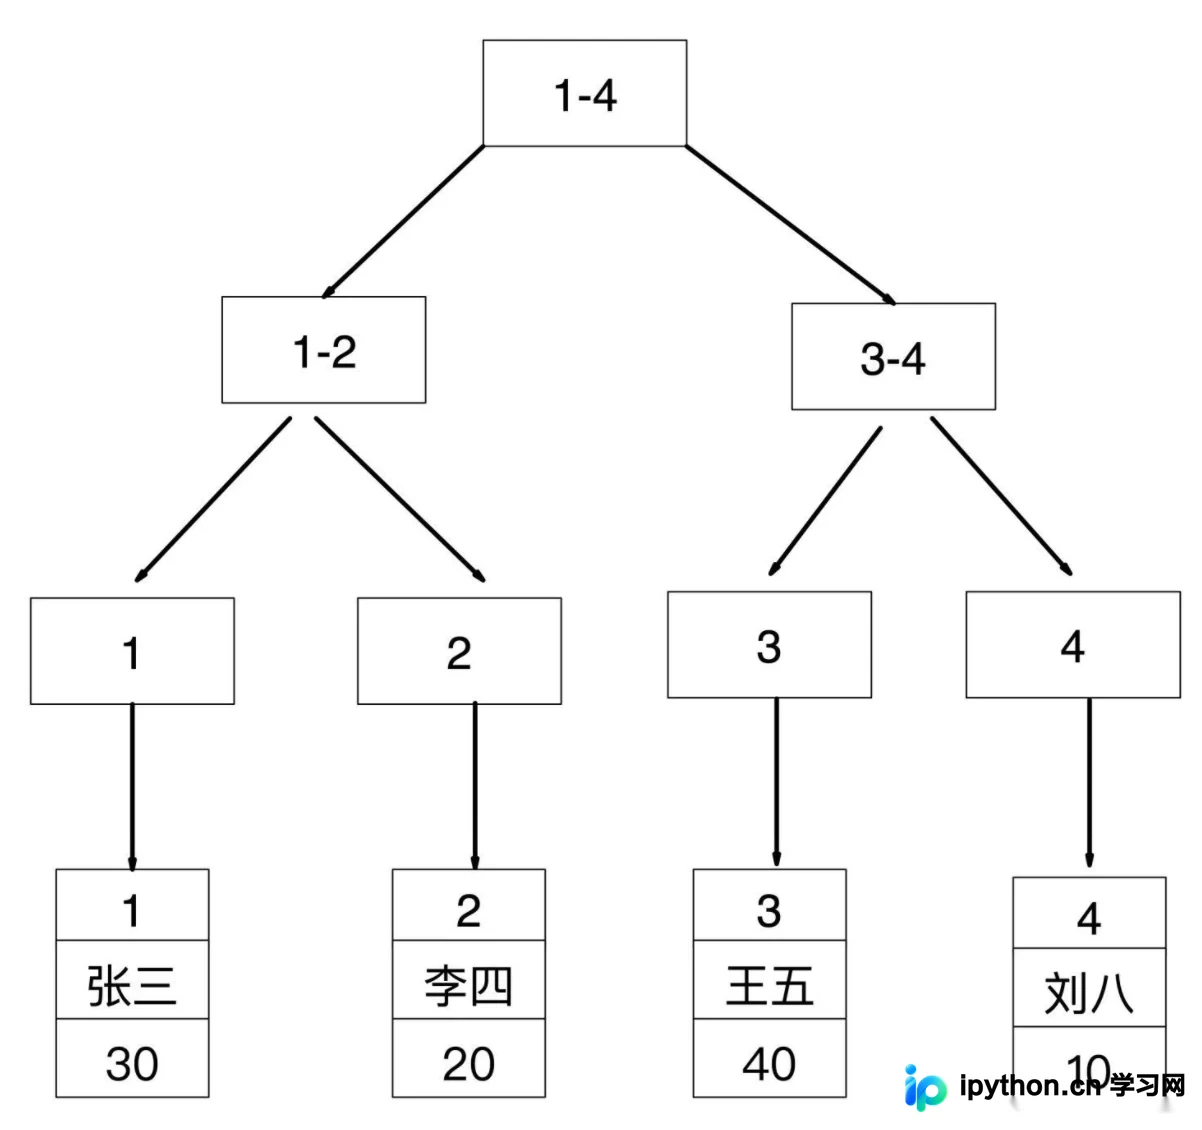
本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
本文梳理MySQL中复杂的日期区间查询技巧,重点指出DATE_FORMAT导致索引失效的问题并提供优化方案。汇总now、curdate等时间获取函数,以及date_format、str_to_date转换方法,并结合date_add、datediff计算周期数据,提升SQL查询效率。
本文深入解析 MySQL 性能优化的十大核心场景,涵盖最左匹配原则、隐式转换陷阱、大分页延迟关联、IN 查询临界值及范围查询阻断等常见问题。通过 explain、show profile 和 optimizer_trace 工具定位执行计划瓶颈,提供从索引设计到 SQL 重构的实操方案,帮助开发者有效解决慢查询与索引失效问题。
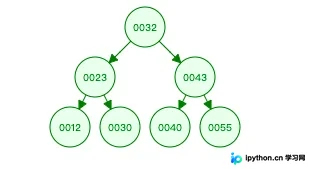
本文深入解析MySQL中常见的索引数据结构,对比二叉树、红黑树、B-Tree与B+Tree的性能差异。重点阐述InnoDB引擎使用B+Tree实现的聚集索引(聚簇索引)与非聚集索引的回表机制,以及MyISAM存储引擎中索引与数据分离的原理,并讲解联合索引的最左前缀原则,帮助开发者理解SQL查询性能优化的底层逻辑。
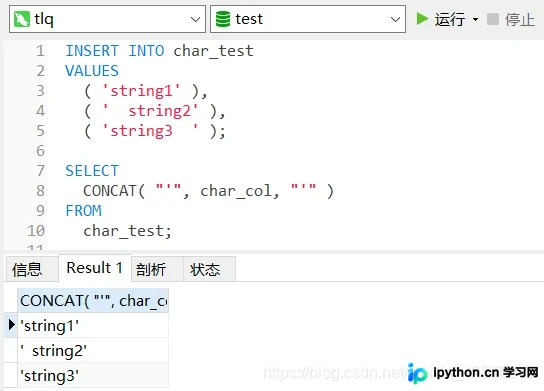
本文深入解析MySQL中CHAR与VARCHAR两种字符串类型的核心差异。CHAR为定长存储,适合短文本及高频更新场景;VARCHAR为变长存储且需额外字节记录长度,节省空间。通过SQL实例对比两者的存储行为,并给出基于数据特征、更新频率及字符集选择的最佳实践建议。
本文详细介绍MySQL中ORDER BY语句的使用,涵盖单列默认升序排序、多列组合排序、ASC/DESC升降序指定以及结合LIMIT获取极值的方法。通过实例演示如何避免中文乱序陷阱并掌握正确的SQL语法顺序。
本文介绍 MySQL 中利用 ON DUPLICATE KEY UPDATE 子句实现“存在则更新,不存在则插入”的高效方法。通过解析唯一索引冲突逻辑、受影响行数判断及 VALUES() 函数在多行插入中的应用,帮助开发者简化业务逻辑,提升数据操作性能。
本文深入解析MySQL索引失效的原理,重点阐述最左前缀匹配原则及范围查询对排序性的影响。通过联合索引(a,b)实例分析单独查b字段、范围查a字段及不等值组合的执行计划,指出函数操作和隐式类型转换导致索引失效的机制。掌握这些规律有助于编写高效SQL并避免性能陷阱。
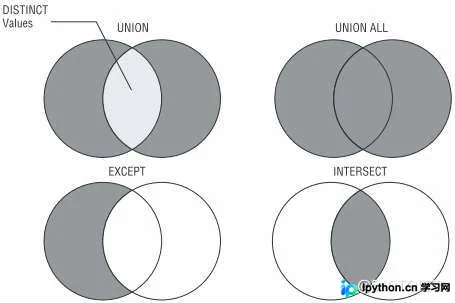
本文详细介绍 SQL Server 中 EXISTS 和 EXCEPT 的用法。EXISTS 用于检查子查询是否返回结果集,支持 IN 逻辑且性能较优;EXCEPT 用于集合运算去除重复数据。通过实例演示两者的语法结构、执行结果及性能差异,帮助开发者根据场景选择最合适的查询方式。
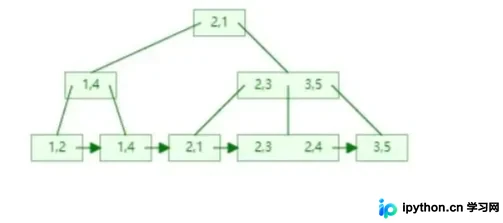
本文深入解析 MySQL 复合索引的核心机制,重点阐述最左匹配原则在 B+ 树索引中的应用。通过 EXPLAIN 分析执行计划,揭示字段顺序对查询性能的影响及覆盖索引的优势,并提供避免全表扫描的建表建议,帮助开发者优化复杂查询。



