Python解决xlrd读取HTML格式Excel报错及pd.read_html数据不完整问题
本文解决Python中使用xlrd读取HTML格式Excel文件时出现的Unsupported format报错,并针对pd.read_html读取数据不完整的问题,推荐将解析器flavor设置为'bs4'以获取完整数据。
2026-10-15
0



本文解决Python中使用xlrd读取HTML格式Excel文件时出现的Unsupported format报错,并针对pd.read_html读取数据不完整的问题,推荐将解析器flavor设置为'bs4'以获取完整数据。
本文详细介绍Python中pandas库的pd.cut()和pd.qcut()函数在数据分箱中的应用。pd.cut用于基于指定区间的离散化,支持自定义边界和标签;pd.qcut则根据分位数生成等频箱。文章通过代码示例演示了区间开闭控制、自定义标签及精度设置等关键参数,帮助开发者掌握数据预处理中的分箱技巧。
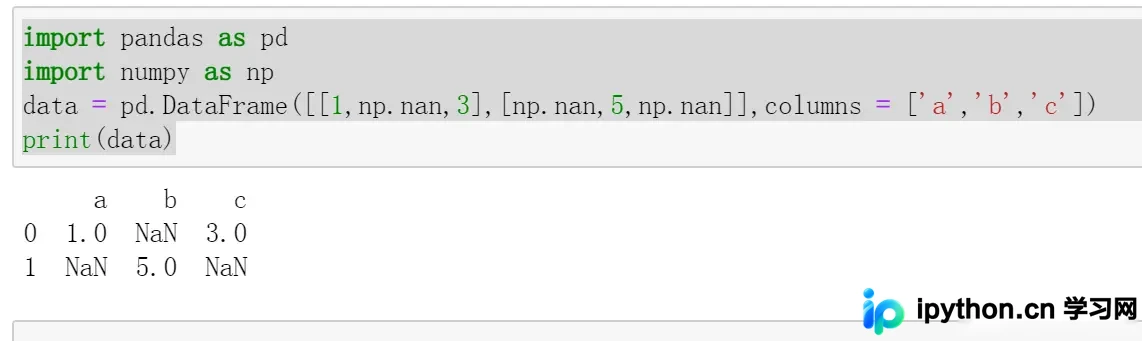
本文详解Python中处理缺失值的两种核心策略:删除与填充。通过演示isnull/isna检测空值,使用dropna按行或阈值删除含NaN数据,以及利用fillna结合均值进行数据补全,帮助开发者掌握Pandas中缺失值处理的关键函数与参数设置。
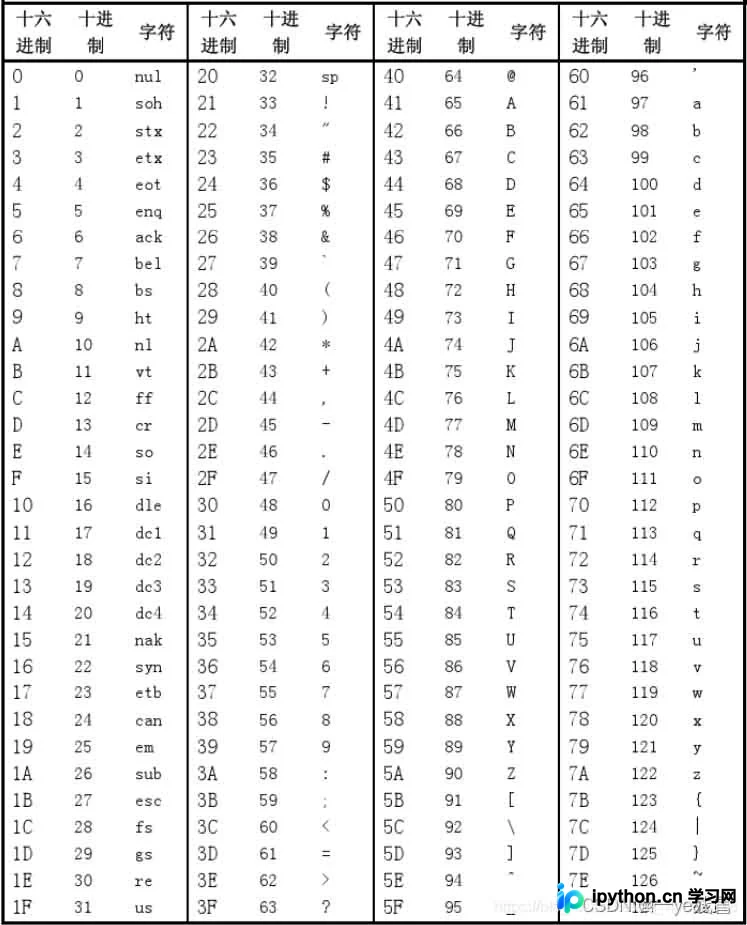
本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
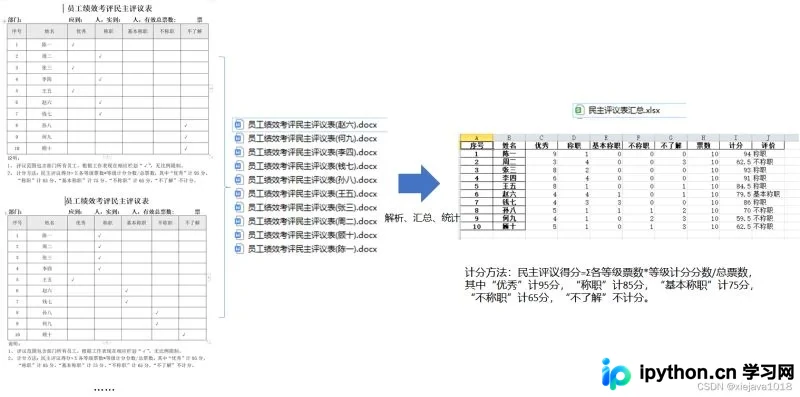
本文介绍利用Python自动化处理年度民主评议表的完整方案。通过docx解析Word文档中的评价表格,使用pandas进行数据汇总与加权计分,最终将结果写入Excel文件。代码不足80行,涵盖从安装依赖、读取目录、解析表格、计算评分到导出文件的全流程,适用于批量处理员工评价数据。
本文介绍如何使用Python和Pandas库,对Excel原始数据进行统计分析。通过基础语法实现累计和、最大回撤、连续正确/错误次数及对应值的计算逻辑,并将结果保存回Excel文件,帮助开发者掌握数据处理的基本流程。
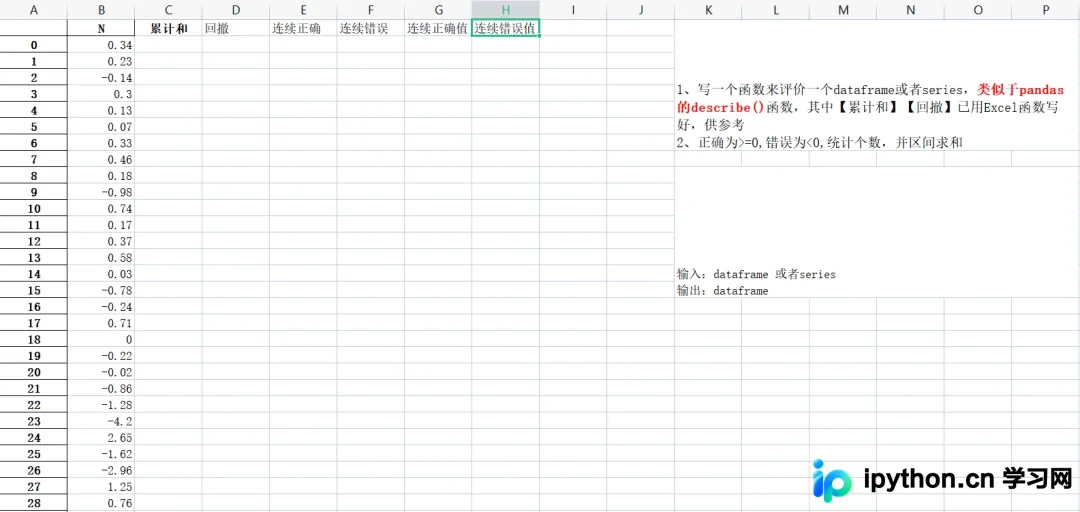
本文介绍如何在Python中使用pandas的groupby函数结合apply和lambda提取每组数据的最大值与最小值。通过异或逻辑筛选极值,并演示如何重置索引及导出Excel,解决直接groupby无法保留完整行的问题。
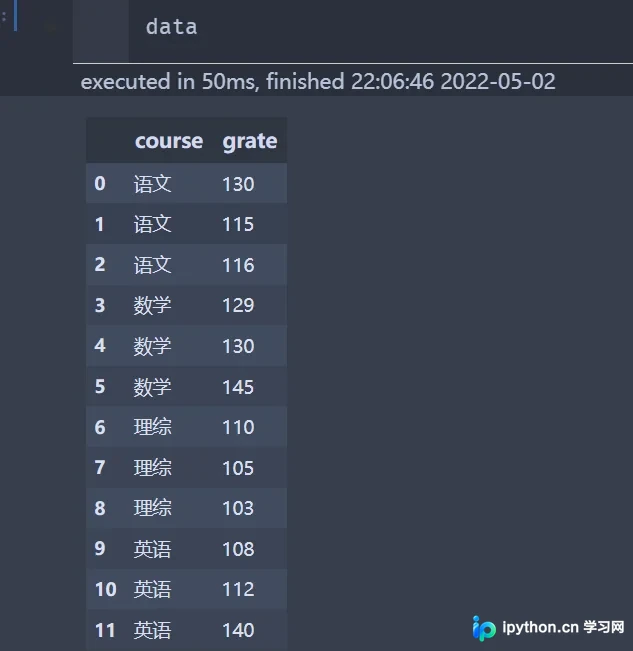
本文详细介绍如何使用Python的pandas库通过pd.read_csv()方法读取CSV文件。内容涵盖基础读取、去除表头、自定义列名、设置索引以及指定分隔符等关键参数用法,并展示如何处理缺失数据,帮助开发者高效处理标准化数据。
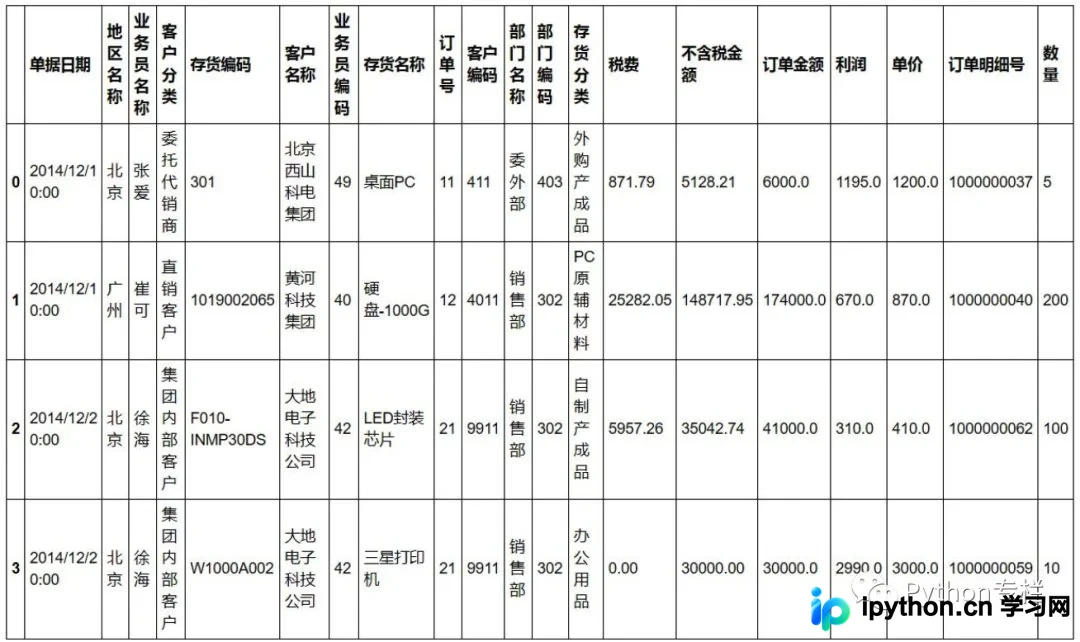
本文总结了14个使用Python Pandas库实现的Excel常用操作,涵盖关联查询、数据透视、差异对比、去重、缺失值处理、多条件筛选、模糊匹配、分类汇总、条件计算、空格去除、数据分列、异常值替换、分组统计及业务标签定义。通过具体代码示例,展示如何用Python高效完成日常数据处理任务,帮助读者巩固Python技能并提升数据处理能力。
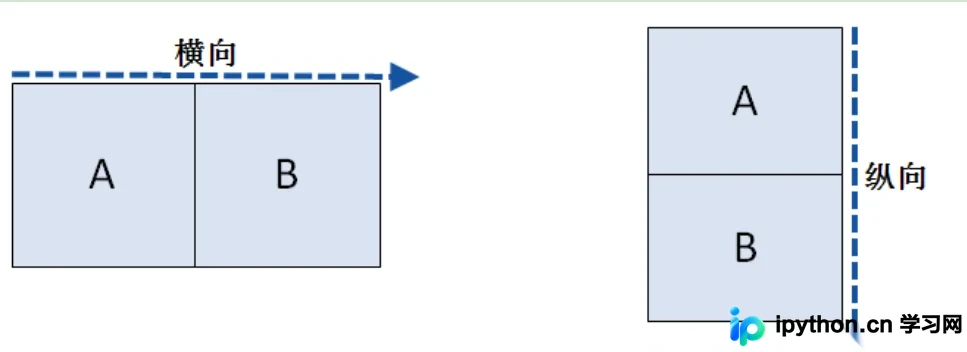
本文详细解析Python中pandas库的数据合并方法,重点介绍concat、merge及join函数的使用场景与参数差异。通过对比纵向与横向堆叠、内外连接策略,结合代码示例展示如何根据索引或列名高效合并DataFrame,并补充combine_first处理缺失值的技巧,帮助开发者掌握数据清洗核心技能。
本文详细介绍在Python中按天生成时间范围序列的三种常用方法。首先利用标准库datetime结合timedelta手动计算;其次介绍使用第三方库Arrow简化日期遍历;最后展示Pandas库中date_range和truncate函数在生成不同间隔及截断时间段序列中的高级应用,帮助开发者灵活处理日期数据。
本文介绍了五个使用Python进行数据清理的实用脚本,涵盖从PDF提取表格、合并多个CSV文件、删除重复行、拆分列以及合并不同数据集等常见场景。通过Pandas库实现自动化处理,显著提升机器学习前的数据准备效率,适用于Tableau等可视化工具及各类模型训练前的数据预处理环节。