


Python查看数据类型与格式

本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
Python查看数据类型与格式
在处理数据时,通常首先需要了解数据的行数和列数,明确各字段的名称以及数据的具体格式类型。在深入讲解数据格式之前,有必要先梳理清楚Python中涉及的各种数据类型。
Python开发中常用的库主要包括Numpy和Pandas。其中,Numpy的核心数据结构是数组(array,即ndarray),而Pandas的核心数据结构则是数据框(包括Series和DataFrame)。
为了便于测试,我们先随机生成一些示例数据。
import pandas as pd
import numpy as np
df=pd.DataFrame(np.random.randint(5,10,size=(10,2)),columns=['a','b'])
Array=np.random.randint(5,10,size=(10,2))
#假设我们不知道df和Array是什么数据类型
接下来,我们需要判断现有数据是数据框类型还是数组矩阵类型。
使用的语法为type(XXX),该函数适用于tuple、list、array、ndarray、Series以及Dataframe等多种类型。
print(type(df))
#输出 class 'pandas.core.frame.DataFrame'这是DataFrame类型的数据
print(type(Array))
#输出class 'numpy.ndarray'这是多维数组
print(type(tuple(Array)))
#输出'tuple'这是元组
print(type(list(df['a'])))
#输出'class list'这是一个list类型
此外,还需查看数据的具体格式是字符串还是数字格式。
需要注意的是,Numpy和Pandas在查看数据格式时的方法略有不同:Numpy使用dtype属性,而Pandas使用dtypes属性。
print(Array.dtype)
#输出int64
print(df.dtypes)
#输出Df下所有列的数据格式 a:int64,b:int64
Python数据类型bytes
1 bytes类型的特性
在Python 3.x及之后的版本中,Python默认使用utf-8格式进行字符编码和显示。
- Python默认的字符串(string)数据类型表现为utf-8编码形式的序列。
- bytes数据类型则是以utf-8格式表示的二进制形式的不可变序列。
- bytearray数据类型同样是utf-8格式的二进制形式,但它是可变序列。
1.1 ASCII表
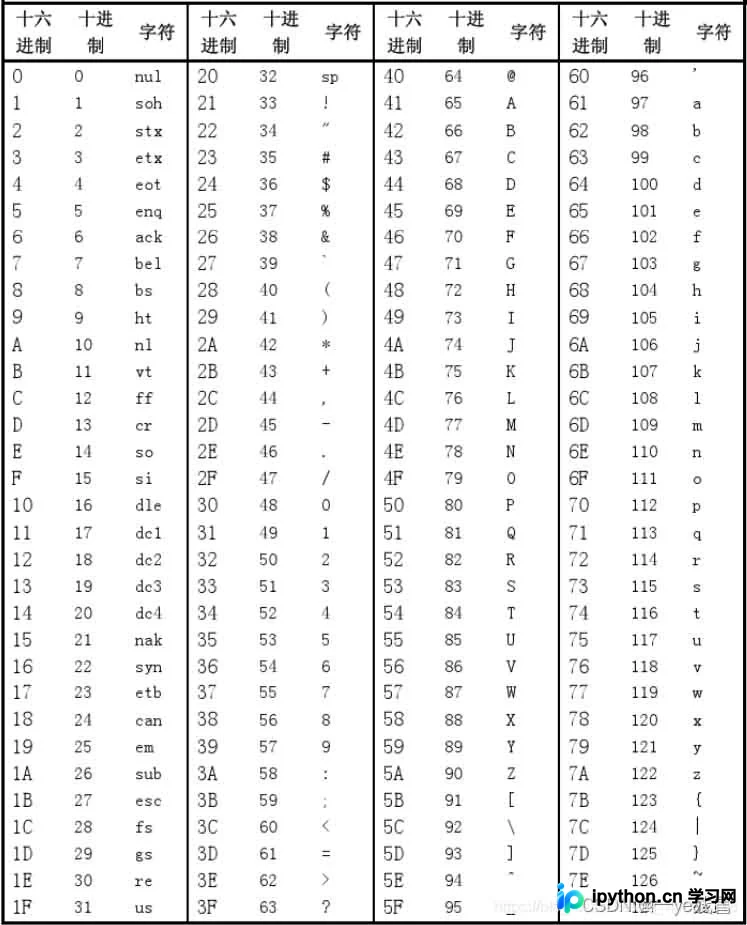
2 bytes类型创建与转化
2.1 bytes类型与数字
数字类型并不等同于字符串,因此无法直接通过数字生成对应的bytes类对象。
Python对数字类型赋予了特殊的意义,具体表现如下:
① 当入参为单个数字时,表示创建由null(\x00)组成的向量。
byte_str = bytes(10)
print(byte_str)
>>> b'\x00\x00\x00\x00\x00\x00\x00\x00\x00\x00'
② 当入参为数字序列时,会直接转换为bytes序列,且对应值保持不变。若需将数字序列直接写入底层,应使用此方法。
byte_str = bytes([1, 10, 0xF])
print(byte_str)
>>> b'\x00\x10\x0f'
③ 当二进制数据位于[33, 126]区间时,属于ASCII表中可显示字符的范围,此时会直接显示对应的字符。
数字直接使用bytes创建
byte_str = bytes([33, 48, 126])
print(byte_str)
>>> b'!0~'
2.2 bytes类型与ASCII字符
2.2.1 创建bytes数据
① 使用b''字面量方式创建。
byte_str = b'Python'
print(byte_str)
>>> b'Python'
② 使用bytes()函数创建不可变序列。
byte_str = bytes('Python', encoding='utf-8')
print(byte_str)
>>> b'Python'
③ 使用bytearray()函数创建可变序列。
byte_str = bytearray('Python', encoding='utf-8')
print(byte_str)
>>> bytearray(b'Python')
2.2.2 还原bytes数据
① 使用bytes.decode()方法还原不可变序列。
byte_str = bytes('Python', encoding='utf-8')
utf_str = bytes.decode(byte_str)
print(utf_str)
>>> 'Python'
② 使用bytearray.decode()方法还原可变序列。
byte_str = bytearray('Python', encoding='utf-8')
utf_str = bytearray.decode(byte_str)
print(utf_str)
>>> 'Python'
2.3 bytes类型与汉字
在UTF-8编码中,每个汉字占用3个Byte。
byte_str = bytes('我是', encoding='utf-8')
print(byte_str)
>>> b'\xe6\x88\x91\xe6\x98\xaf'
还原示例:
byte_str = b'\xe6\x88\x91\xe6\x98\xaf'
utf_str = bytes.decode(byte_str)
print(utf_str)
>>> '我是'
3 bytes类型切片迭代
① 通过bytes[index]方式访问时,返回的是底层int类型。
byte_str = b'a'
print(type(byte_str[0]))
print(byte_str[0])
>>> <class 'int'>
>>> 97
byte_str = b'abc'
print(type(byte_str[2]))
print(byte_str[2])
>>> <class 'int'>
>>> 99② 通过for ... in bytes方式遍历循环时,返回的也是底层int类型。
byte_str = b'abc'
for byte in byte_str:
    print(type(byte))
    print(byte)

>>> <class 'int'>
>>> 97
>>> <class 'int'>
>>> 98
>>> <class 'int'>
>>> 99
③ 通过bytes[start:end]方式进行切片时,返回的是底层bytes类型。
byte_str = b'a'
print(type(byte_str[:]))
print(byte_str[:])
>>> <class 'bytes'>
>>> b'a'
以上为个人经验总结,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















