Python列表推导式进阶实战:从基础语法到复杂嵌套应用
本文深入解析Python列表推导式的语法规范与执行效率,通过涵盖数字筛选、水仙花数、矩阵转置、勾股数生成及随机密码等20余个实战案例,展示一维至多层嵌套推导式的灵活应用。内容涵盖基础语法、内置函数优化及复杂逻辑处理,旨在帮助开发者掌握简洁高效的Python编程技巧。
2026-10-16
0



本文深入解析Python列表推导式的语法规范与执行效率,通过涵盖数字筛选、水仙花数、矩阵转置、勾股数生成及随机密码等20余个实战案例,展示一维至多层嵌套推导式的灵活应用。内容涵盖基础语法、内置函数优化及复杂逻辑处理,旨在帮助开发者掌握简洁高效的Python编程技巧。
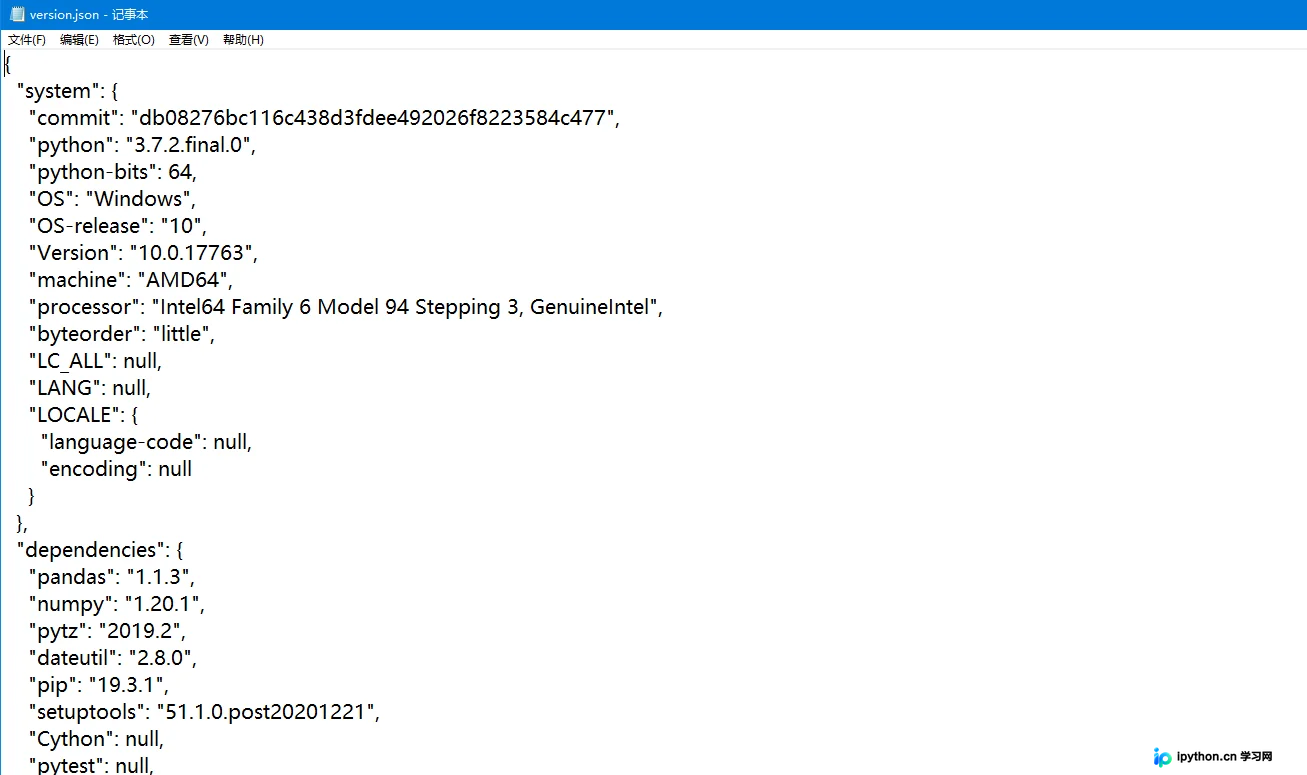
本文深入解析pandas中查看库版本及依赖信息的四个核心API:__version__、__git_version__、_version.get_versions()及show_versions()。通过剖析pandas._version模块与__init__.py源码,阐明版本信息的存储机制、命名空间重构过程及show_versions()在不同参数下的输出逻辑,帮助开发者理解版本检查背后的实现原理。
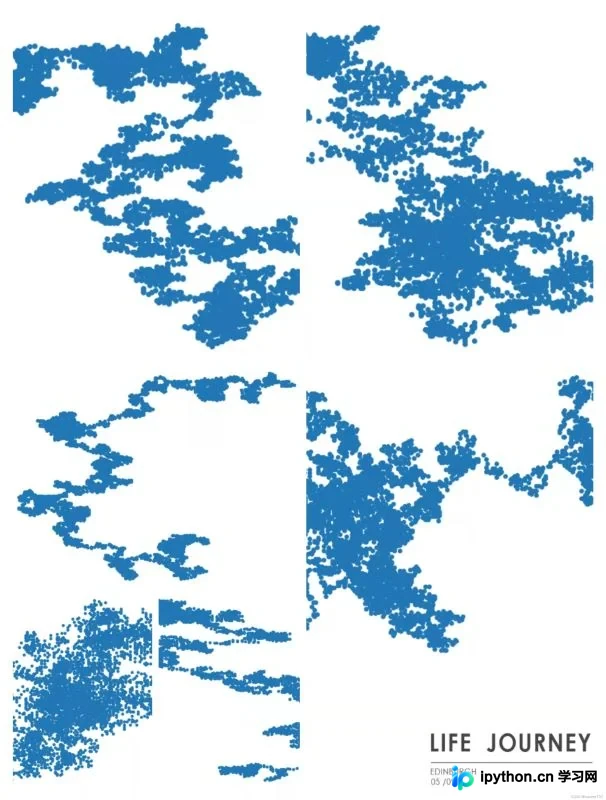
本文详细解析如何使用Python实现随机漫步模拟。通过构建RandomWalk类,利用random模块生成随机坐标,并结合Matplotlib进行可视化。内容涵盖基础路径绘制、颜色映射区分步序、高亮起点终点、增加采样点数以及调整图表尺寸以适应屏幕,提供完整的代码示例与效果说明。
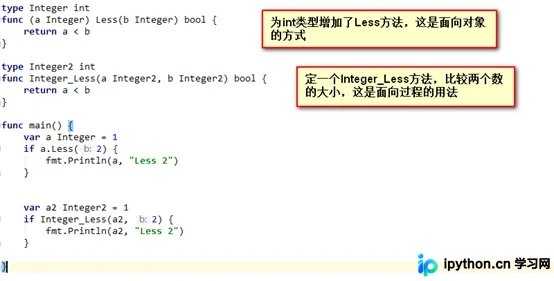
本文解析Go语言的面向对象特性,重点讲解显式接收者如何实现方法绑定,以及值语义(如struct、array)与引用语义(如slice、map、channel)的区别。通过代码示例说明传值与传指针的性能权衡,帮助开发者掌握Go中模拟OOP的核心设计逻辑。
本文详细介绍pandas中DataFrame.fillna()函数的具体用法。涵盖value、method、axis、inplace及limit等核心参数的配置,通过标量、字典填充及ffill/bfill前后向填充的实例,演示如何处理数据中的NaN值,帮助开发者高效完成数据清洗任务。
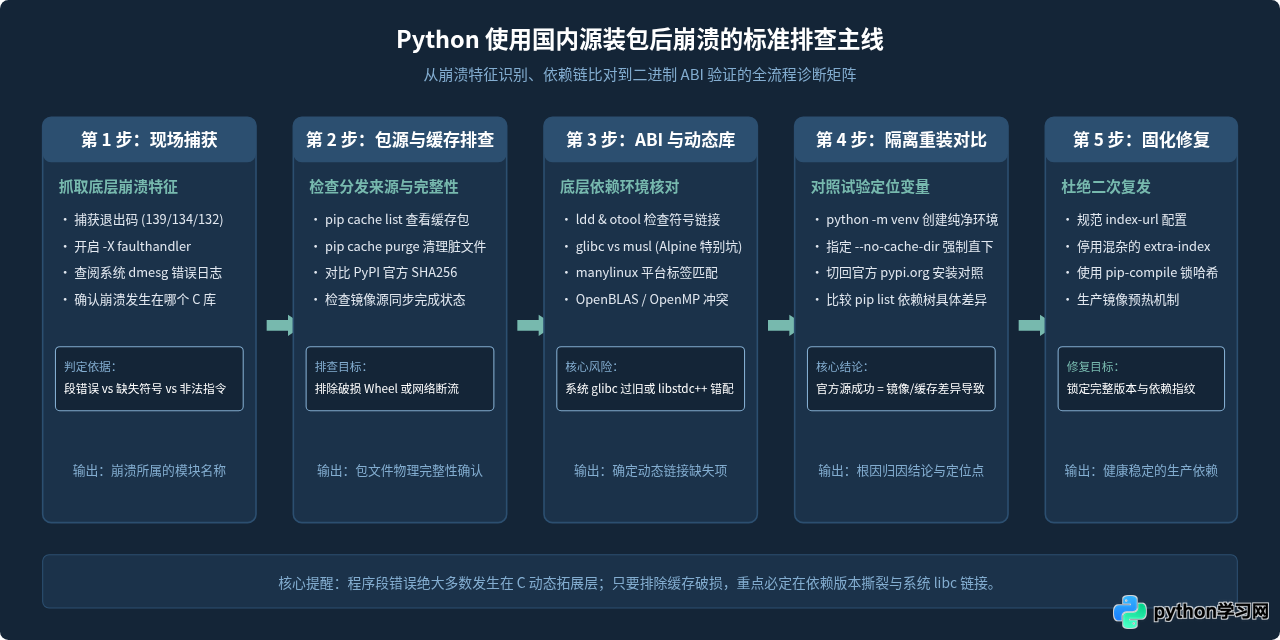
针对Python配置国内镜像源安装依赖包后引发程序崩溃(段错误、ABI冲突、动态库缺失等)的问题,提供从崩溃现场捕获、根本原因剖析到实际排查命令与长期预防的完整解决方案。
本文深入解析Go语言的结构体与方法。涵盖结构体的多种定义方式(命名、匿名、嵌套)、零值机制及比较规则;详细说明方法接收器(值与指针)的区别与应用场景;演示匿名字段带来的字段提升与继承效果,并提供代码示例帮助开发者掌握面向对象式编程模式。
本文通过矩形类示例,详细讲解Python中@property、setter和deleter装饰器的使用方法。通过封装长宽属性,实现面积自动计算与只读控制,展示如何规范编写getter、setter及deleter函数,确保属性访问的安全性与逻辑一致性。
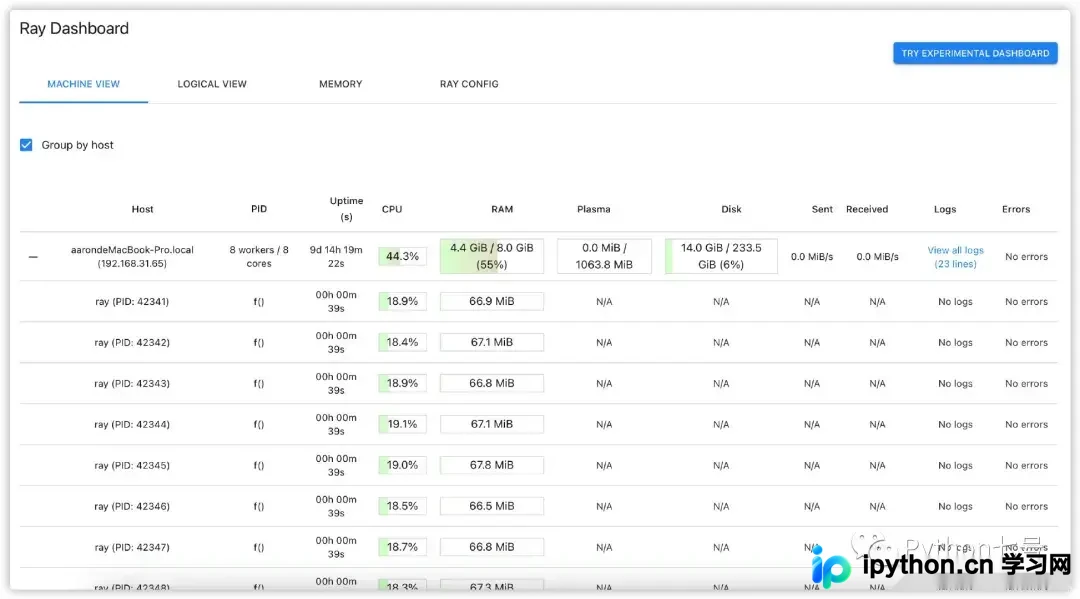
本文详细介绍如何利用Python的Ray框架实现高效分布式计算。内容涵盖Ray的核心特性、安装方法、单机分布式代码示例,以及基于Docker的多节点集群搭建与任务调度实战,帮助开发者快速掌握分布式并行处理技术。
本文详细介绍Python中列表去重的5种常见方法,包括for循环、列表推导式、set()函数、字典键值法以及删除重复数据法。重点分析各方法对原列表顺序的影响及保持顺序的解决方案,并附带NumPy二维数组去重示例,帮助开发者根据实际需求选择最优方案。
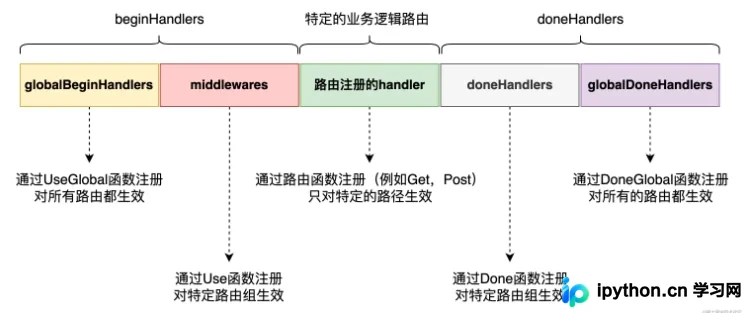
深入解析Go语言三大主流Web框架(Gin、Iris、Echo)中中间件的运行机制。通过对比底层源码,揭示切片遍历与函数包装两种核心模式的差异,帮助开发者理解ctx.Next()的作用及请求链的执行顺序,从而更优雅地实现日志、鉴权等通用逻辑。
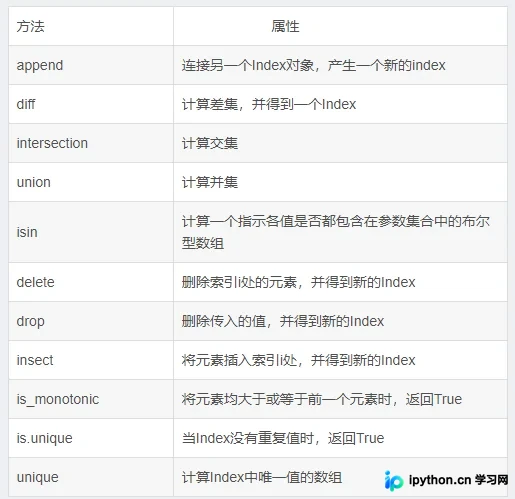
本文深入解析 Python Pandas 库中的三大核心数据结构:Series、DataFrame 和 Panel。详细讲解 Series 的一维数组特性、索引与标签的双重访问机制,以及基于字典和列表的创建方法。同时阐述 DataFrame 的表格型结构、列对齐与缺失值处理,并介绍 Index 对象的不可变性与常用属性查看方法,帮助开发者掌握 Pandas 数据处理基础。