MySQL存储过程使用临时表返回结果集
本文介绍在MySQL存储过程中利用临时表处理复杂逻辑并返回结果集的方法。文章指出MySQL中游标的性能劣势及动态SQL拼接的臃肿问题,通过创建临时表、声明变量、使用游标遍历数据源,并结合预处理语句(Prepare/Execute)按条件聚合统计业务指标。最终将汇总数据插入临时表,并通过再次执行动态查询从该表提取结果集返回给客户端,同时提供了代码示例和注意事项。
2026-10-16
0



本文介绍在MySQL存储过程中利用临时表处理复杂逻辑并返回结果集的方法。文章指出MySQL中游标的性能劣势及动态SQL拼接的臃肿问题,通过创建临时表、声明变量、使用游标遍历数据源,并结合预处理语句(Prepare/Execute)按条件聚合统计业务指标。最终将汇总数据插入临时表,并通过再次执行动态查询从该表提取结果集返回给客户端,同时提供了代码示例和注意事项。
本文详解Python中读取二进制文件的方法。通过open函数的rb模式获取字节对象,解释其与字符串的区别。介绍使用ZipFile等库处理特定格式,并深入讲解利用hashlib模块计算SHA-256校验和。针对大文件,演示如何分块读取以节省内存,并展示Python 3.8引入的海象运算符在循环读取中的应用。
本文详细解析 Rust 中的文件读写与目录管理。涵盖 std::path 模块处理跨平台路径(PathBuf 与 Path);使用 std::fs 进行文件与目录的创建、删除;以及利用 std::io 的 Read/Write Trait 实现精准的文件内容读取、写入和流控制,提供实用代码示例。
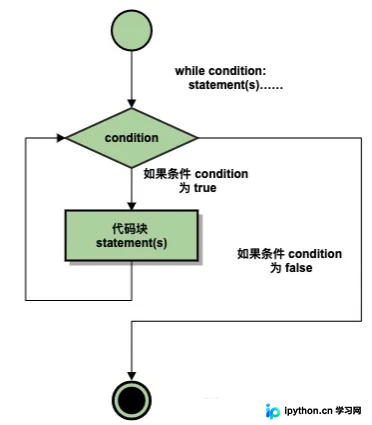
本文详细讲解Python中while循环的用法,包括基本语法结构、执行流程图及缩进规范。通过计算1到100总和的实例展示标准用法,并介绍如何实现无限循环及其在服务器实时请求中的应用。此外,还解析了while循环配合else语句的执行逻辑,以及简单语句组的写法,最后提供两个练习题以巩固知识。
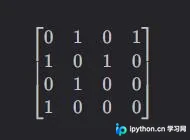
本文介绍如何使用Python将包含节点对的两列Excel或CSV文件转换为邻接矩阵,并进一步将其转化为COO(坐标)格式。文中提供了基于numpy和pandas的完整代码示例,详细解析了无权无向图的对称性处理、节点索引从0开始的规则,以及PyG中COO格式形状的计算逻辑,适用于复杂网络运算和图神经网络预处理。
在Golang因不支持函数重载而面临多参数构造难题时,函数式选项模式提供了一种优雅的解决方案。通过定义Option类型和With系列构造函数,利用闭包可变对象状态。该模式相比传统Config对象或Builder模式,代码更整洁、支持任意顺序传参且具备极佳的向后兼容性,非常适合处理复杂服务的可选配置场景。
本文介绍Python中打印字典Key与Value的基础方法,并针对一道面试题:如何获取字典中Value最大的值并打印其Key-Value对,提供了五种不同的实现方案。涵盖基础遍历、max函数、map高阶函数及排序技巧,适用于Python 3.6.8及以上版本,帮助开发者掌握字典操作的核心语法。
本文介绍如何在客户端使用 JavaScript 实现 XSL(可扩展样式表语言)将 XML 转换为 HTML。通过构建 Microsoft.XMLDOM 对象分别加载 XML 和 XSL 文件,利用 transformNode 方法进行本地转换并输出结果。该方法适用于支持 IE ActiveX 环境的浏览器,解决了部分不支持原生 XML 解析的显示问题。
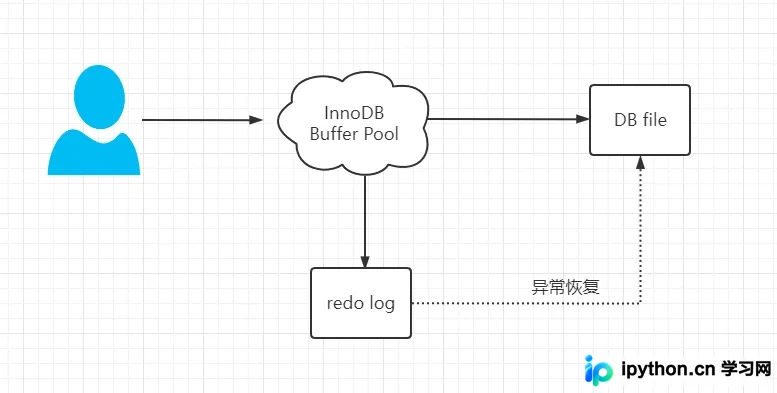
本文深入解析 MySQL InnoDB 引擎中的 redo log 与 binlog。两者分别属于引擎层和服务层,前者用于保证事务持久性(WAL),后者用于主从复制和数据恢复。通过对比物理日志与逻辑日志的差异,并结合示例详细讲解事务执行时的“两阶段提交”机制,帮助读者理解 MySQL 如何确保数据一致性与安全性。
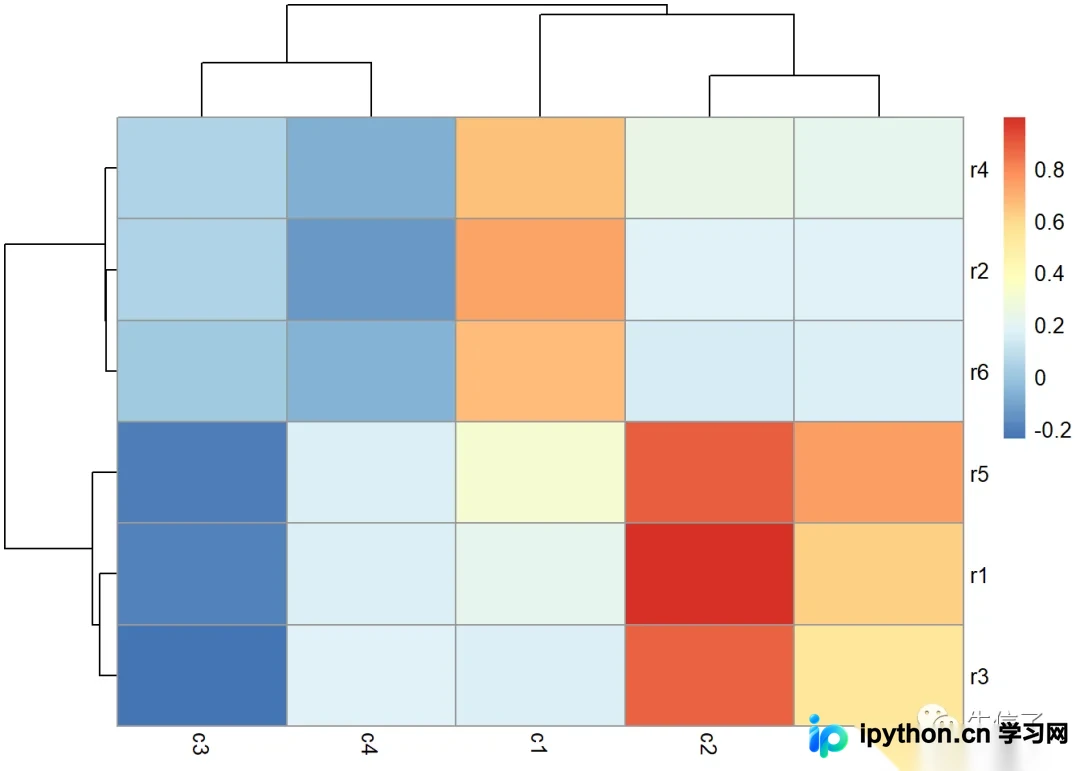
本文介绍在R语言中利用psych和pheatmap包计算两组变量间的Pearson相关系数,并绘制带聚类、数值显示及显著性标记的热图。通过调整参数可实现仅列聚类、自定义标题及不同聚类算法,适用于探索多维数据间的相关关系。
本文介绍JavaScript中的函数式编程思想,涵盖匿名函数、柯里化(Currying)和高阶函数的核心概念。通过map、adder等代码示例,展示如何利用闭包、函数作为一等公民的特性实现优雅的数据处理与逻辑抽象,帮助开发者摆脱传统的命令式编程思维,提升代码复用性与可维护性。
XML擅长数据存储但缺乏显示能力。本文详解利用XSLT(XSL Transformation)技术将原始XML数据转换为HTML页面的完整流程。通过DOM解析构建结果树,并应用格式化规则,实现数据与显示的完美分离,让杂乱的数据瞬间变得美观易读。



