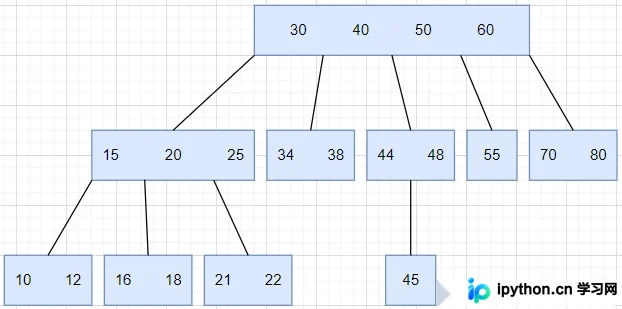
MySQL 分页查询实现指南:从原理到8种优化方案
本文详解 MySQL 分页查询的核心原理,对比真分页与假分页的适用场景。重点讲解 LIMIT 参数的计算逻辑及总页数公式,并总结 8 种常见分页 SQL 写法。针对数据量增长带来的性能瓶颈,提供基于索引定位、子查询等高效优化方案,帮助开发者在实际项目中实现快速、稳定的分页功能。
2026-10-15
0



本文详解 MySQL 分页查询的核心原理,对比真分页与假分页的适用场景。重点讲解 LIMIT 参数的计算逻辑及总页数公式,并总结 8 种常见分页 SQL 写法。针对数据量增长带来的性能瓶颈,提供基于索引定位、子查询等高效优化方案,帮助开发者在实际项目中实现快速、稳定的分页功能。
面对日均百万级增长的 MySQL 日志表,本文对比了老数据归档、应用层分表及迁移至 TiDB 三种方案。重点复盘迁移 TiDB 过程中遇到的主键冲突难题,并分享基于 Redis 状态记录的断点续传同步脚本设计,实现平滑迁移且避免线上阻塞。
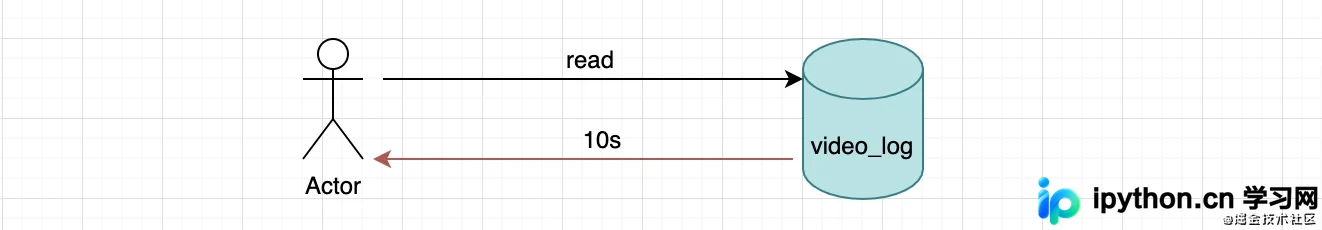
本文详细解析MySQL主从复制中实现数据过滤的两种核心思路。重点讲解为何推荐在从库而非主库进行过滤,并通过CHANGE REPLICATION FILTER命令展示具体的过滤配置步骤(包括库级与表级过滤)。同时提供GTID模式下解决因表结构不一致导致的SQL线程报错及自动恢复方案。
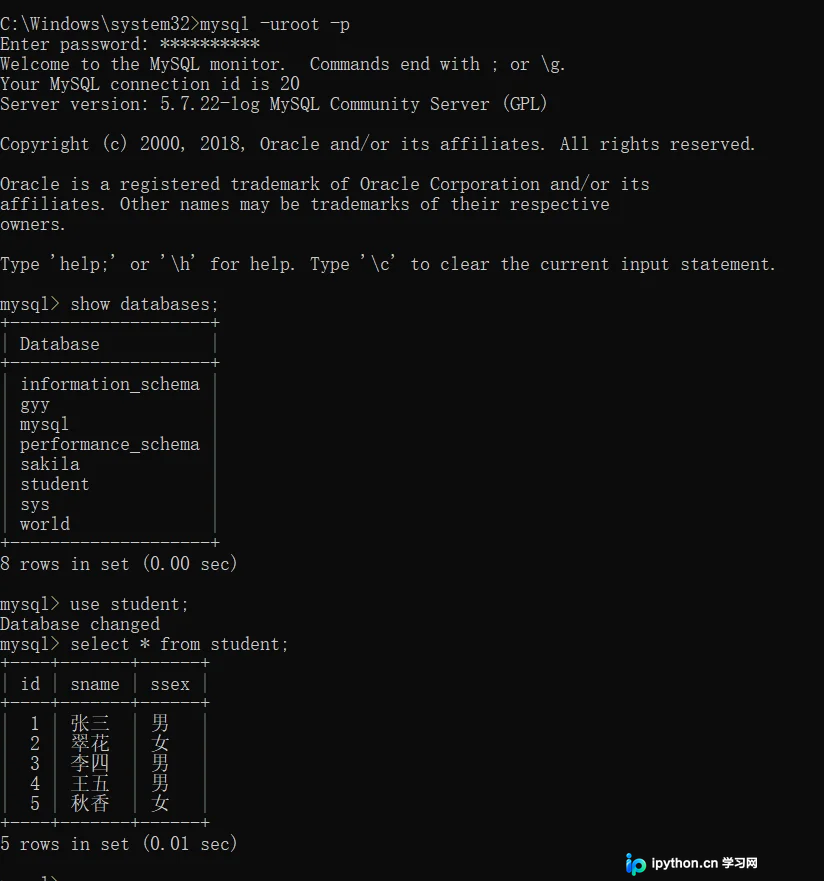
本文详细讲解MySQL数据库的备份与还原方法。首先介绍mysqldump工具的使用,通过命令行将指定数据库导出为SQL文件;随后演示如何删除库并新建同名库,利用source命令在MySQL客户端内完成数据导入,确保业务数据的安全性与可恢复性。
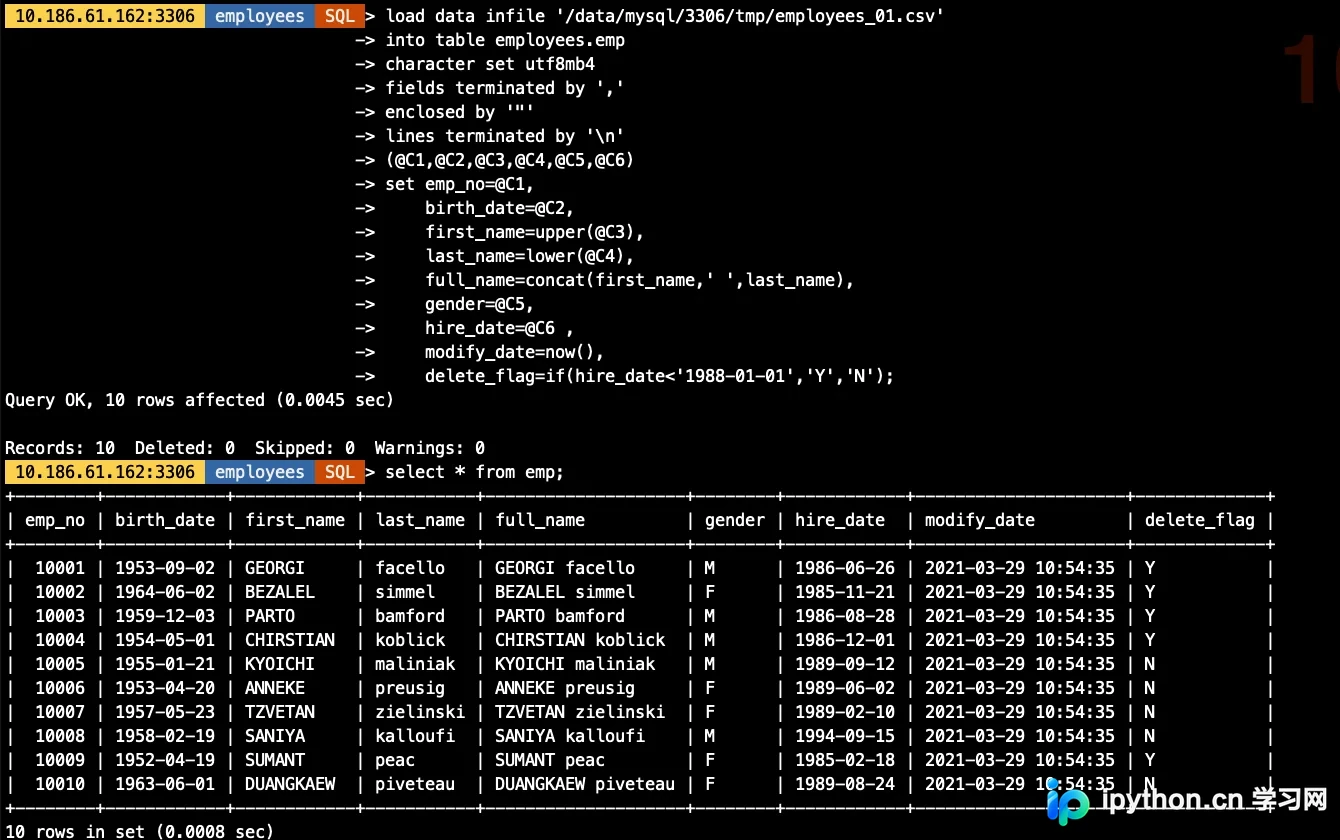
本文详解MySQL Shell中Parallel Table Import Utility(import_table)的使用。该工具支持8.0.23及以上版本,具备并发导入、多文件通配符匹配、限速及压缩文件处理等核心功能。通过具体代码示例,展示如何利用decodeColumns实现字段映射、函数处理及逻辑判断,并与传统LOAD DATA INFILE进行性能对比,证明其在大数据量导入场景下的显著效率优势。
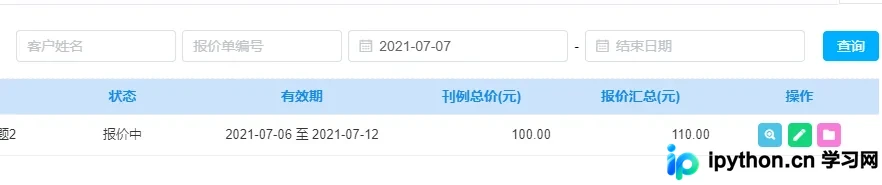
本文解决如何在MySQL中筛选“进行中”状态的数据,核心在于处理开始或结束时间可能为空的情况。通过 `IS NULL` 结合 `NOW()` 函数,实现四种时间边界条件的统一查询。同时提供MyBatis动态SQL的XML配置示例,确保参数灵活传入时逻辑依然准确。
本文详细对比MySQL常用存储引擎InnoDB与MyISAM的核心特性。重点分析两者在并发控制(行锁vs表锁)、事务支持、外键约束及索引类型上的差异,帮助开发者根据业务场景选择最适合的存储引擎以优化数据库性能。
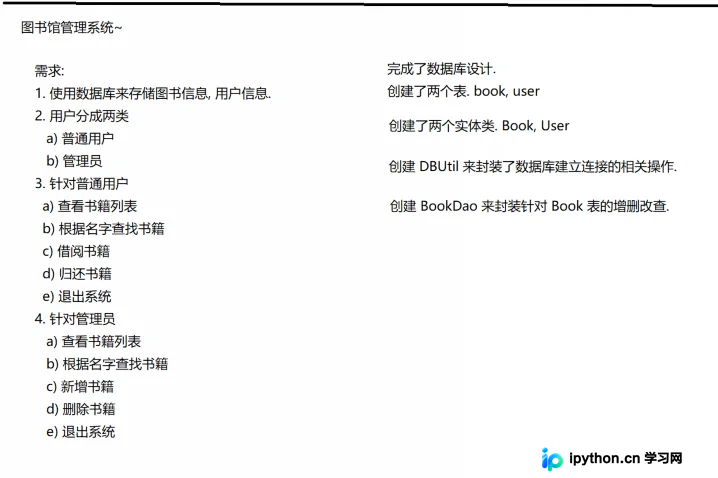
本文通过构建一个简易的 Java 图书管理系统,演示如何使用 MySQL 存储数据及 JDBC 进行数据库交互。文章涵盖数据库建表、实体类设计、DAO 数据访问层封装以及用户角色权限控制(普通用户与管理员)的核心逻辑,帮助开发者掌握 JDBC 基础语法与面向对象编程在持久层的应用。
本文深入解析MySQL分库分表的三种核心策略:RANGE范围划分、HASH取模及一致性Hash算法。通过对比各方法的优劣,重点阐述一致性Hash配合虚拟节点如何解决数据倾斜与扩容难题,并提供Java单元测试代码验证路由逻辑,助力高并发场景下的数据库架构设计。
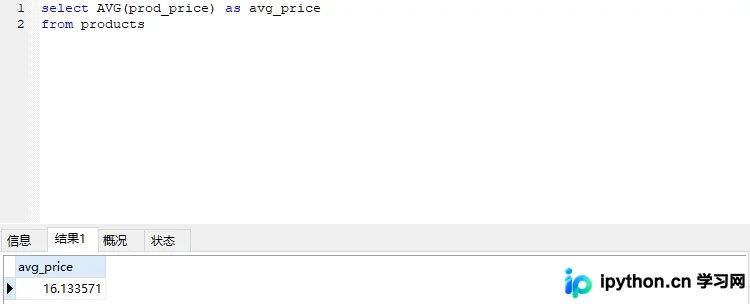
本文详解 MySQL 中如何实现不检索实际数据而是直接进行统计分析。介绍 AVG、COUNT、SUM 等聚合函数的使用方法,重点解析 GROUP BY 子句的嵌套规则、NULL 值处理以及与 HAVING 的区别。结合 ROLLUP 和 ORDER BY 提供完整的分组统计操作示例,帮助开发者快速掌握复杂报表生成的 SQL 编写技巧。
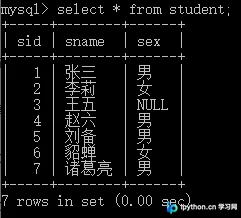
本文详细解析MySQL数据操纵语言(DML)的核心操作,涵盖INSERT多方式插入数据、基于WHERE条件的UPDATE更新及DELETE删除技巧。重点对比TRUNCATE与DELETE在清空表时的性能差异与底层机制,并提供表结构复制的SQL实例,帮助开发者掌握高效且安全的数据管理方法。
本文详解MySQL索引的核心原理与作用,对比B+树相较于二叉树、哈希表的优势,说明其减少磁盘IO的逻辑。同时解析事务的ACID特性(原子性、一致性、持久性、隔离性)及其在数据一致性中的关键作用,提供索引查看/创建/删除及事务提交回滚的常用SQL命令。