


MySQL主从复制过滤策略详解:原理、操作与故障恢复

针对MySQL主从架构中需要差异化同步数据的场景,分析在主库和从库实施过滤复制的优劣。详细说明基于从库SQL线程使用`CHANGE REPLICATION FILTER`进行精细化控制的操作方法,以及应对常见同步中断错误的修复技巧。
MySQL过滤复制的基本思路
在MySQL主从复制体系中,如果需要根据特定条件(如只同步某些业务库或忽略某些大表)对同步数据进行过滤,主要有两种实现路径:
- 主库端过滤:在主节点的Binlog生成阶段进行拦截,仅记录符合条件的SQL到二进制日志中。
- 从库端过滤:在从节点的SQL回放阶段(通过IO线程拉取后,在SQL线程执行前)对Event进行判断,不符合条件的直接丢弃。
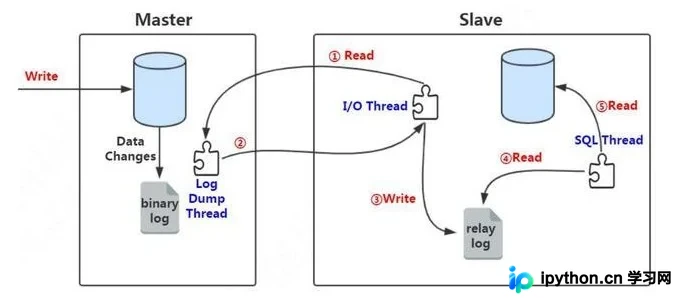
最佳实践原则是优先保证Binlog的完整性。Binlog不仅是给从库同步用的,往往也是主库自身故障恢复的关键依据。若在主库进行过滤导致Binlog记录不全,一旦主库宕机且未完全同步,将从无法通过Binlog完整重建数据。因此,生产环境中建议尽量不在主库配置过滤,所有过滤规则应统一配置在从库上。
从库端过滤的具体实现
在从库端可以通过修改复制过滤器来指定哪些数据库或表会被回放。在现代MySQL版本(支持GTID模式)中,推荐使用动态变更的方式,无需重启服务即可生效。
第1步:查看当前过滤状态
在执行变更前,先了解当前的复制状态,确定是否需要停止SQL线程。
SHOW SLAVE STATUS\G第2步:配置过滤规则
通过 CHANGE REPLICATION FILTER 语句重新定义过滤条件。以下是常用参数说明:
REPLICATE_DO_DB:白名单,仅同步指定的数据库。REPLICATE_IGNORE_DB:黑名单,不同步指定的数据库。REPLICATE_DO_TABLE:精确指定需同步的表(格式:db_name.table_name)。REPLICATE_IGNORE_TABLE:指定不需要同步的表。REPLICATE_WILD_DO_TABLE:支持通配符匹配表名进行同步。REPLICATE_REWRITE_DB:将源库的某个数据库名重写为另一个库名存储(格式:((source_db, target_db)))。
以下为具体的操作语法:
CHANGE REPLICATION FILTER filter[, filter][, ...];

filter: {
    REPLICATE_DO_DB = (db_list)
  | REPLICATE_IGNORE_DB = (db_list)
  | REPLICATE_DO_TABLE = (tbl_list)
  | REPLICATE_IGNORE_TABLE = (tbl_list)
  | REPLICATE_WILD_DO_TABLE = (wild_tbl_list)
  | REPLICATE_WILD_IGNORE_TABLE = (wild_tbl_list)
  | REPLICATE_REWRITE_DB = (db_pair_list)
}
第3步:应用并启动同步
配置完成后,通常需要重新启动SQL线程以使配置即时生效(部分版本可能需重启slave整体,视具体版本而定,常规做法如下):
# 停止从库SQL线程
stop slave sql_thread;

# 例如:设置只复制名为 'target_db' 的数据库
change replication filter replicate_do_db=('target_db');

# 重新启动SQL线程
start slave sql_thread;
第4步:取消或重置过滤规则
如果需要恢复全量复制或清除特定的过滤条件,只需将该参数赋值为空括号即可:
stop slave sql_thread;
change replication filter replicate_do_db=();
start slave sql_thread;
常见问题排查:处理因对象缺失导致的同步中断
启用过滤复制或因环境差异,极易出现主从表结构不一致的情况。典型的故障场景包括:
- 主库删除了表A,而从库由于被过滤从未接收过表A的DDL,导致执行DROP时从库报错退出。
- 主从原本正常,但人为在从库误删了表A,随后主库发起的DROP操作传导至从库,再次触发“表不存在”的错误。
在此类情况下,可以使用GTID事务的特性来临时跳过当前出错的事务,以恢复同步链路:
第5步:使用GTID跳过错误事务
首先通过 SHOW SLAVE STATUS 获取当前的 Last_Error 信息及对应的 GTID 位置信息。
# 1. 停止SQL线程以确保安全
stop slave sql_thread;

# 2. 手动设置下一个要执行的GTID为一个新事务
# 注意:此处假设我们需要跳过当前报错的事务序列,将其置空后提交一个空事务来填补位置
set gtid_next='94fc1fbe-b7a0-11eb-b0a0-000c2969aba1:20';  # 替换为你的实际GTID编号

# 3. 执行一个空的BEGIN...COMMIT,这将被记录为该GTID下的事务
BEGIN;
COMMIT;

# 4. 将GTID分配权交还给系统,恢复正常流转
set gtid_next=automatic;

# 5. 重新开启复制
start slave sql_thread;
此方法的本质是利用GTID机制,通过人为提交一个空事务占据了报错事务的位置,从而消除队列中的阻塞项。
以上就是关于MySQL主从过滤复制的详细配置与排错内容,更多关于数据库高可用架构的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















