PyCharm连接MySQL数据库进行查询与操作的完整指南
本文详细介绍如何在PyCharm中通过pymysql库连接MySQL数据库。内容涵盖Ubuntu服务端开启远程连接、配置用户权限,以及客户端使用pymysql建立连接、执行SQL语句、提交事务及关闭连接的完整流程,并提供基于学生成绩数据库的Python代码示例。
2026-10-15
0



本文详细介绍如何在PyCharm中通过pymysql库连接MySQL数据库。内容涵盖Ubuntu服务端开启远程连接、配置用户权限,以及客户端使用pymysql建立连接、执行SQL语句、提交事务及关闭连接的完整流程,并提供基于学生成绩数据库的Python代码示例。
本文详细解析MySQL索引失效的九种常见场景,涵盖违反最佳左前缀法则、主键插入乱序、范围查询右侧列失效、函数计算导致失效、like左模糊匹配、is not null过滤以及字符集不统一等问题。通过SQL示例和执行计划对比,帮助开发者规避性能陷阱,确保查询高效利用B+树索引。
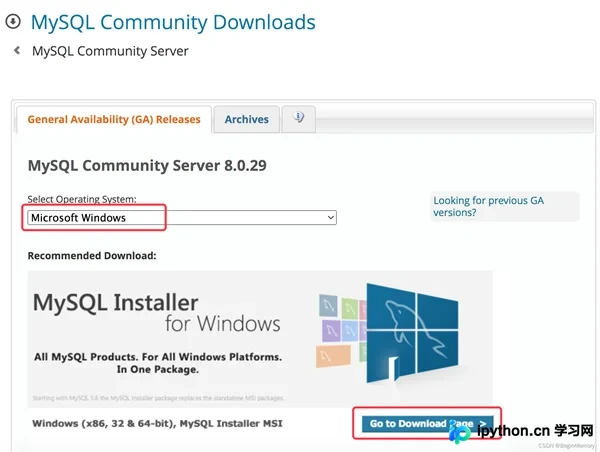
本文详细介绍在Windows环境下安装和配置 MySQL Community Server 8.0.29 的完整流程。内容涵盖从官网选择正确的离线安装包(ZIP/MSI)开始,到运行安装程序进行服务类型选择、身份验证设置、账户密码创建以及Windows服务配置的每一步操作。适用于需要在本地开发环境搭建MySQL数据库的用户,确保一次性安装成功并启动服务。
本文详细介绍在 Ubuntu 20.04 LTS 系统上安装 MySQL 8.0+ 数据库的完整流程。内容涵盖使用 apt 命令安装、设置 root 账户密码、修改 mysqld.cnf 配置文件以监听所有 IP、调整 user 表权限允许 root 远程登录,以及配置系统防火墙(ufw)和云服务器安全组放行 3306 端口,确保本地开发环境可稳定访问服务器数据库。
本文深入解析 MySQL 中 char、varchar 和 int 类型字段长度的含义。char 为定长,varchar 为变长;MySQL 5.0 后 varchar 长度指字符数而非字节。int 的长度参数仅为显示宽度(配合 zerofill 可见),不影响实际存储范围。理解这些差异有助于更精准地进行数据库表结构设计。
本文详细解析 MySQL ALTER 语法的实际应用,涵盖添加与删除索引、修改表名、增加与删除字段、更改字段类型及默认值等核心操作。通过具体 SQL 示例,帮助用户高效管理数据库表结构,提升数据维护效率。
本文详解MySQL存储过程的定义、优缺点及核心操作。涵盖IN/OUT/INOUT参数类型的设定,IF、CASE条件判断以及WHILE、REPEAT、LOOP循环逻辑的编写方法。结合具体代码演示如何在MySQL中创建并调试存储过程,最后提供MyBatis框架下的后端调用实现方案,帮助开发者高效封装SQL逻辑。
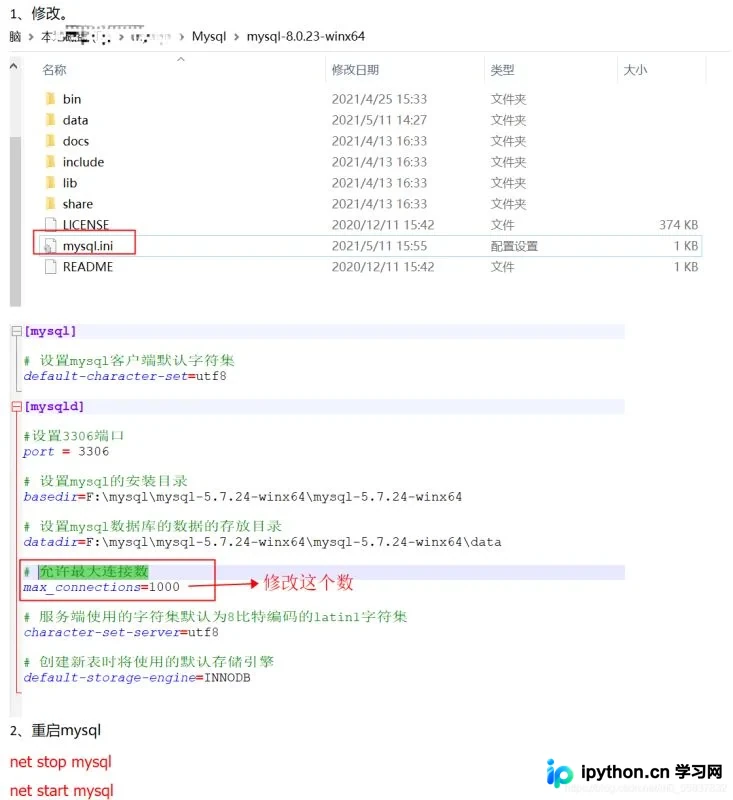
当 MySQL 出现 1040 'Too many connections' 错误时,表明当前连接数已超出服务器允许的最大限制。本文详细解析该错误的成因,并提供通过修改配置文件(my.cnf/my.ini)永久调整 max_connections 参数,以及使用 SQL 命令临时调整参数的具体操作步骤,帮助用户快速恢复服务并预防连接耗尽。
本文详细介绍在Windows和Linux环境下通过命令行将SQL备份文件导入MySQL数据库的多种方法。涵盖mysql client交互模式、重定向符导入以及Linux系统命令等多种途径,特别针对中文乱码问题给出set names utf8等关键参数建议,帮助用户快速完成数据迁移与恢复。
详细解析 MySQL 的 mysql.sock 文件及其在 Unix 平台进程间通信中的作用。当遇到本地连接失败报错 ERROR 2002 (HY000) 时,提供包括重启服务、修改配置文件以及调整 PHP/后端 socket 路径等多种排查与修复方案,确保数据库恢复稳定连接。
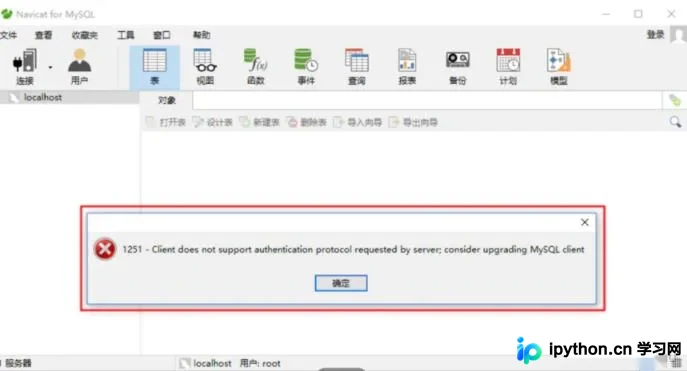
在使用 Navicat 连接 MySQL 8.0 及以上版本数据库时,常会遇到 ERROR 1251 错误。这是由于 MySQL 8 默认将密码加密规则升级为 caching_sha2_password,而旧版客户端不支持。本文通过命令行修改 root 用户的认证插件为 mysql_native_password,并刷新权限,从而快速恢复 Navicat 的正常连接。
本文详解 MySQL 数据插入的高效优化方案。针对 MyISAM引擎,重点讲解 concurrent_insert、bulk_insert_buffer_size及 load data infile 等配置与操作;针对 InnoDB 引擎,提供关闭 unique_checks、foreign_key_checks及 autocommit 的具体步骤。通过合理调整锁优先级和批量提交机制,可显著提升大数据量写入速度并降低锁竞争。



