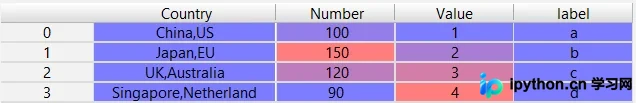
pandas实现一行拆分成多行
本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
2026-10-15
0



本文详解如何使用pandas将单行数据按分隔符拆分为多行,涵盖单列与多列拆分场景。同时介绍两种将多行数据合并回单行的方法,包括使用stack/join与explode结合groupby的方式,提供完整代码示例与效果展示。
本文介绍Python中对相同数据进行分箱处理的两种方法。首先通过手动遍历算法,将连续或分类数据按相同值分组,旨在减少全量遍历带来的IO开销并提升运行速度。其次演示利用pandas库的cut函数进行区间分箱及标签映射。内容涵盖数字与元组类型的处理逻辑,适用于需要优化遍历性能或进行数据离散化的场景。
本文详细解析Python Pandas中DataFrame的索引机制,涵盖行索引与列索引的定义及自定义方法。重点介绍通过方括号、.loc()及.iloc()进行单列、多列及特定行数据的选取技巧,区分Series与DataFrame返回类型,帮助开发者高效处理表格数据。
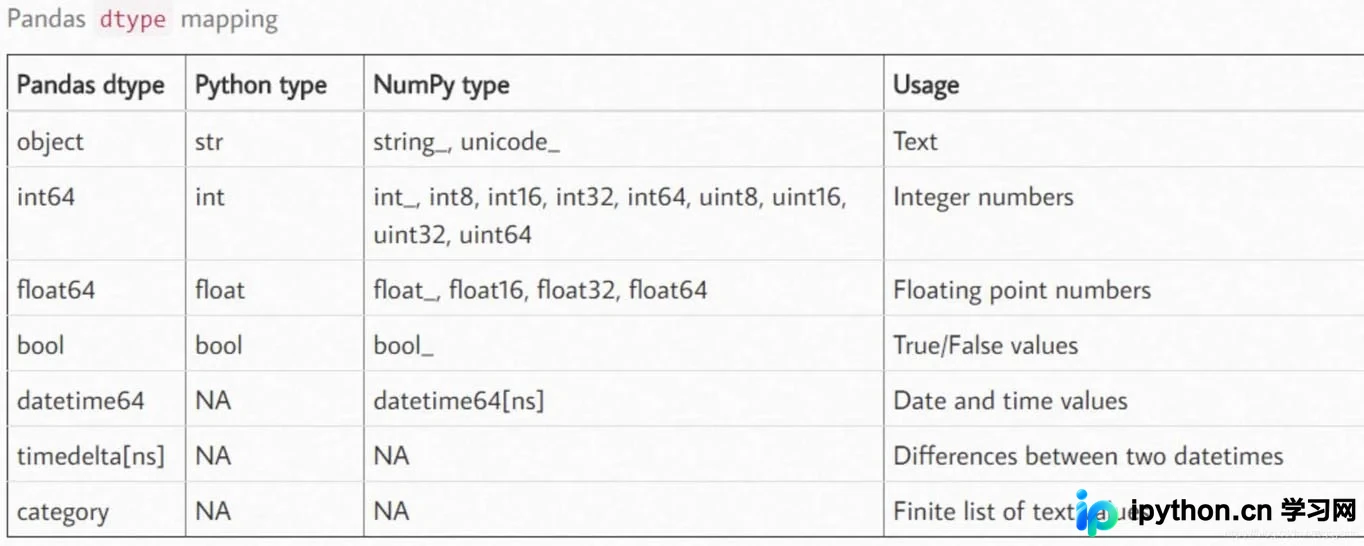
本文详细介绍Pandas中astype()函数的用法,涵盖基础类型转换、处理非标准数据格式(如含百分号的字符串)以及加载时指定类型。通过示例解析如何安全地将数值、字符串及时间类型进行转换,并指出转换失败时的处理策略,帮助开发者高效进行数据清洗。
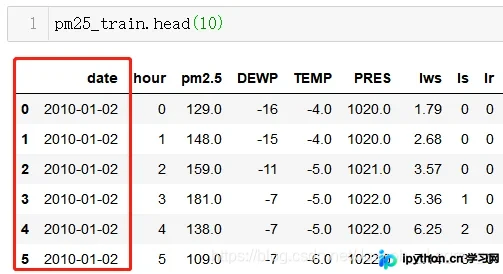
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
在R语言中,常需将连续数值转换为分类数据。本文介绍三种实现方式:使用attach/detach进行直接索引赋值;使用within()优化作用域管理;以及利用cut()函数配合breaks、labels及区间控制参数(right、include.lowest)进行高效分箱。重点解析cut函数的开闭区间逻辑及极端值处理细节。
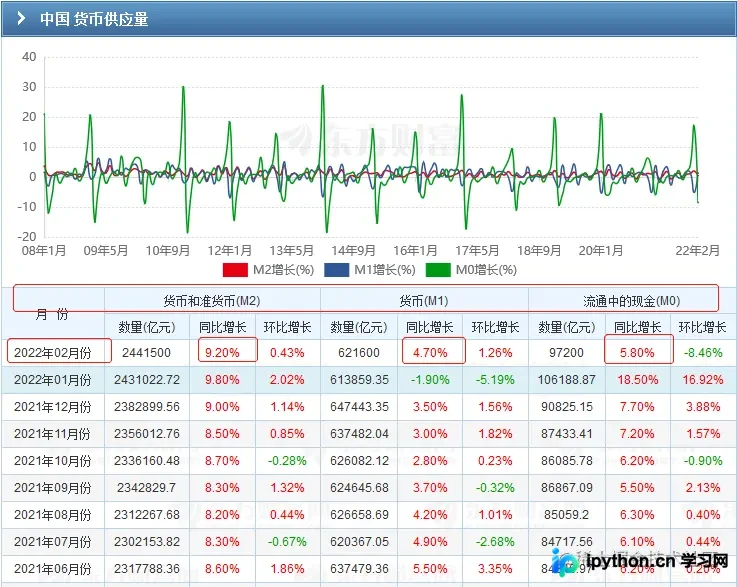
本文详解如何使用Python从东方财富网抓取M0、M1、M2货币供应量数据,并通过Matplotlib库绘制增速对比图。重点展示M1与M2的差值区间颜色填充,直观反映经济活跃度与流动性变化,适合初学者学习数据获取、处理及可视化全流程。
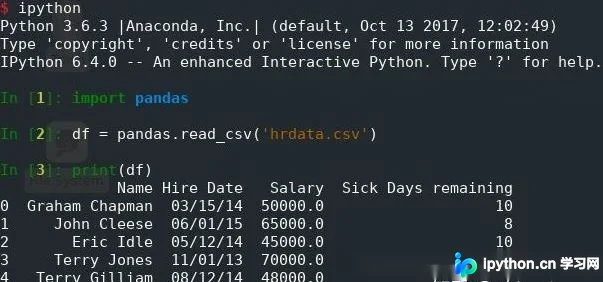
本文详细介绍如何使用 Python Pandas 库高效读取和写入 CSV 文件。涵盖基础读取方法、索引设置、日期解析、列名自定义以及数据导出等核心操作,通过具体代码示例展示 read_csv 和 to_csv 函数的关键参数用法,帮助开发者快速掌握 CSV 数据处理技巧。
本文详细解析pandas中df.groupby()方法的用法。涵盖单列与多列分组、groupby对象特性,以及describe、value_counts、sum、mean、max等常用统计函数的应用。通过具体代码示例,展示如何对数值列和离散列进行组内统计,帮助读者掌握数据分组处理的核心技巧。
本文详解Python与Matlab数据互通技巧,重点介绍SciPy库中scipy.io模块的savemat函数用法。同时系统梳理SciPy核心子模块,包括integrate数值积分、optimize优化器、interpolate插值及linalg线性代数模块,提供具体代码示例与参数说明,助力Python科学计算与数据分析。
本文详细介绍 Python 中 Pandas DataFrame 的增删改查操作。涵盖按列/行添加数据、使用 loc/iloc 选取指定行列、修改标题与数值以及删除行/列的常用方法,并解析 inplace 参数对数据修改的影响,帮助开发者高效处理结构化数据。
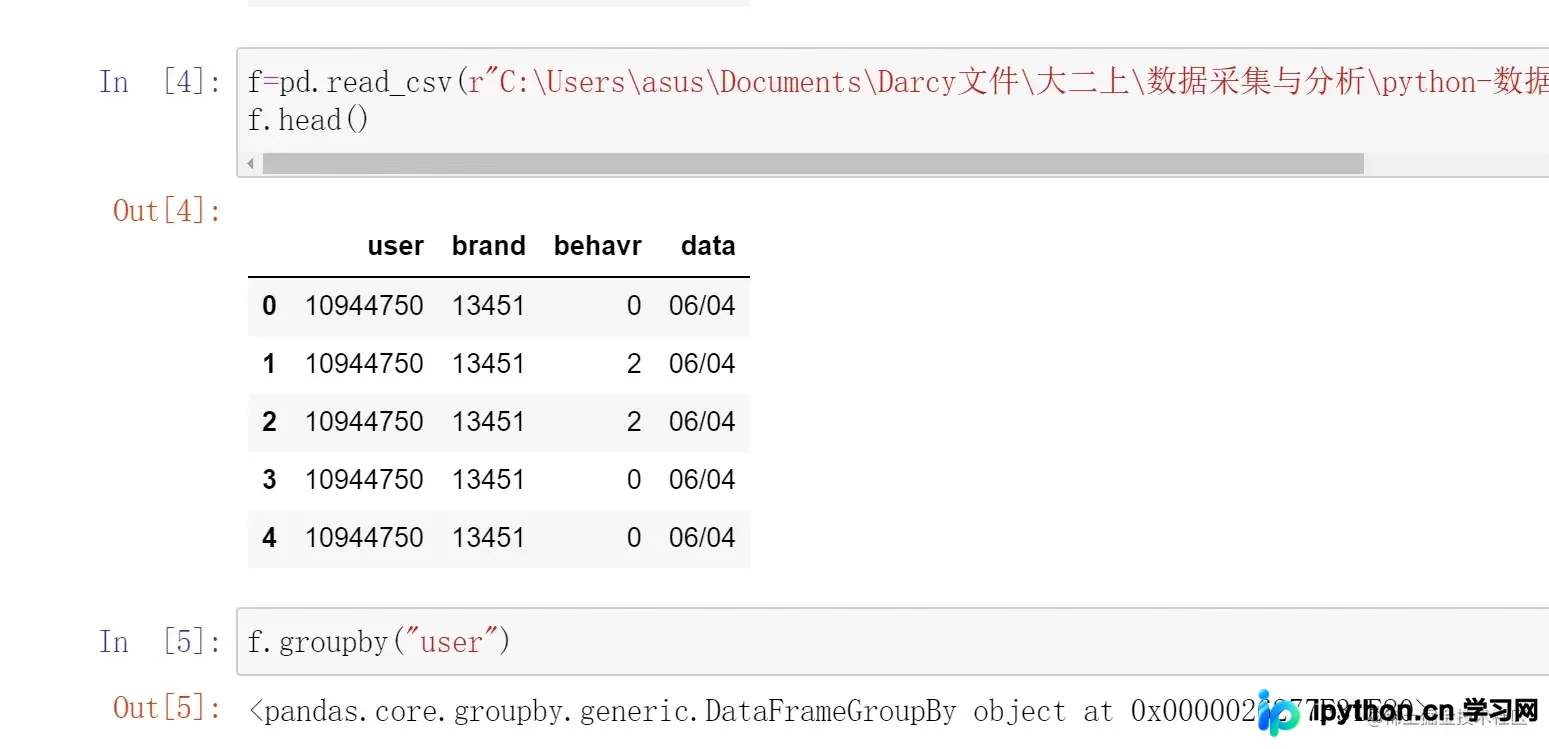
本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。