


Pandas groupby函数实战:从分组统计到转化率计算

本文详解Pandas中groupby函数的核心用法,通过电商行为数据实例,演示如何按用户或商品分组统计浏览量与购买量。重点讲解利用Series除法计算商品转化率、处理缺失值(NaN)及排序提取Top N商品的方法,帮助读者快速掌握分组聚合技巧。
正文
在处理学校课程作业时,我发现Pandas中的groupby分组函数极具实用价值。借助该函数,可以高效实现多种统计分析目标。
其操作逻辑直观且简便。
本文将以往期作业数据为例,单独探讨groupby函数能完成的具体功能。
(本期所需准备):
- Jupyter Notebook环境(Anaconda已内置)
- Pandas第三方库
- Numpy第三方库(视情况可能用到)
- 可运行上述依赖的电脑及舒适的外设
- 具备基础的Python编程知识
- 保持充足精力,携带清晰的逻辑思维继续学习
一、理解groupby机制
该函数通常作用于DataFrame对象,具有返回值且不修改原始变量,输出结果为按传入参数分组后的数据视图。
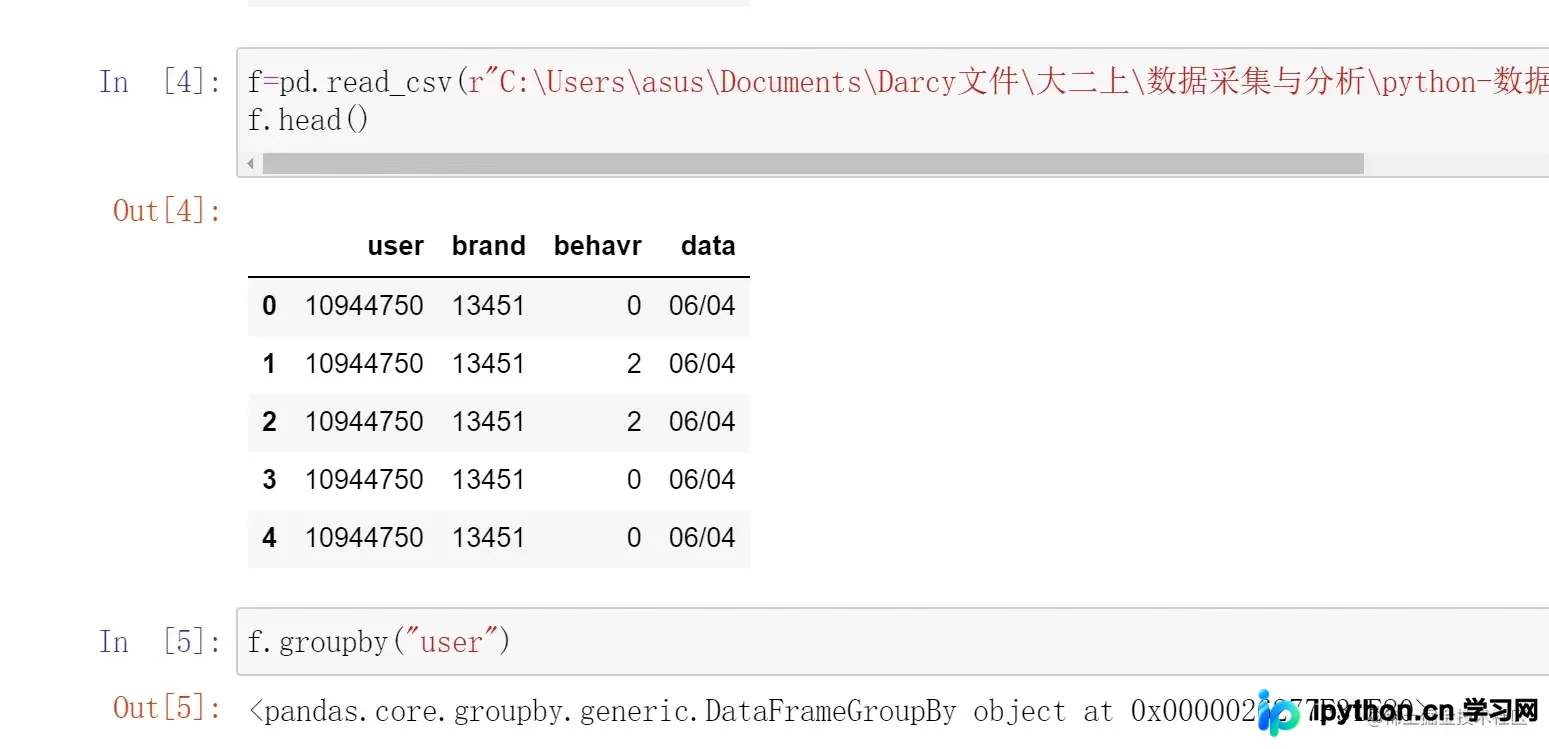
导入数据并构建DataFrame后,若按“user”字段进行分组,返回的是一个DataFrameGroupBy对象。通过遍历该对象,可观察其内部结构:
for i in f.groupby("user"):
    print(i)
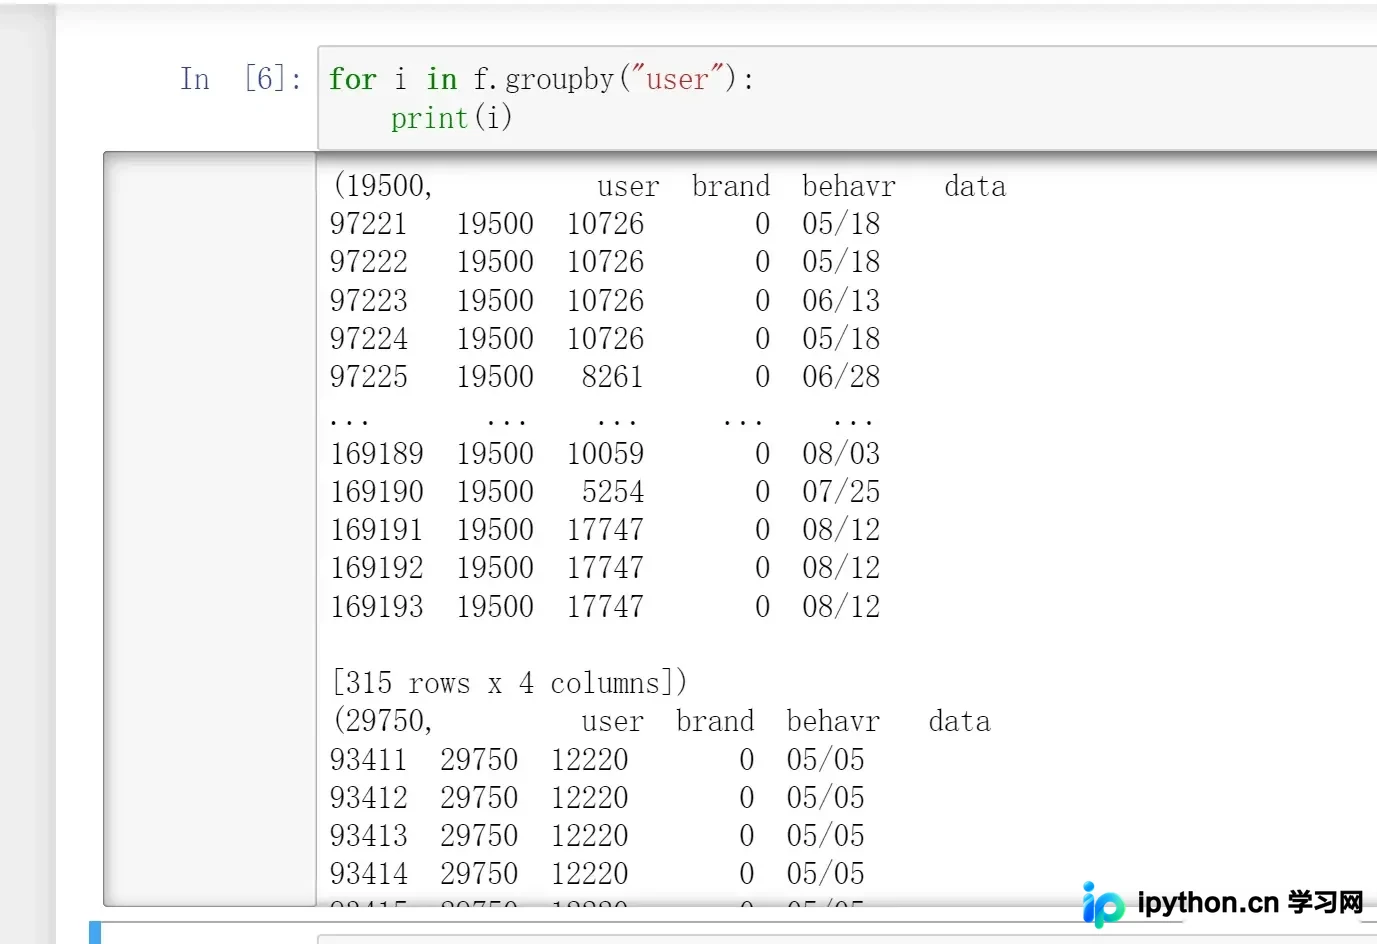
结果显示,该对象由一系列元组构成,每个元组的第一个元素为设定的分组依据值。
例如,当分组依据为user时,首个元组包含user值为19500的所有记录,元组首元素即为19500。
若输出元组的第二个元素,则得到类似DataFrame格式的数据。
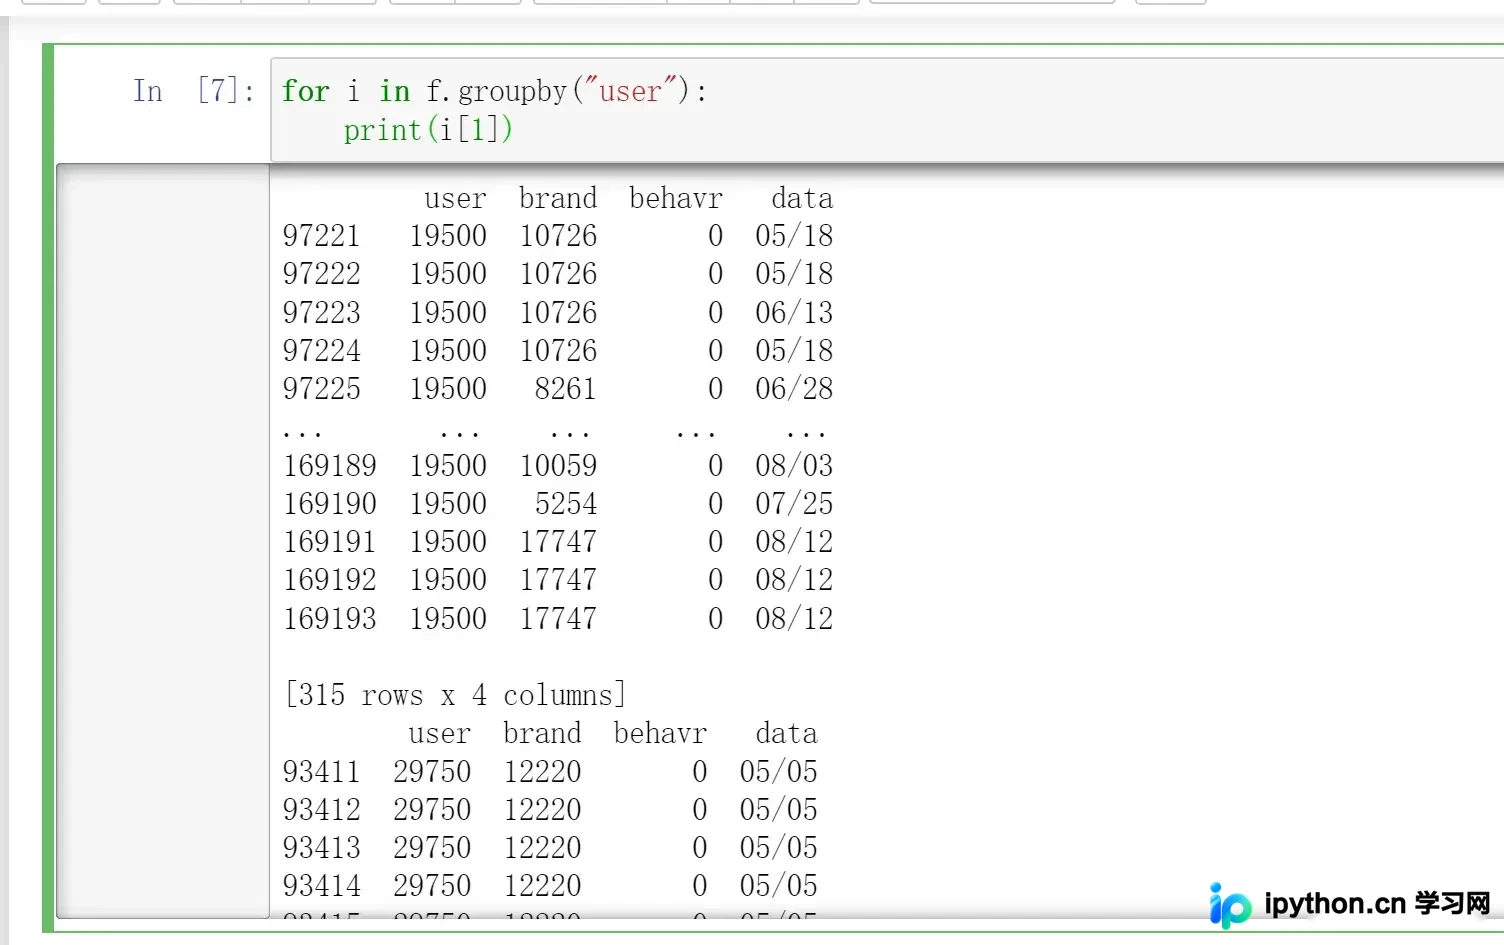
观察user列下的数据,可见其排列整齐有序。
二、数据文件说明
文中所用数据为特定时段内的消费者行为记录。其中,user代表消费者编号,brand代表品牌编号,behavr代表消费者行为类型(0表示浏览,1表示购买,2表示收藏,3表示加入购物车)。需注意,数据中可能存在未浏览直接购买的情况。
接下来将对上述数据进行处理,以输出具有分析价值的结果。
三、统计各商品购买量
由于需统计的“购买”行为对应behavr列中的特定值,思路为先通过条件筛选提取所有购买记录,再使用groupby按商品分类,最后调用size()方法统计每组数量,从而得出各商品的购买总量。
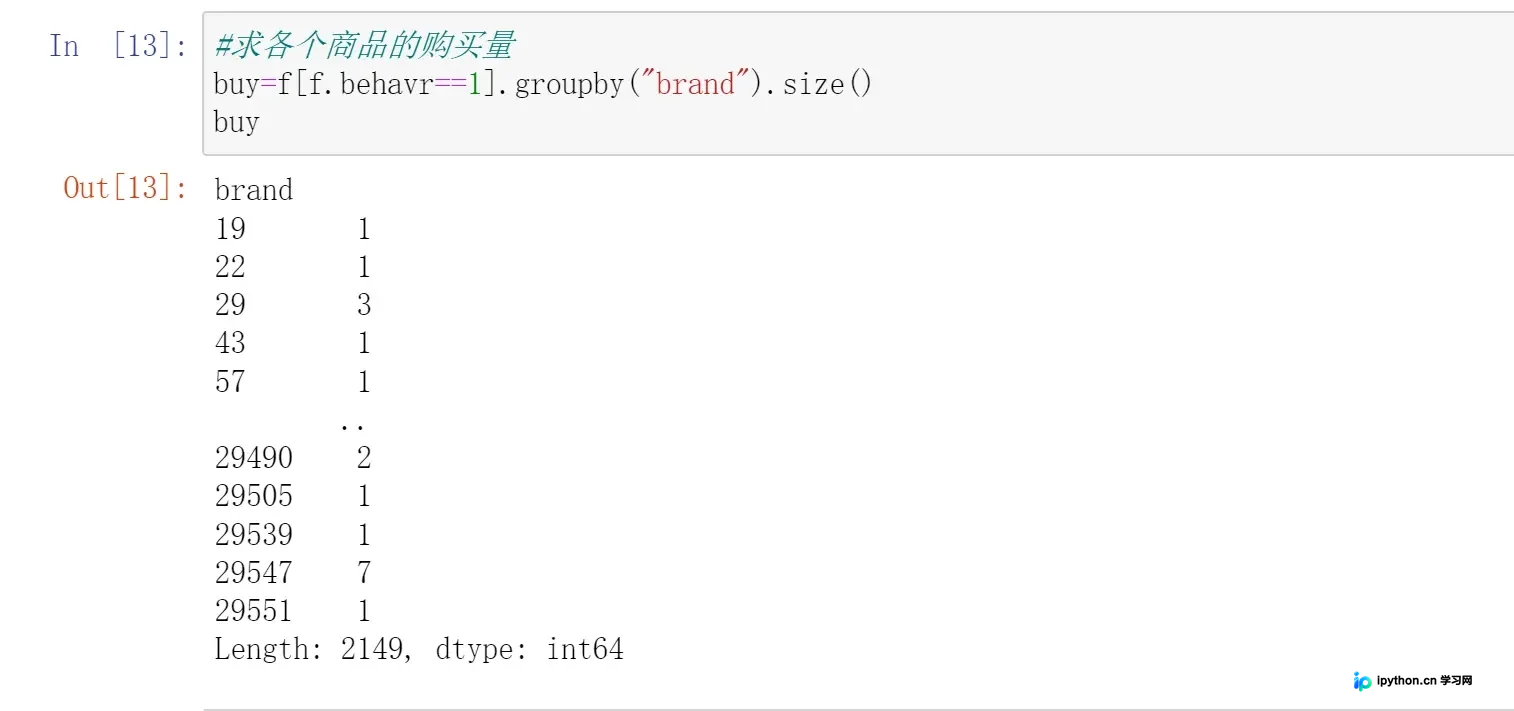
掌握此方法后,可举一反三:计算各商品浏览量。
建议先自行思考,再向下查阅。
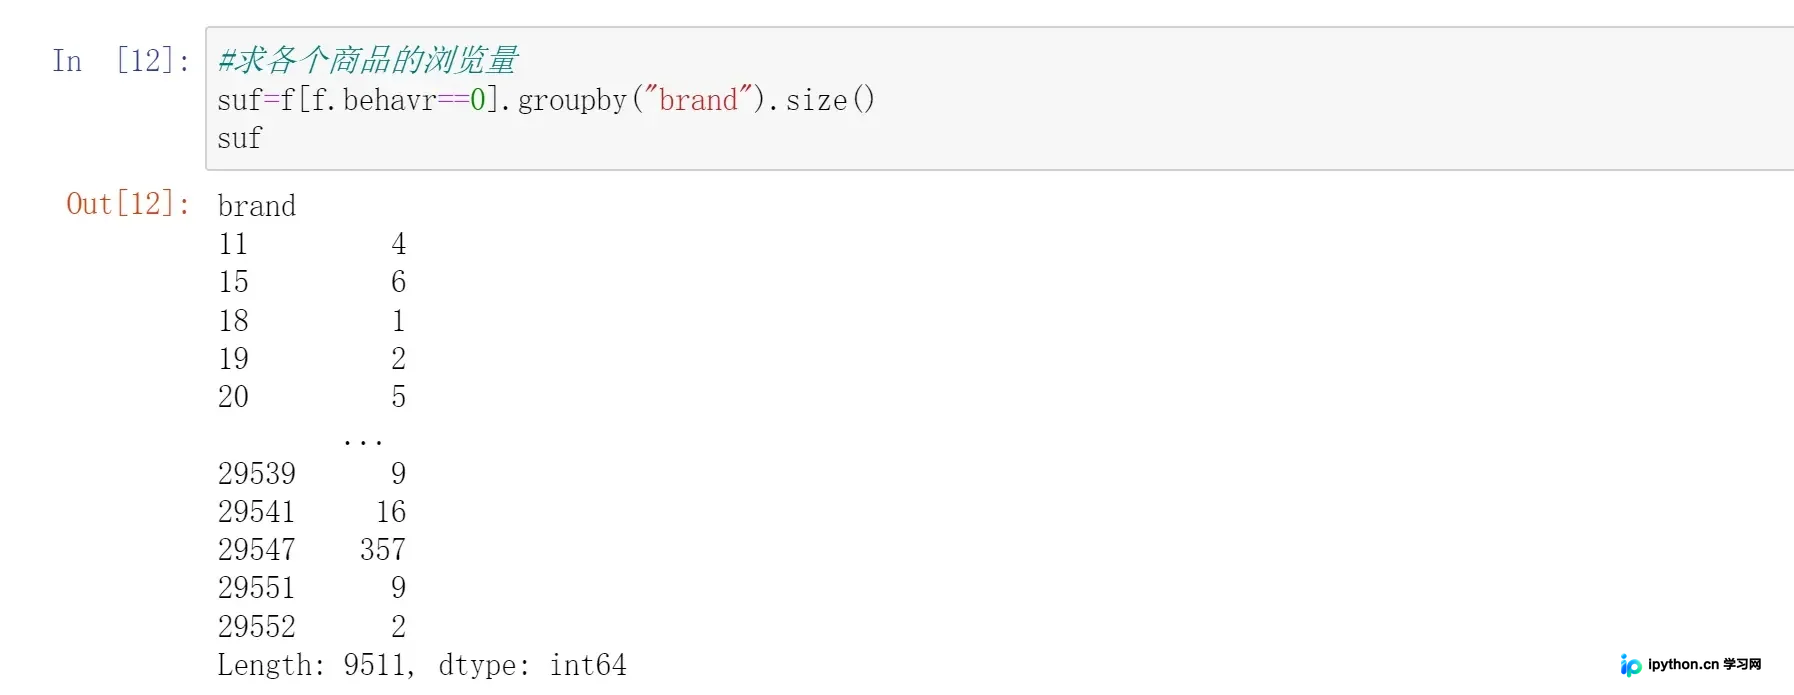
实现方式相同,仅需调整初始条件过滤的数值,将代表购买的1改为代表浏览的0即可。
四、计算各商品转化率
商业数据分析中常涉及转化率指标,即购买数量与浏览数量的比值,以此评估商品吸引力。
鉴于前文已计算出各商品的浏览量与购买量,只需进行比值运算即可。
Pandas的Series运算机制恰好满足需求,它会根据键值对分别执行计算。
该Series中user名为键,数量为值,完全符合Series计算设定,直接进行除法运算即可。
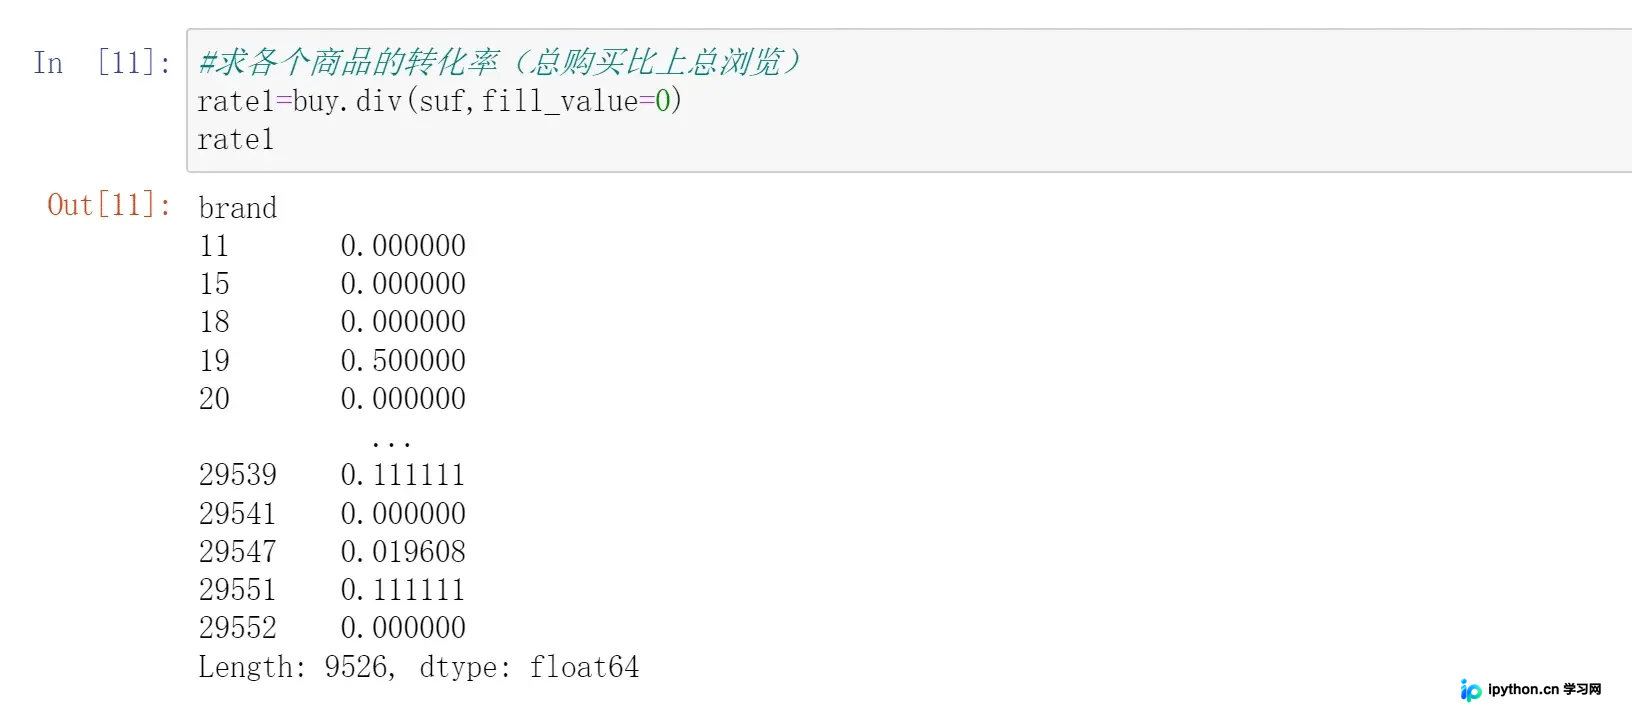
Pandas通过.div()方法实现比值功能(前项除以后项)。
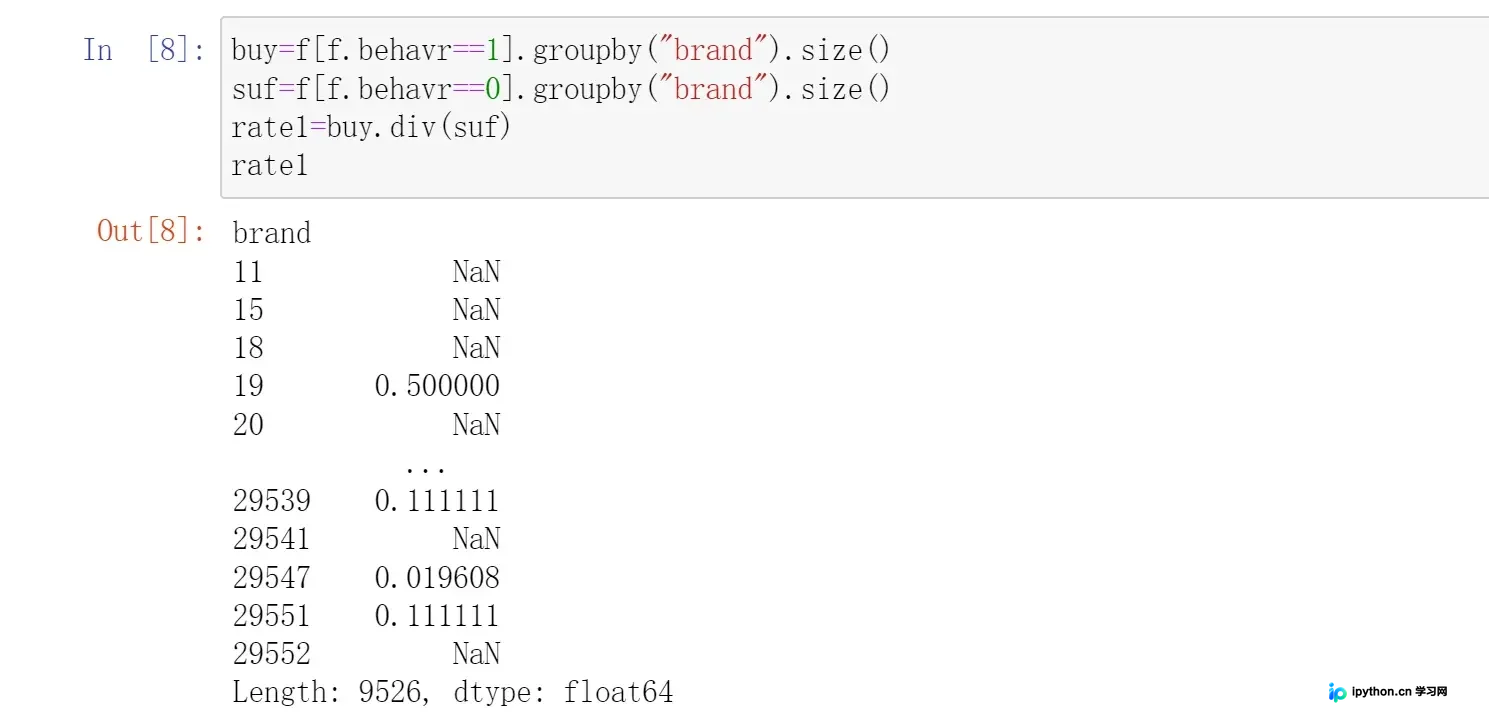
需注意,Series运算可能产生缺失值,因为两个Series的键未必完全一致。
即可能出现前一个Series包含某键而后一个Series缺失该键的情况。例如,brand 11仅有浏览记录而无购买记录,导致统计购买量时缺失brand 11的键,但浏览量中仍包含该键。
在计算过程中,不共有的键将表现为缺失值NaN:
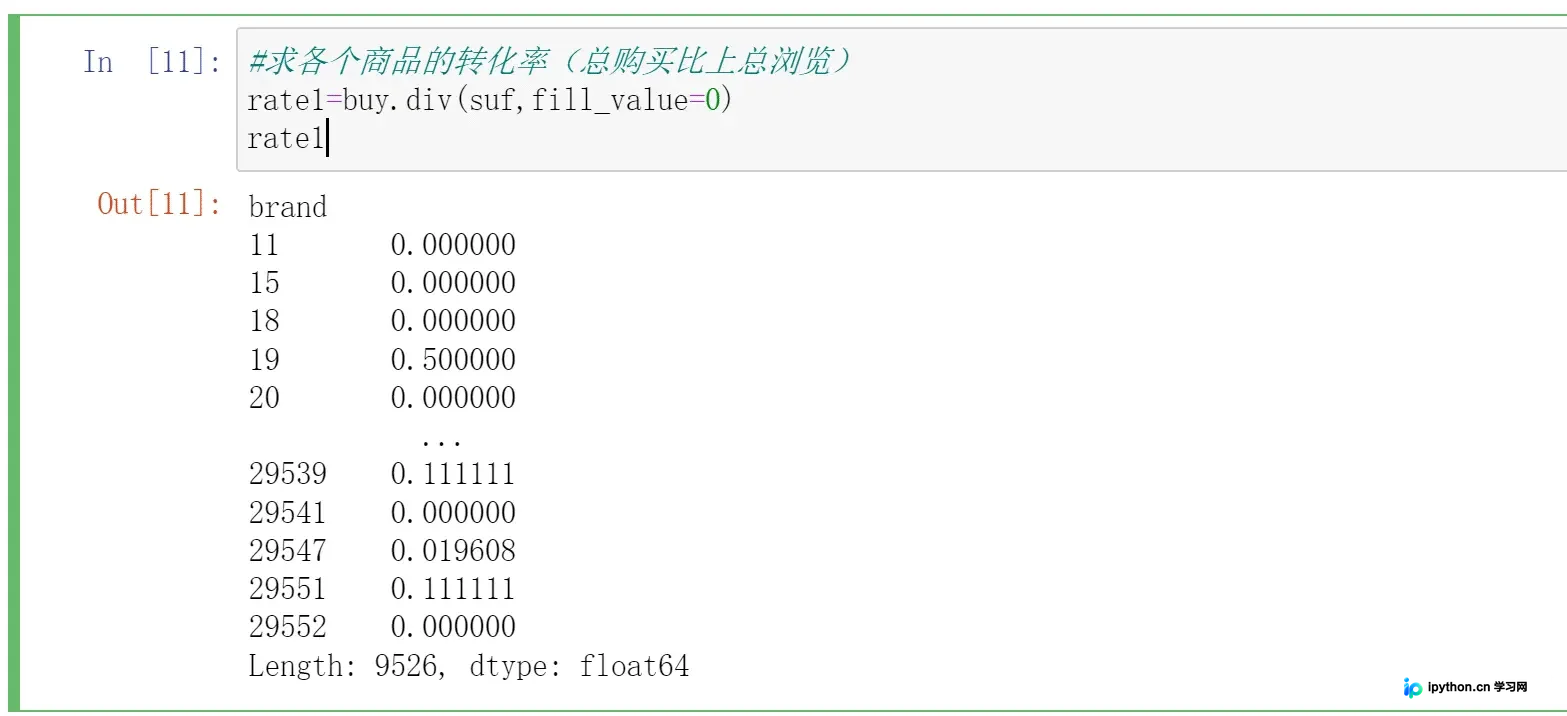
若希望隐藏缺失值NaN,可在div方法中添加fill_value参数,以指定值填充缺失部分。
五、获取转化率最高的30个商品及其转化率
此步骤需借助排序功能。将前述计算得到的转化率数据通过sort_values()函数排序,并输出前30条记录即可:
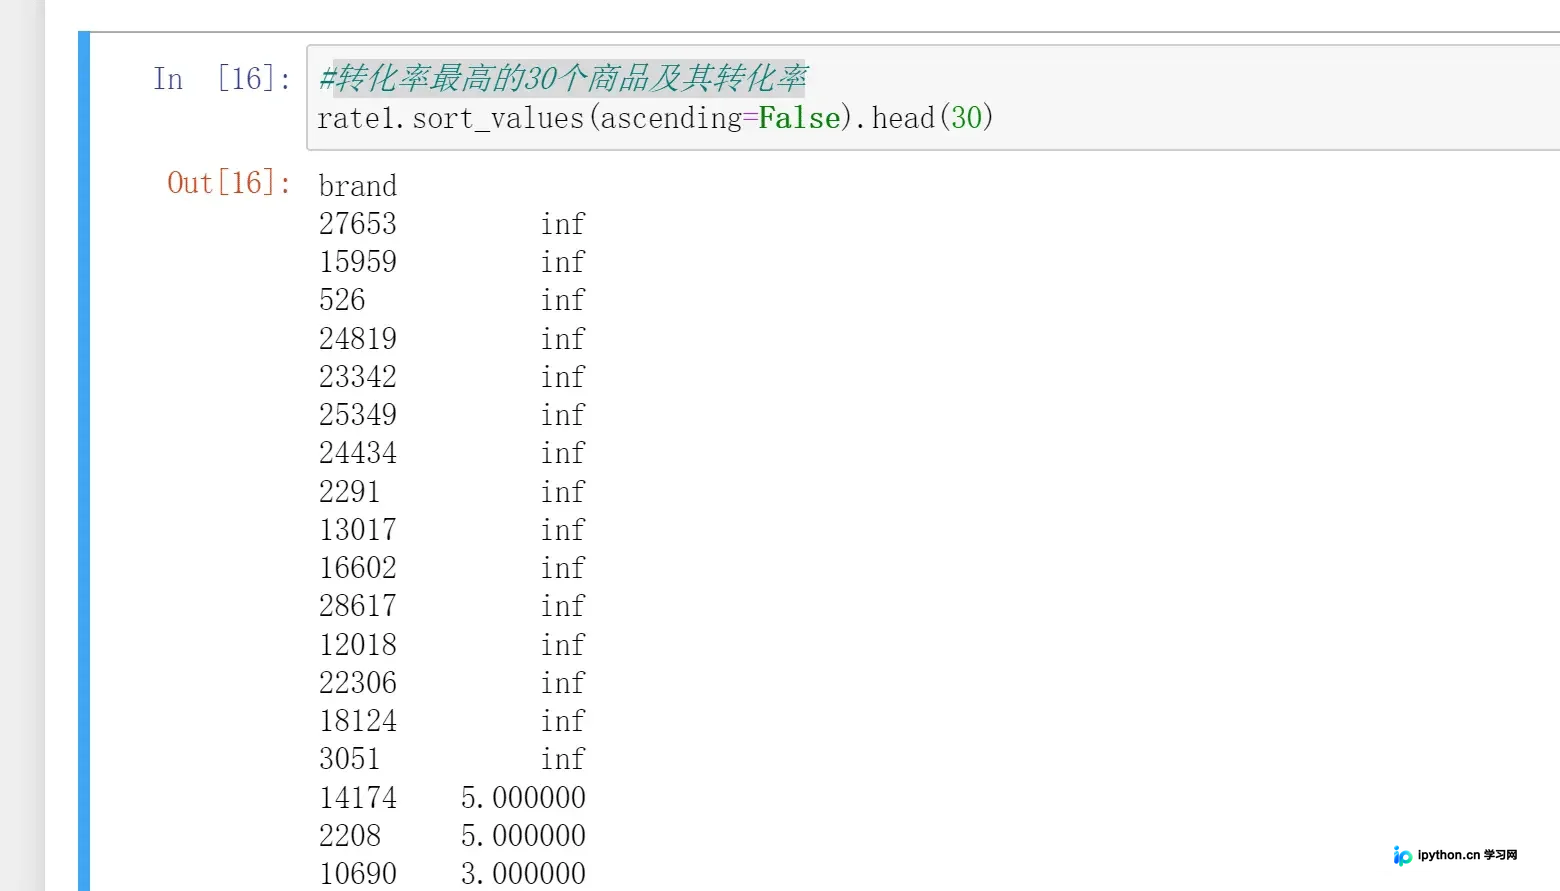
- 在sort_values()函数中,将ascending参数设为False可实现降序排列(默认为True升序)。
- head(n)用于输出前n条记录,同理tail(n)用于输出最后n条记录。
简要总结
可以看出,Python语言具有高度抽象性。在使用第三方库时,无需手动设计算法即可完成操作。
库中通常封装了相关函数或方法,其底层可能由C语言等基础语言实现,执行效率远高于纯Python手写代码。
对于初学者而言,若想快速上手:
只需记忆并熟练运用这些函数即可。
这或许使得Python更像一门文科性质的编程语言……
以上为Pandas数据分析中groupby函数用法的实例详解,更多Pandas数据分析及groupby函数相关资料,敬请关注本站其他文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















