扫描版PDF怎么翻译?结合OCR与AI实现高精度图文转换
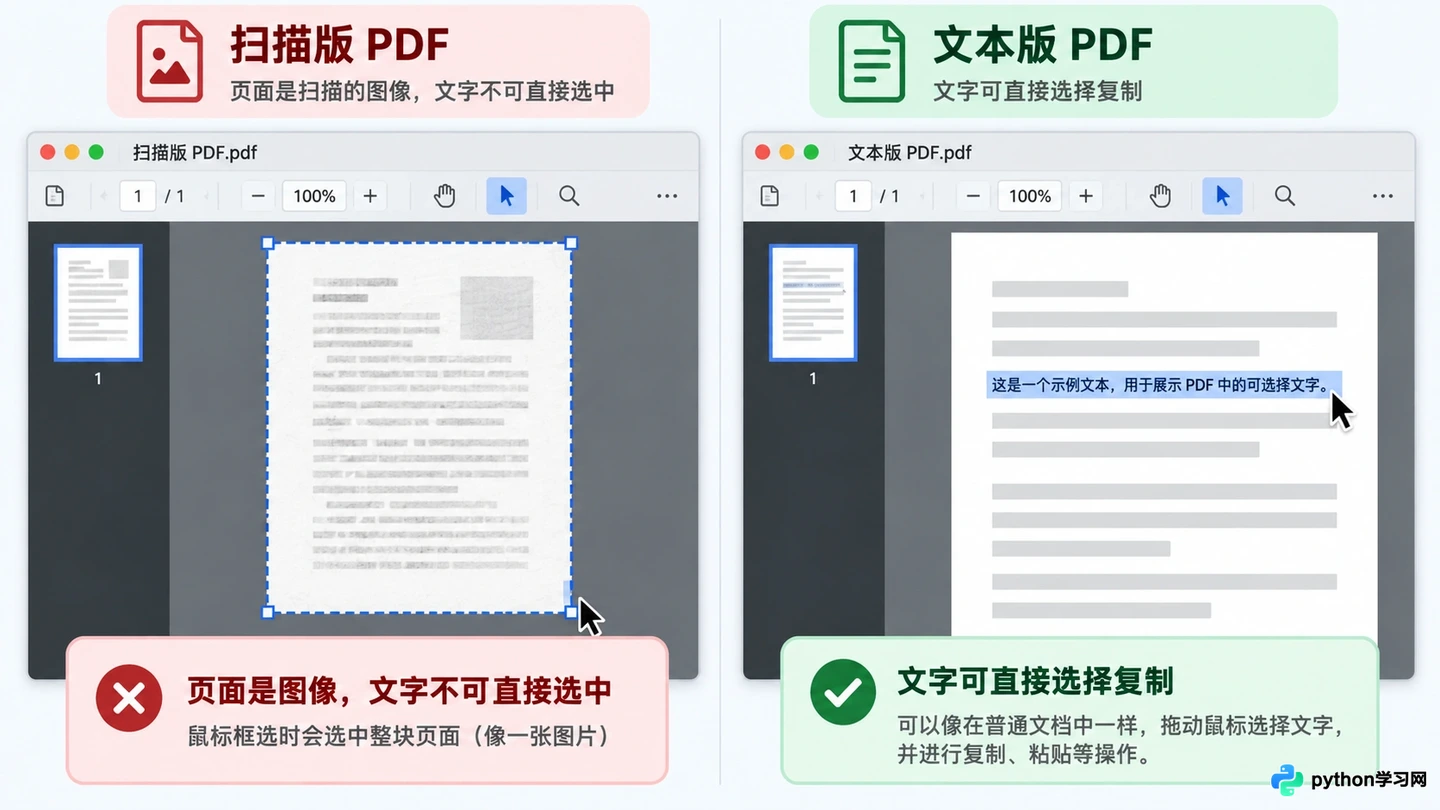
针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。



针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。
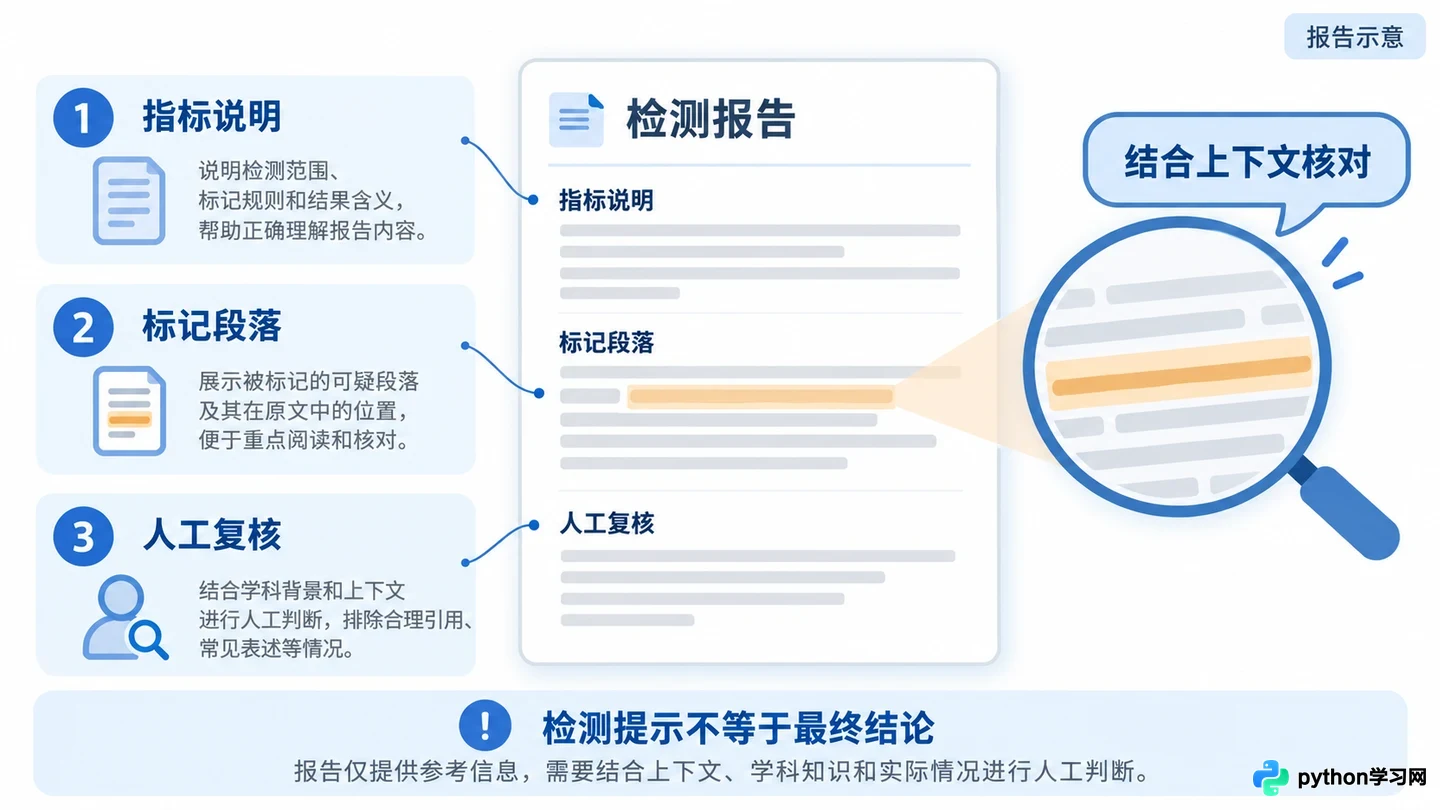
本文以Turnitin AI写作报告为例,指导用户如何正确解读AI检测数据。通过核对报告有效性、区分AI比例与相似度、定位标记段落以及结合写作过程材料进行人工复核,帮助用户避免误读指标,建立科学的学术诚信审查流程。
本文介绍如何在AI提示词模板中嵌入思维链(CoT)推理步骤,通过结构化引导让模型在处理复杂逻辑、数学或分析任务时展示中间思考过程,从而显著提升输出准确性和可解释性。
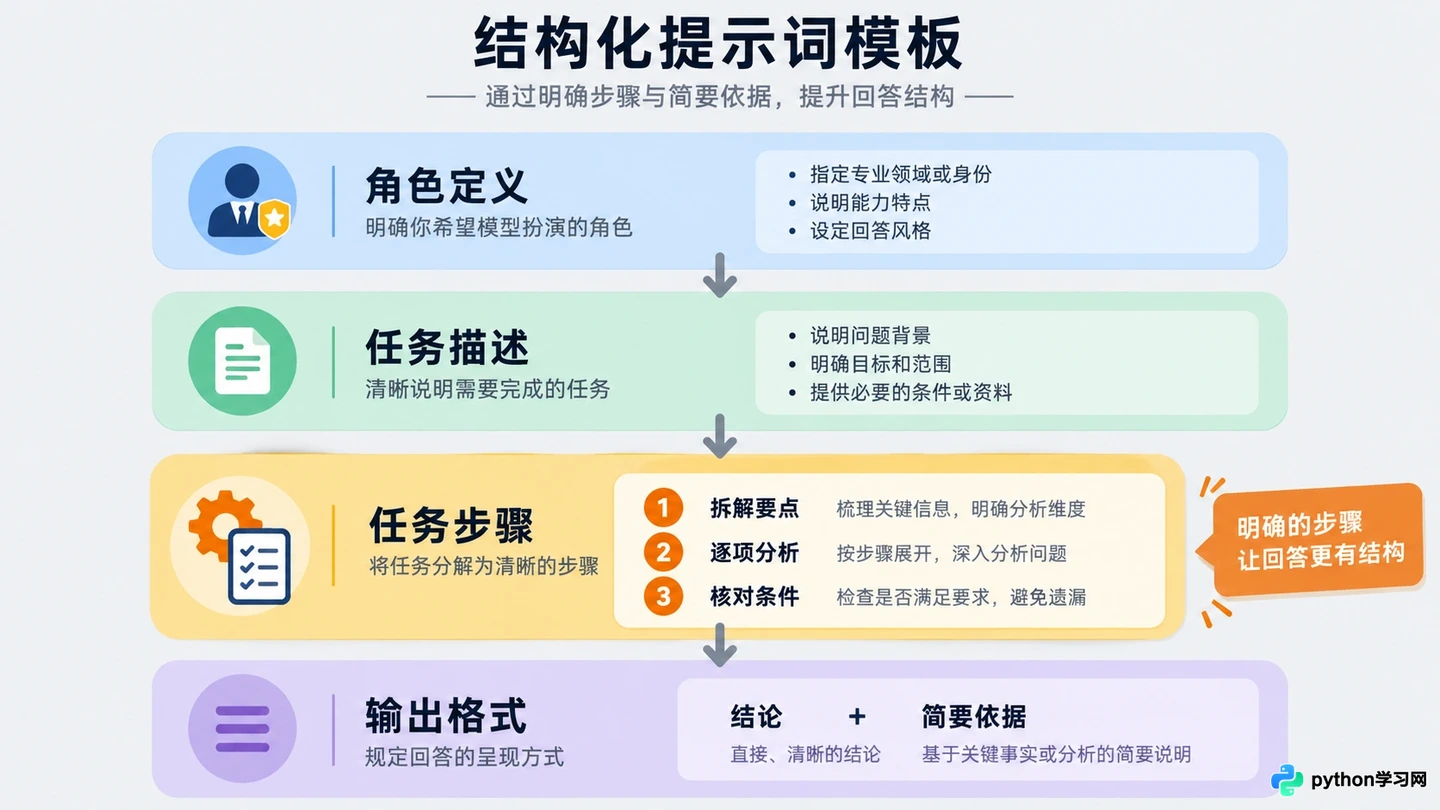
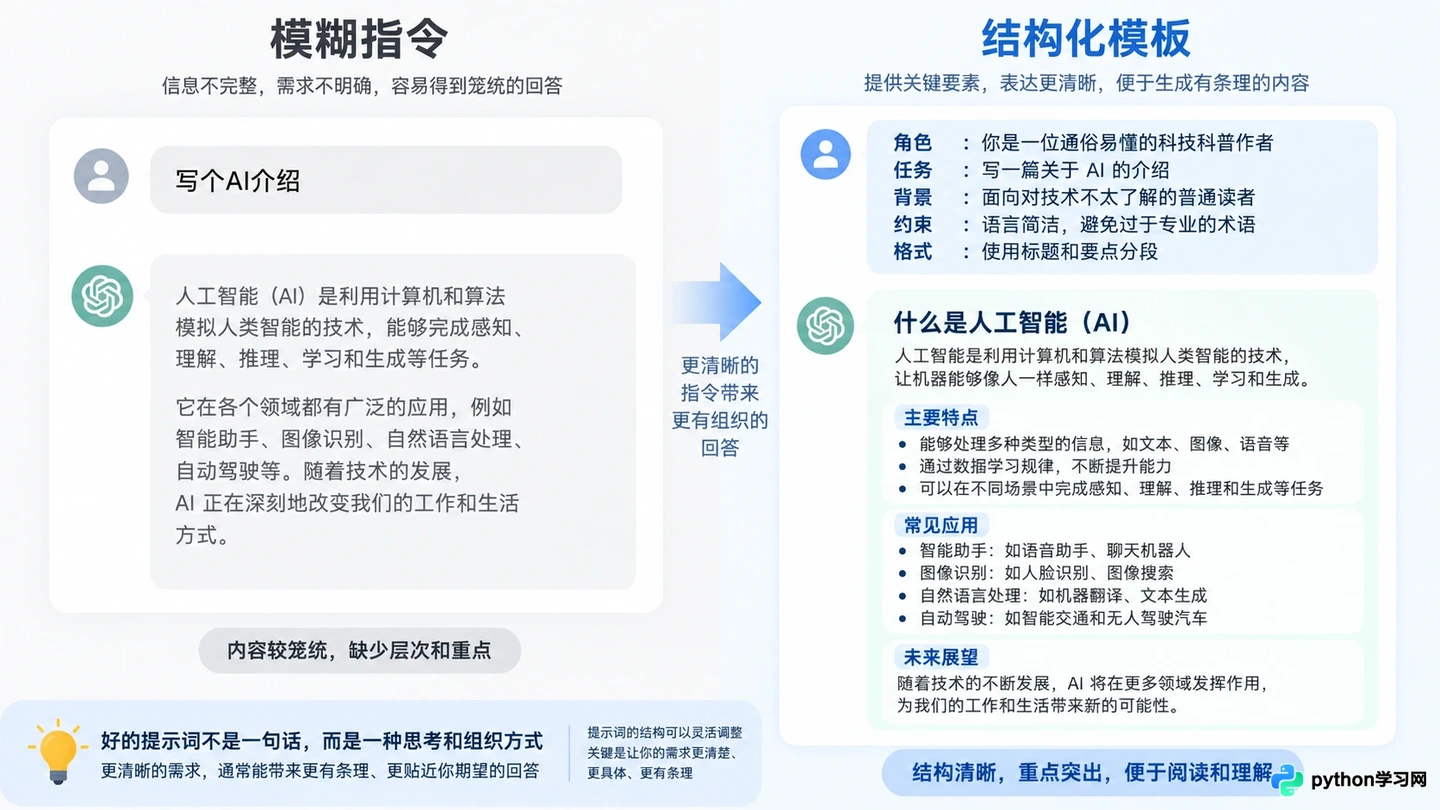
本文解析AI提示词模板的定义与核心价值,拆解“角色+背景+任务+约束+输出”的通用五步结构。通过对比模糊指令与结构化模板的实际生成差异,展示如何通过固定框架提升AI交互的稳定性与效率,帮助初学者快速掌握高质量提示词的编写逻辑。
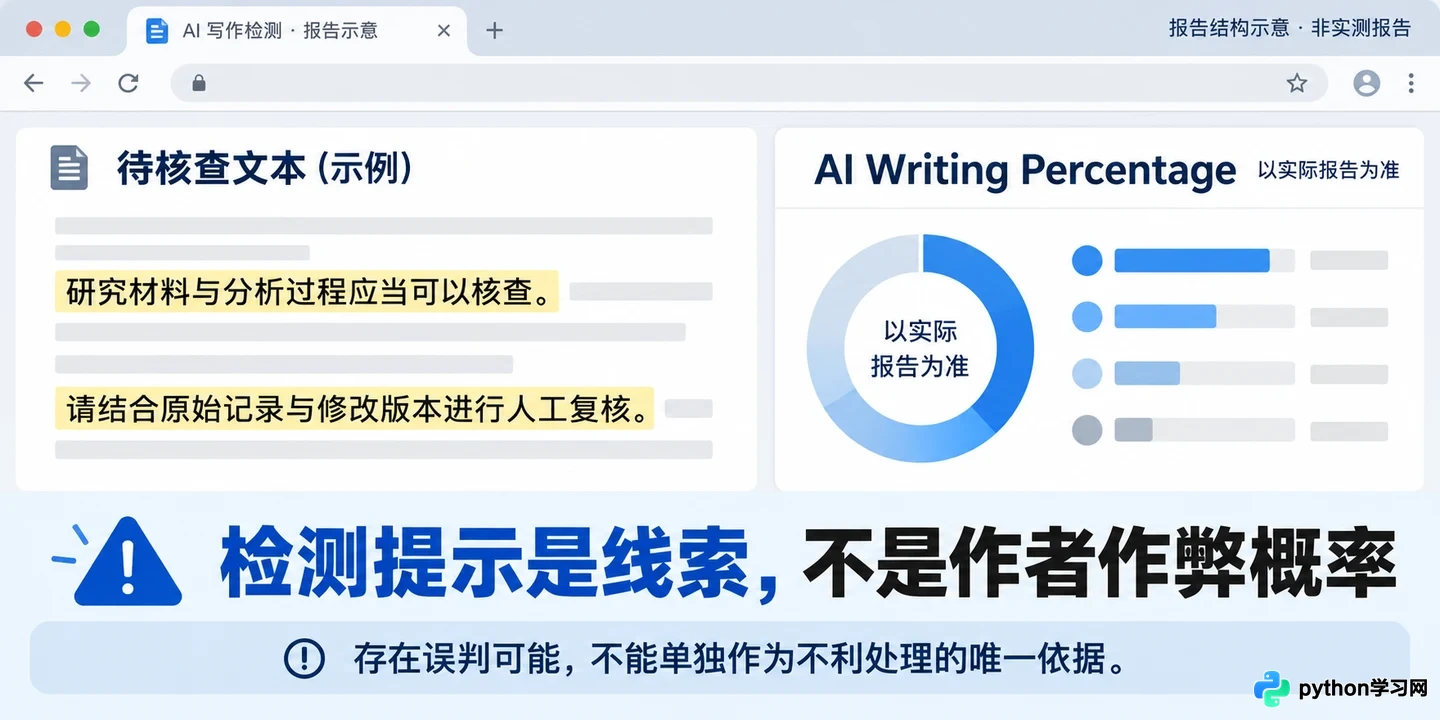
本文解析高校AI论文检测机制,指出检测报告仅为线索而非定罪依据。通过对比相似度与AI写作检测的区别,强调保留研究过程材料(如原始数据、草稿、代码版本)的重要性。结合广东东软学院和江南大学的实例,明确语言润色与核心研究生成的边界,提供合规使用AI辅助写作的留痕方法与隐私保护建议,帮助学生避免误判并坚守学术诚信。
针对AI翻译中专业术语误译的问题,本文以DeepL网页版为例,介绍如何通过优化原文上下文、建立和管理术语表(Glossary)来提升翻译准确度。内容涵盖术语表的创建流程、语言对方向设置以及译后检查要点,帮助用户在保持译文流畅的同时确保行业词汇的规范性。
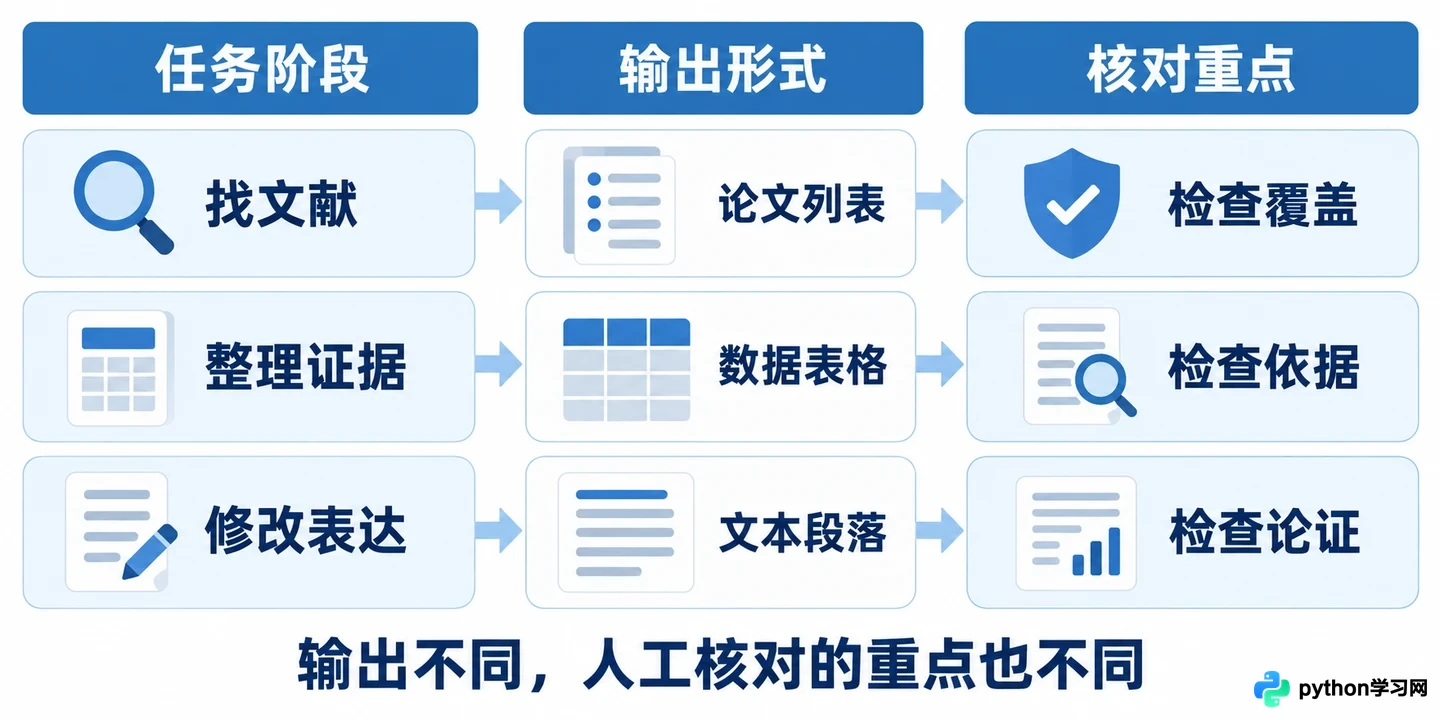
本文基于“线上反馈是否影响学生学习表现”这一示例,对比Consensus、Elicit和Paperpal三类代表性AI工具。文章指出应根据找文献、整理证据或修改表达等不同任务阶段选择工具,强调结果的可追溯性与人工核查的重要性,并说明了各工具的适用例外情况。
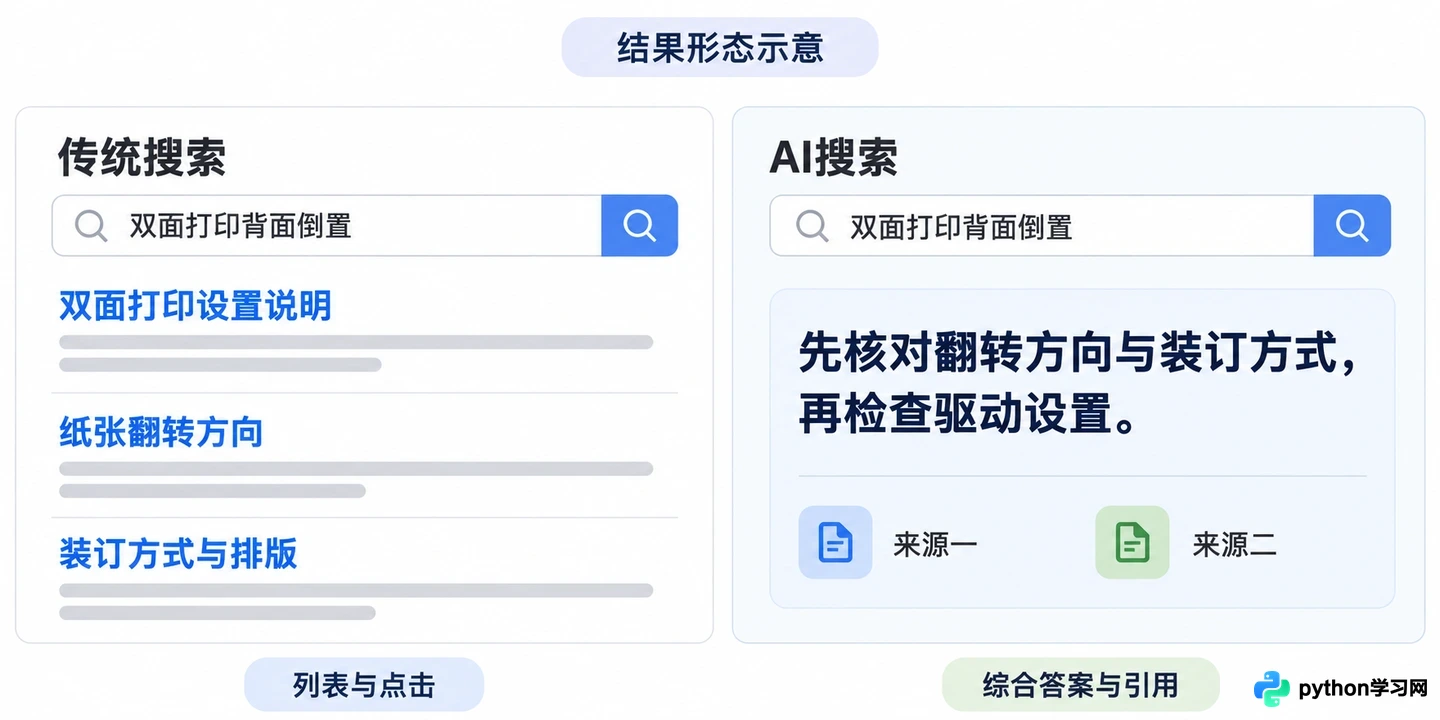
本文解析AISEO与传统SEO的本质差异,指出AISEO并非批量生成内容,而是优化内容在AI答案中的可见性与引用资格。文章强调技术基础、内容可核对性及分平台衡量的重要性,帮助读者理性看待搜索形态变化,避免盲目跟风。
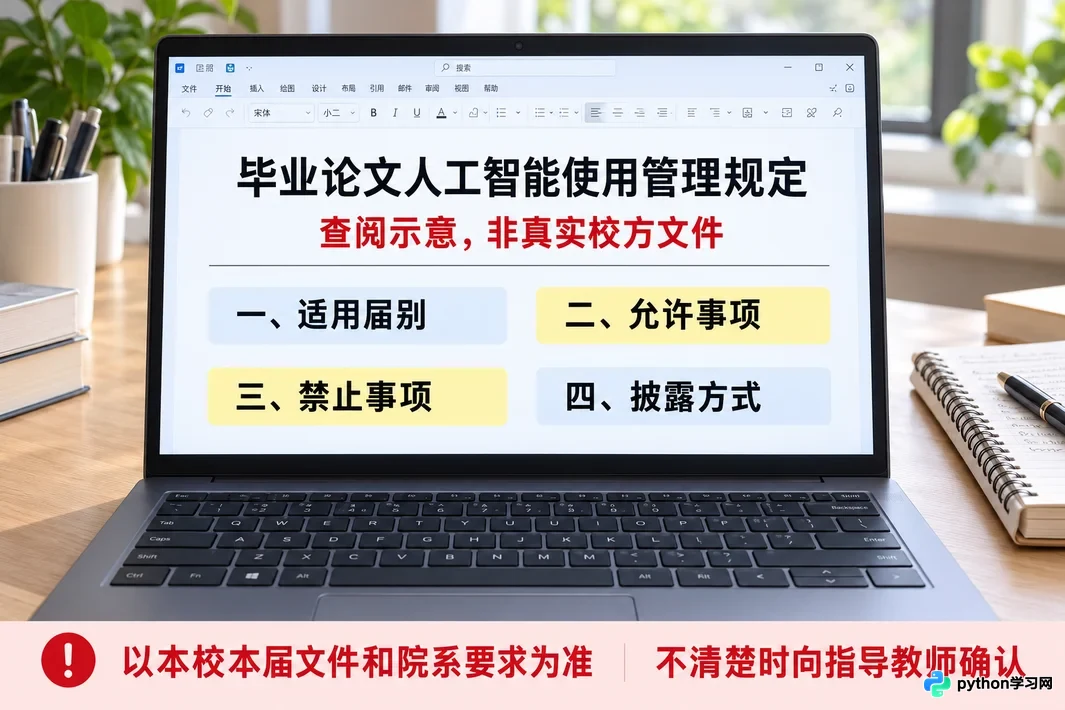
本文以广东东软学院2026年试行规范为例,演示在高校允许范围内,如何合规使用AI辅助检查论文语言问题。通过保留原稿、限定任务、人工核实和留存记录四个关键步骤,确保学术诚信与研究独立性,避免直接代写和伪造引用等常见误区。
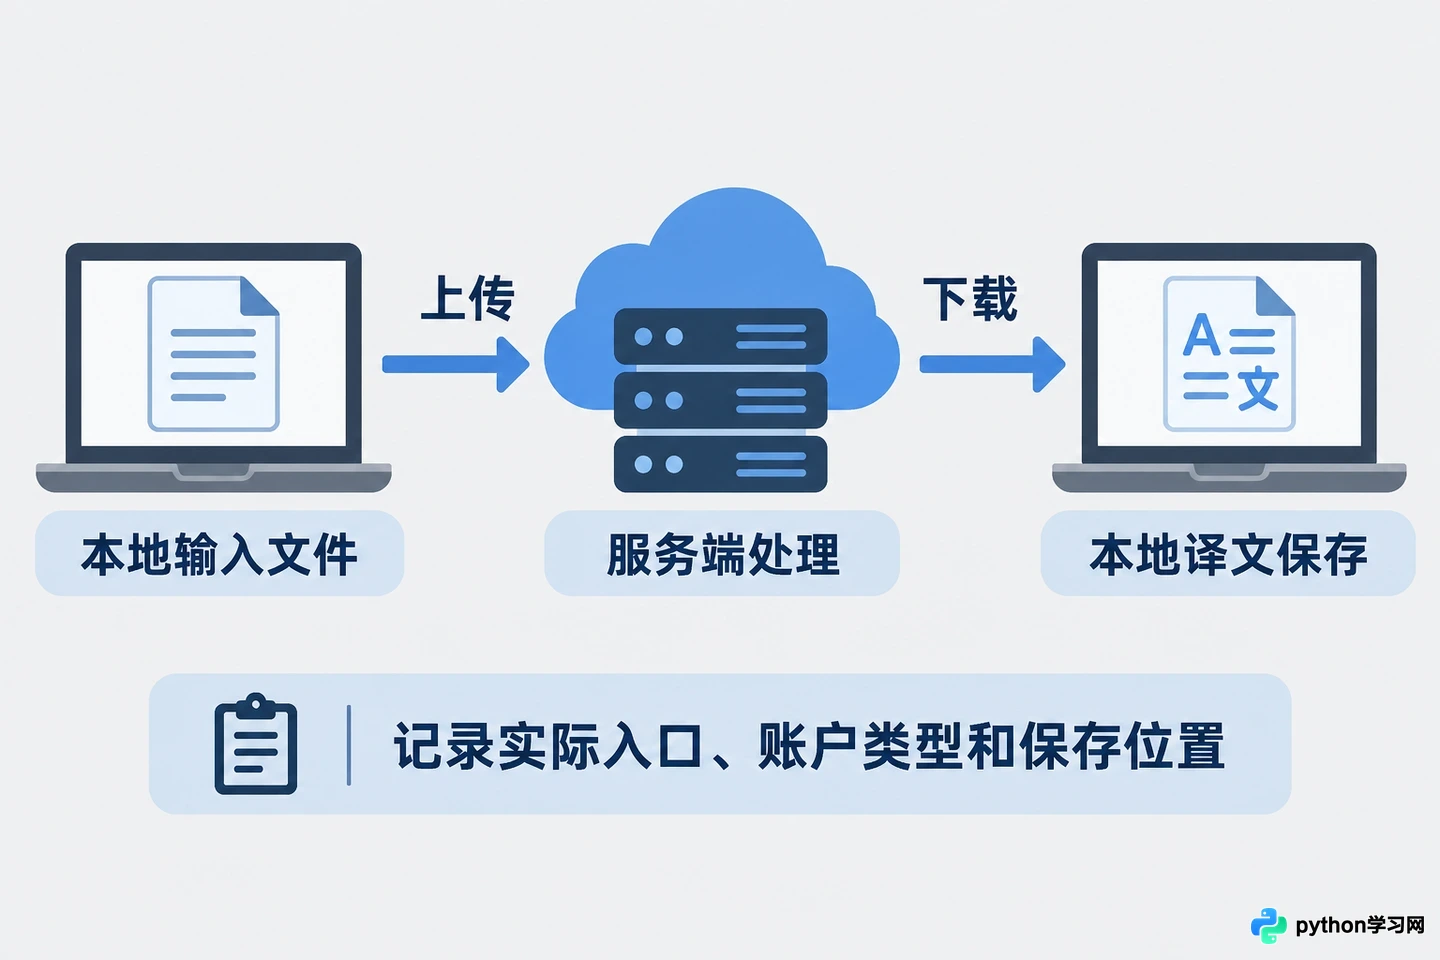
本文解析企业使用AI翻译时的数据隐私风险,从输入脱敏、账户类型确认、数据留存政策到译文保存规范,提供全流程安全操作指南,帮助员工和管理者建立正确的数据安全边界。
本文指导新手如何在海量AI提示词资源中筛选出真正可用的模板。通过明确交付物、核对输入输出结构、处理变量依赖以及用小样例验收,帮助读者建立“可用”的判断标准,避免盲目收藏和无效套用。
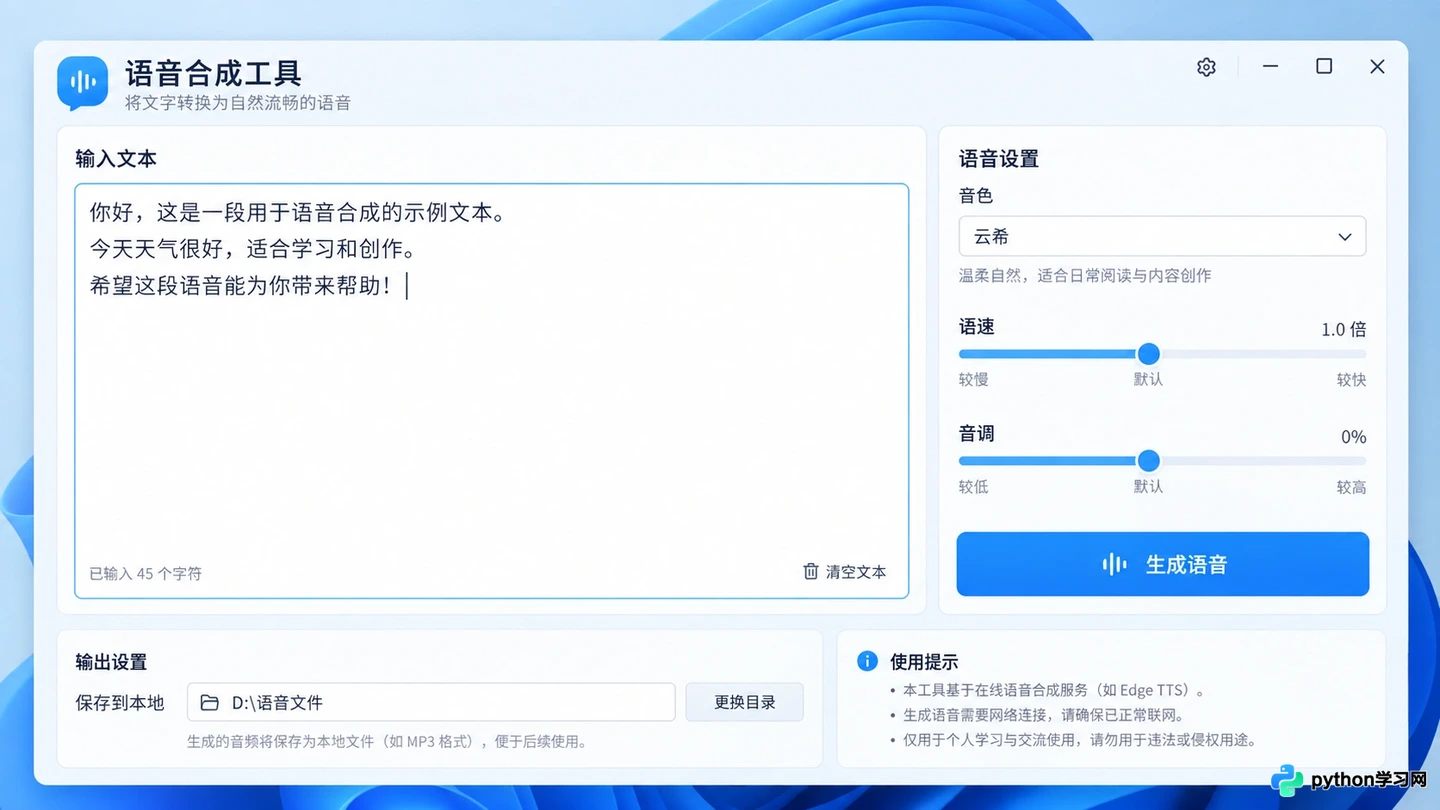
针对在线配音工具的收费与网络限制,本文介绍基于微软Edge TTS引擎的本地封装工具。通过部署开源客户端,用户可在无网络环境下实现无限次、高质量的免费AI配音,重点解析安装配置、音色选择及批量处理流程,为内容创作者提供稳定的本地化语音合成方案。