


零基础学Python有什么用?适合新手的入门实践方向推荐
针对零基础读者,客观解析学习Python的核心现实价值,并系统推荐四大适合新手的实践切入方向:办公自动化、轻量数据抓取、基础数据分析与桌面小工具,附带完整代码示例、决策矩阵与避坑学习路径。
一、零基础学 Python 到底有什么用?
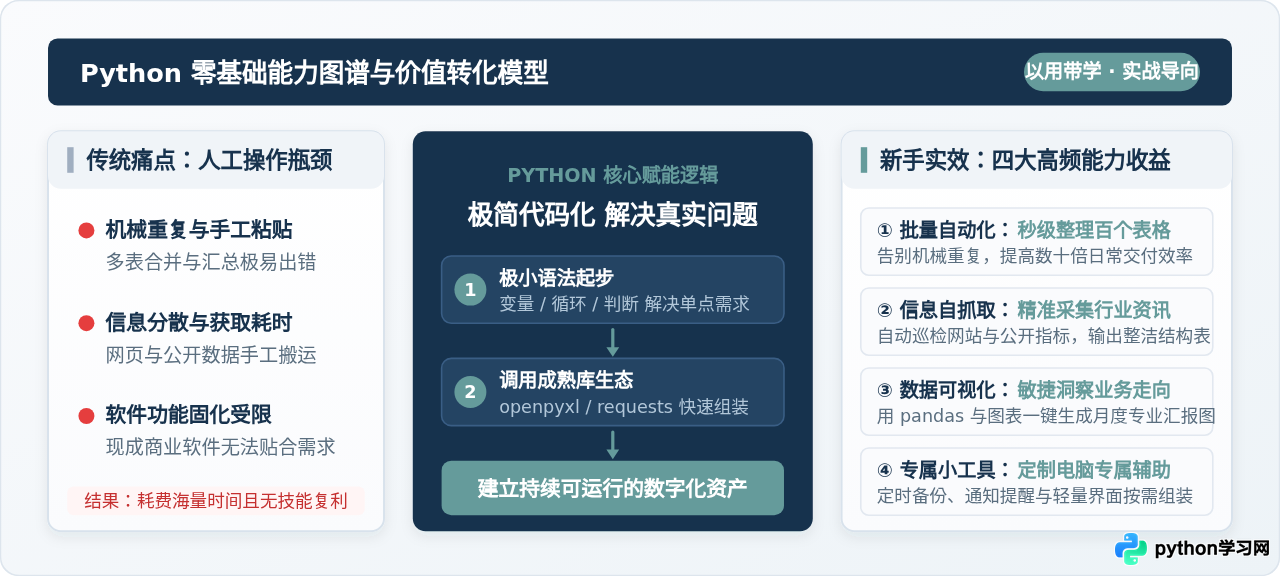
许多刚接触编程的读者常有一种误区,以为学编程就必须开发大型软件、做复杂的系统后台,或者投入深奥的算法研究。事实上,对于非计算机专业或零基础人群,Python 最大的现实价值是一把高自由度的“数字瑞士军刀”。
在没有编程辅助时,面对日常办公与生活中的数据杂务,我们通常依赖人工手工操作:一行一行从多个 Excel 表格中复制数据、按部就班给几百个文件改名字、守在电脑前手动刷新网页抓取更新通知。这些任务并不需要高深的数学智力,却消耗了大量注意力与宝贵时间,而且极易因人为疲劳而出现纰漏。
掌握 Python 的基础语法之后,你就能将这些既定规则编写成简短的脚本,让计算机以极高的速度代替人工执行。具体而言,它能在以下三个层面带来即时的能力增益:
1. 消除低价值的重复数字劳动
通过十几行到几十行简单的脚本,批量处理成百上千个文档、PDF 或表格,原本需要手动耗费半天的工作,程序可在数秒内准确完成。
2. 跨系统打通信息与数据流
现成的办公软件之间往往存在壁垒,而 Python 可以自由充当桥梁:从公开网页读取资讯,整理清洗后自动写入 Excel,再打包生成带特定格式的分析报告。
3. 培养清晰严谨的“工具化思维”
遇到繁杂任务时,思维习惯会从“我该怎么手工把它做完”,转变为“这个过程有哪些固定规则可以抽象成代码自动化运行”,从而建立长期的生产力复利。
二、适合新手的四大入门实践方向多维对比
零基础新手最容易遇到的困境,是花了大量时间看完语法视频,面对空白屏幕却不知道能用它做什么。避免这种“学完即忘”的最佳策略是以具体的应用场景为牵引。
为了让大家根据自身精力与日常诉求挑选切入点,下表从上手难度、见效周期、常用库及推荐度等多维度,对四大经典实践方向进行了量化对比:
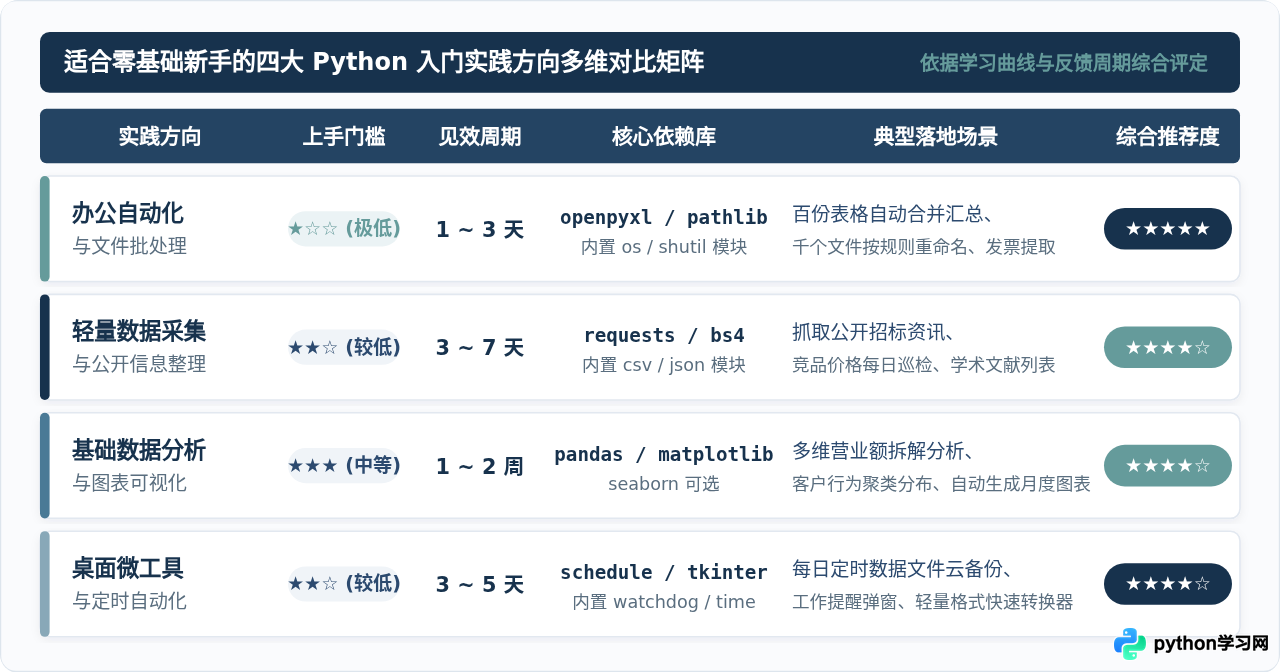
从对比中可以看出:办公自动化与文件批处理是门槛最低、见效最快、挫败感最少的第一选择;而当具备基础后,数据采集、分析与桌面小工具则能进一步拓宽个人的技能边界。
三、四大方向深度解析与实操代码范例
1. 方向一:办公自动化与文件批处理(强烈推荐首选)
这是绝大多数职场人与学生最具“即时获得感”的切入点。主要涵盖 Excel/CSV 数据提取与汇总、Word 文档批量替换、批量生成 PDF 以及海量文件按规则自动归档重命名。
处理此类任务通常使用 Python 自带的标准库 pathlib、os、shutil 以及轻量第三方库 openpyxl。
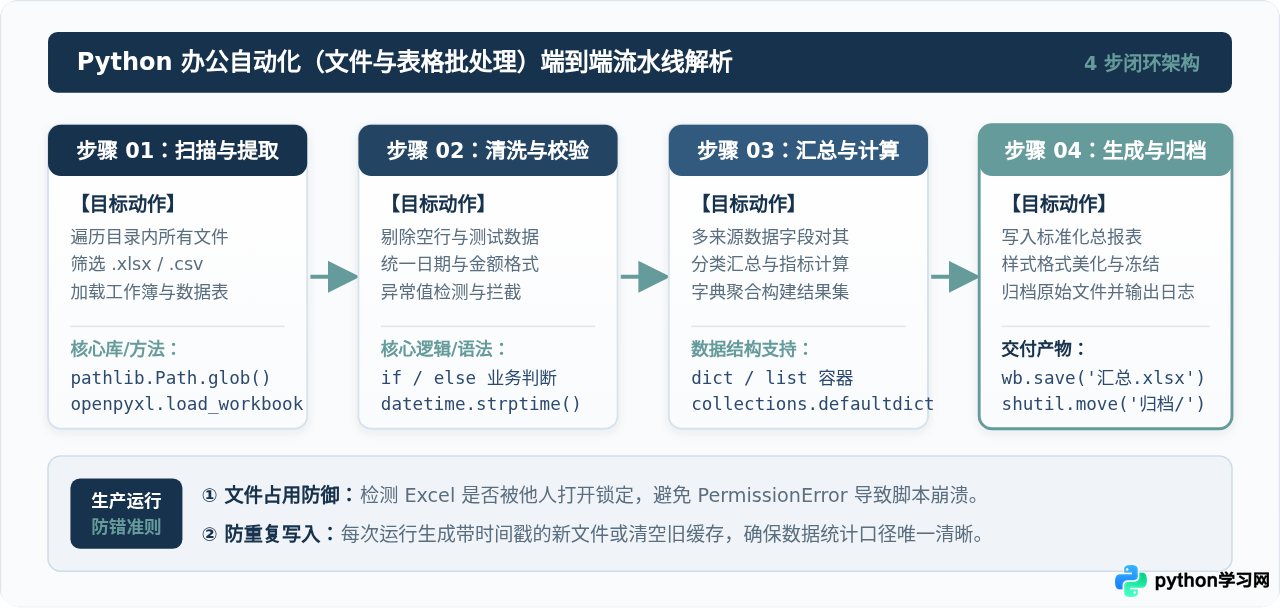
实战场景示例:将指定文件夹中所有分支机构提交的销售日结 Excel 表格,按指定字段提取并合并到一份统一的总账表中:
# -*- coding: utf-8 -*-
# 运行环境:Python 3.8+,需安装 openpyxl:pip install openpyxl
# 执行位置:在工作目录直接运行

from pathlib import Path
import openpyxl

def merge_sales_reports(input_dir, output_file):
    input_path = Path(input_dir)
    # 1. 扫描目录下所有 xlsx 文件(排除临时文件)
    excel_files = [f for f in input_path.glob("*.xlsx") if not f.name.startswith("~$")]

    if not excel_files:
        print("未发现需要合并的 Excel 表格。")
        return

    # 2. 创建汇总工作簿与表头
    summary_wb = openpyxl.Workbook()
    summary_ws = summary_wb.active
    summary_ws.title = "全量汇总"
    summary_ws.append(["来源文件", "订单编号", "商品名称", "销售金额"])

    total_rows = 0
    # 3. 逐个文件读取数据并追加
    for file_path in excel_files:
        wb = openpyxl.load_workbook(file_path, data_only=True)
        sheet = wb.active
        # 跳过表头第 1 行,提取第 2 行开始的数据
        for row in sheet.iter_rows(min_row=2, values_only=True):
            if any(row):  # 忽略完全为空的行
                summary_ws.append([file_path.name, row[0], row[1], row[2]])
                total_rows += 1

    # 4. 保存合并后的总表
    summary_wb.save(output_file)
    print(f"合并完成:成功处理 {len(excel_files)} 个文件,累计汇入 {total_rows} 条记录。")

# 执行示例
merge_sales_reports("./daily_reports", "./summary_result.xlsx")合并完成:成功处理 12 个文件,累计汇入 486 条记录。生成总表: ./summary_result.xlsx
PermissionError。建议在处理前先关闭对应办公软件,或者对文件名增加时间戳以防覆盖。
2. 方向二:轻量数据采集与公开信息整理
在很多行业中,跟踪公开市场行情、科研文献更新、招标公告或竞品标价是一项例行公事。手动点击刷新、复制网页文本不仅效率低下,还极易遗漏关键更新。
Python 拥有非常友好的网络请求库 requests 与 HTML 解析库 BeautifulSoup(来自 bs4),只需几行代码即可抓取静态网页内容并结构化输出为 CSV。
# -*- coding: utf-8 -*-
# 运行环境:需安装 requests, beautifulsoup4:pip install requests beautifulsoup4

import requests
from bs4 import BeautifulSoup
import csv

def fetch_public_announcements(target_url, save_csv_path):
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
    }

    # 1. 发起网络请求获取 HTML 源码
    response = requests.get(target_url, headers=headers, timeout=10)
    response.encoding = "utf-8"

    if response.status_code != 200:
        print(f"请求失败,状态码: {response.status_code}")
        return

    # 2. 解析 DOM 树结构
    soup = BeautifulSoup(response.text, "html.parser")
    items = soup.find_all("li", class_="news-item")

    results = []
    for item in items:
        title_tag = item.find("a")
        date_tag = item.find("span", class_="date")
        if title_tag:
            title = title_tag.get_text(strip=True)
            link = title_tag.get("href", "")
            date = date_tag.get_text(strip=True) if date_tag else "未注明"
            results.append([date, title, link])

    # 3. 写入标准 CSV 文件
    with open(save_csv_path, mode="w", newline="", encoding="utf-8-sig") as f:
        writer = csv.writer(f)
        writer.writerow(["发布日期", "信息标题", "原文链接"])
        writer.writerows(results)

print(f"抓取完毕,共抓取到 {len(results)} 条公告,已存入 {save_csv_path}")robots.txt 协议。仅采集公开合规数据,严禁高频恶意攻击、爬取未经授权的用户个人隐私或商业机密数据。
3. 方向三:基础数据清洗与交互式可视化
当掌握了数据的导入之后,利用 pandas 和 matplotlib 进行数据清洗、透视汇总和直观图表生成,是提升业务汇报说服力的高阶能力。
相比 Excel 数据透视表,Python 处理大型数据集更加稳定流畅,并且可以将整套计算和绘图步骤沉淀为脚本,下月只需要更换数据文件,一键即可重新生成全套分析图表。
# -*- coding: utf-8 -*-
# 运行环境:需安装 pandas, matplotlib:pip install pandas matplotlib

import pandas as pd
import matplotlib.pyplot as plt

# 设置中文字体支持
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'sans-serif']
plt.rcParams['axes.unicode_minus'] = False

# 1. 模拟读取业务明细数据并清洗
data = {
    "商品分类": ["电子数码", "家居日用", "美妆护肤", "电子数码", "家居日用", "食品生鲜"],
    "成交额": [12500, 3400, 8900, 15800, 4200, 6700]
}
df = pd.DataFrame(data)

# 2. 分类汇总统计求和
category_sales = df.groupby("商品分类")["成交额"].sum().sort_values(ascending=False)

# 3. 生成专业柱状统计图
plt.figure(figsize=(7, 4), facecolor="#FAFBFD")
bars = plt.bar(category_sales.index, category_sales.values, color="#17324D", width=0.55)

# 在柱子顶端标注具体金额数值
for bar in bars:
    yval = bar.get_height()
    plt.text(bar.get_x() + bar.get_width()/2, yval + 500, f"¥{yval:,.0f}", ha='center', va='bottom', fontsize=10, color="#17324D")

plt.title("各品类累计成交额统计分布", fontsize=14, pad=15, color="#17324D")
plt.ylabel("销售总额 (元)", fontsize=11, color="#5A6E7F")
plt.grid(axis='y', linestyle='--', alpha=0.4)
plt.tight_layout()

# 4. 导出高质量图像
plt.savefig("./category_sales_chart.png", dpi=200)
print("统计图已生成并保存至 ./category_sales_chart.png")
4. 方向四:桌面微工具与定时自动化脚本
如果你希望电脑能在固定时间(例如每晚 10 点,或每周五下班前)自动执行某些动作,比如备份重要文件目录、定时提醒休息、或者监控某个文件夹的新增文件并自动转换格式,轻量脚本能提供最简洁的解决方案。
配合 Python 内置的 datetime、shutil 以及三方调度库 schedule,无需开发庞大软件即可建立自动工作机制。
四、零基础新手的阶段递进式学习路径
学习编程最忌讳一开始陷入厚厚的大部头教程或空转刷视频。很多新手看了几个月教程依然不会写代码,原因在于输入与反馈脱节。
更合理的做法是采用四阶段递进式路径:先通关极简语法骨架,迅速进入微脚本实操,随后组装外部成熟库,最终完成脚本的健壮性加固。
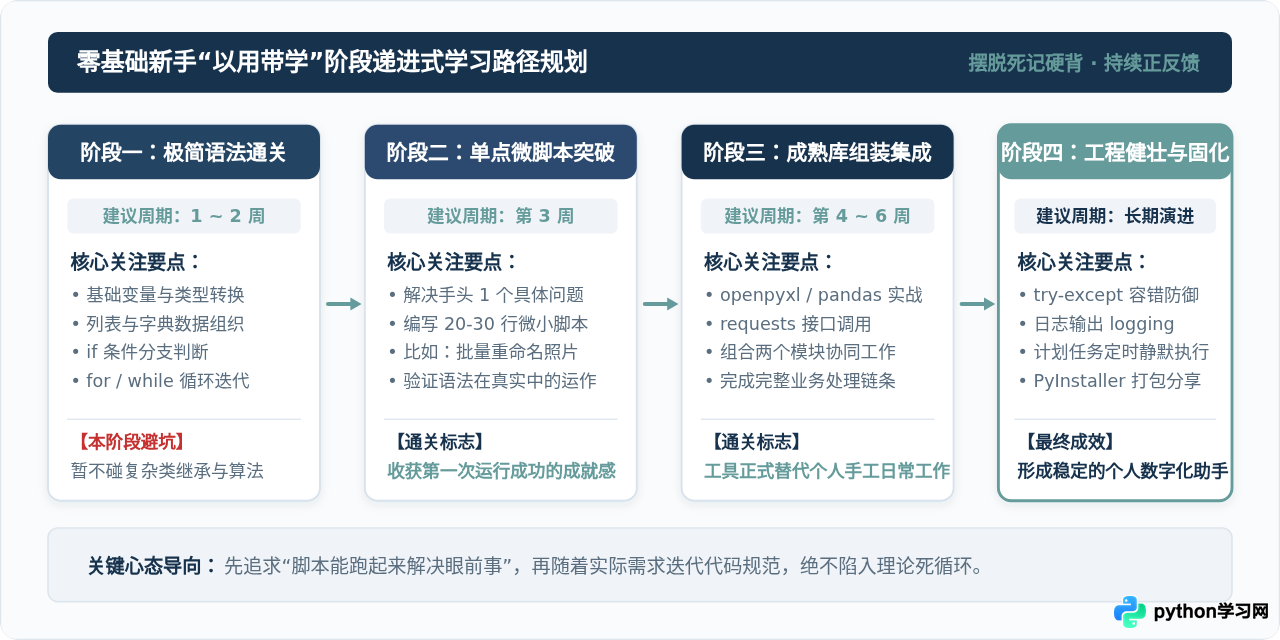
阶段核心拆解:
- 阶段一:极简语法通关(1~2周):只学最核心的变量、列表、字典、if 条件判断和 for 循环。遇到抽象的高级特性(如闭包、装饰器、多继承、复杂元类)先跳过,不让理论阻碍动手脚步。
- 阶段二:单点微脚本突破(第3周):必须强迫自己写一个 20 行以内的微小脚本,哪怕只是“把桌面上所有的截图移动到‘截图’文件夹”。只要脚本在自己电脑上真正运行起来,就会获得不可替代的成就感。
- 阶段三:成熟库组装集成(第4~6周):根据自身方向,学习 1 到 2 个核心三方库的官方教程与快速开始案例(Quickstart),将现成的模块像拼积木一样组合起来。
- 阶段四:工程健壮与固化(第7周起):学会使用
try...except捕获常见异常,加入logging运行记录,并通过操作系统的任务计划程序实现每天定时自启运行。
五、如何挑选最适合自己的第一切入点?(避坑指南)
面对上述方向,新手不应试图“全都要”,而应根据自己日常面临的最突出矛盾,遵循对号入座决策树:
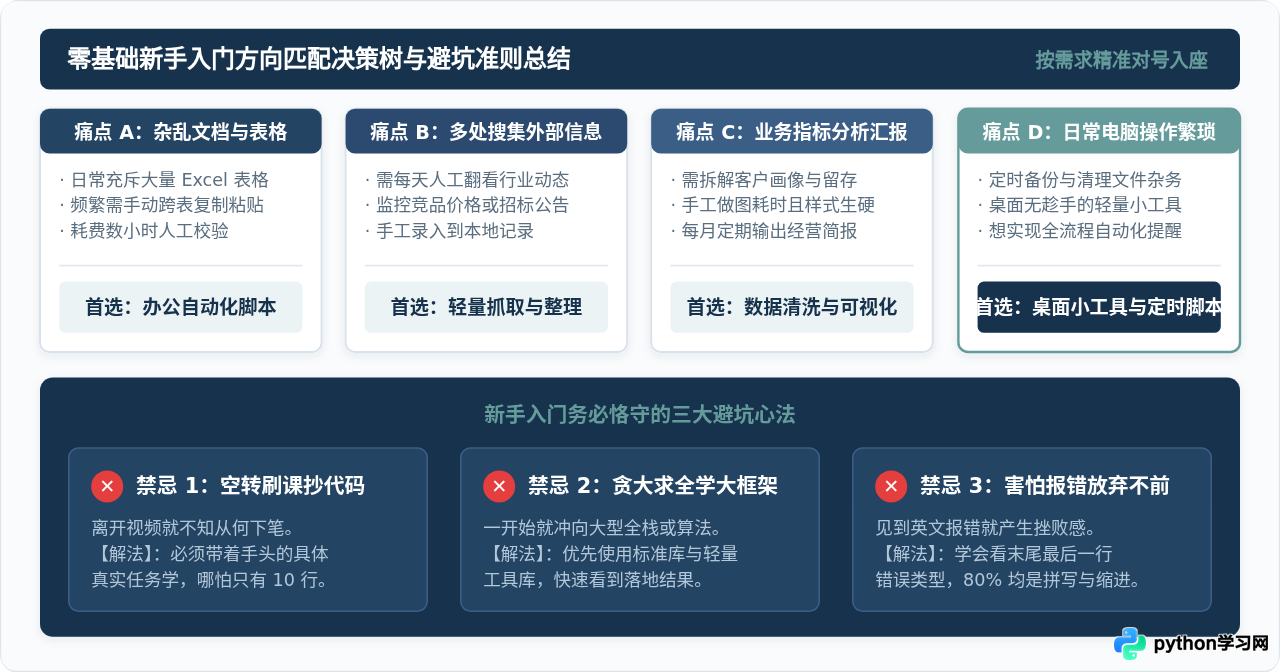
在起步阶段,牢记以下三条能够挽救 80% 放弃冲动的实操建议:
- 不要抄写无关业务的代码:教程里的“学生管理系统”或“猜数字游戏”缺乏业务关联度,容易让人厌倦。拿你工作或生活里的真实文件当练习对象,哪怕只完成一部分,价值也远超虚构例子。
- 不要一上来就追求全栈与大框架:许多零基础读者一听到开发,就去啃 Django、FastAPI 或深度学习框架,其庞大的架构复杂度会迅速击垮信心。先写单个
.py脚本,解决眼前的问题。 - 坦然面对报错,看懂 Traceback 的最后一行:报错是编程的常态,并非失败。Python 的错误回溯通常在最后一行清晰标明了原因(例如
IndexError: list index out of range或KeyError)。遇到报错先读懂最后一行,再对照发生错误的行号进行检查,排错能力将随之快速提升。
六、总结
零基础学 Python,其本质不是为了成为专业软件架构师,而是为自己的思维装配一套自动化杠杆。
通过办公自动化、数据抓取、报表分析或定时小工具,你能逐步将双手从枯燥的机械事务中解放出来,把精力聚焦在更有创造力的思考与决策上。从写下第一行重命名文件的代码开始,用小步快跑、解决具体问题的方式持续积累,你将真正体会到编程带来的自由与效率。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















