
Python正则表达式:解决贪婪匹配问题,实现最短匹配
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。



本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
本文详解Python中正则表达式处理字符串的核心方法。重点介绍使用re.subn进行替换并获取次数,利用re.split进行拆分,以及通过re.match和re.search判断匹配状态。同时展示如何编译正则对象并提取匹配细节,帮助开发者高效处理文本数据。
本文详细介绍如何利用Python的re模块通过正则表达式分别匹配IP地址、URL网址以及电子邮件地址。文章提供了具体的正则模式代码及测试示例,帮助开发者快速掌握网络数据格式验证的核心技巧。
本文介绍在Python中使用正则表达式同时匹配TAB和空格的方法。通过\s元字符或[\t ]字符组,可以精确捕获混合空白字符。文章结合re.match示例,演示如何正确分组提取包含TAB和空格的字符串内容,避免(.*)过度匹配的问题。
本文介绍如何使用Python正则表达式验证IP地址,提供完整的代码示例。通过re模块的compile、finditer及search方法,演示如何提取IP地址及捕获分组信息,适用于网络数据处理场景。
本文详细介绍在Python中使用正则表达式匹配中文字符的方法。核心思路是将字符串转换为Unicode格式,利用[u\u4e00-\u9fa5]模式进行匹配,并注意文件编码(如GBK)的转换。文中提供了完整代码示例及在线正则测试工具链接,帮助开发者高效处理中文文本。
本文详解 Python re 模块核心用法,涵盖基础元字符到复杂文本替换。通过 match、search、findall 实现精准提取,利用 sub 结合分组与回调完成批量修改。提供日志解析、数据脱敏场景代码及 compile 性能优化方案,助开发者高效处理非结构化文本。
本文详解Python中正则表达式模块re的核心用法,涵盖findall、search和sub函数的功能差异。深入解析.*贪婪与.*?非贪婪匹配机制,以及分组捕获和re.S标志对换行符处理的影响。通过代码示例对比search与findall的返回值结构,并演示sub与subn在字符串替换及计数中的应用,帮助开发者精准掌握文本处理技巧。
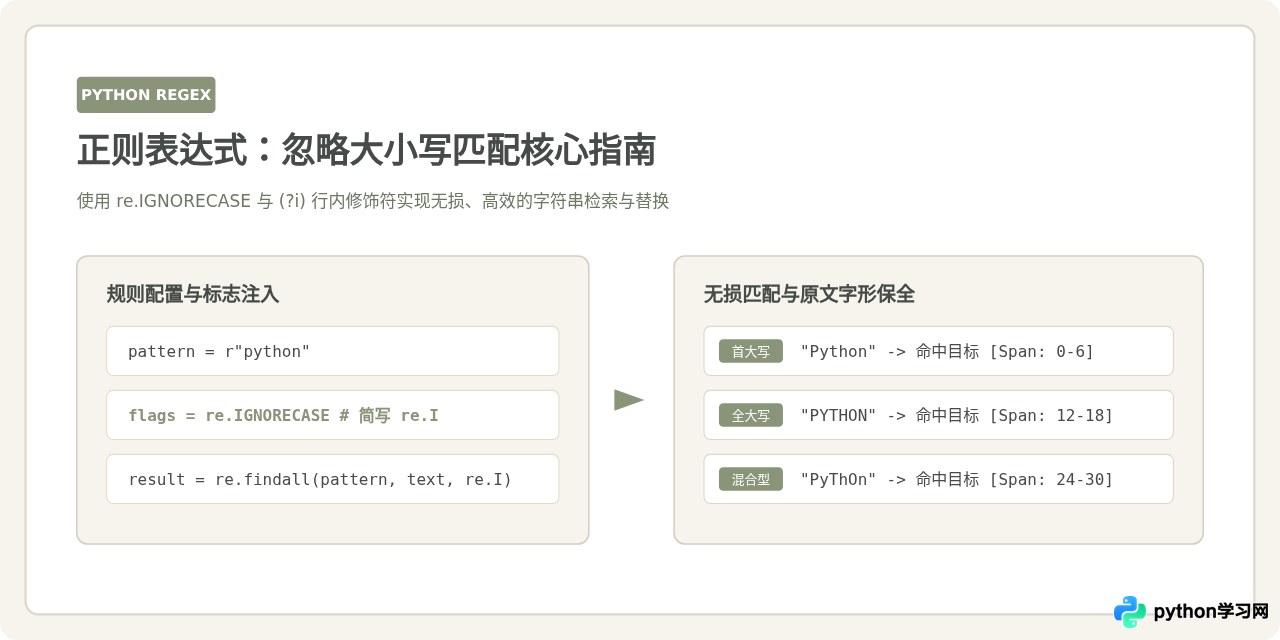
详细讲解在 Python 中使用正则表达式忽略大小写进行字符串匹配的标准方法,包含 re.IGNORECASE 标志、(?i) 行内修饰符、局部修饰及与 text.lower() 预处理的机制辨析。
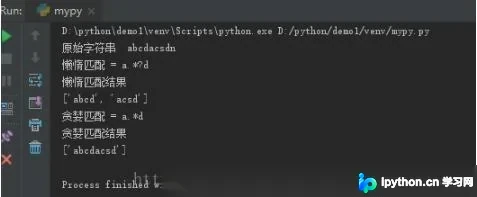
本文深入解析Python正则表达式中的贪婪匹配与懒惰匹配机制,通过代码示例展示两者在匹配结果上的差异。重点分析实际项目中因正则写法导致的性能瓶颈,对比不同匹配模式下的执行时间,并提供分段匹配等优化建议,帮助开发者提升正则处理效率。
本文详解Python中利用正则表达式替换匹配成功组的方法。通过re模块的sub()和subn()函数,结合反向引用语法(如\1),实现字符串模式的灵活替换。文章包含Python 3.6环境下的代码示例,演示如何将文本中的特定标记替换为HTML标签,并展示完整的执行结果与输出分析。
本文探讨Python网页采集中正则表达式匹配换行符的问题。默认情况下,正则中的点号(.)无法匹配换行符,导致数据采集失败。通过示例展示使用[\s\S]组合可匹配包括换行在内的任意字符,并简要介绍\s与\S的定义,帮助开发者解决HTML解析中的换行匹配难题。



