


Python正则表达式怎么忽略大小写进行字符串匹配
详细讲解在 Python 中使用正则表达式忽略大小写进行字符串匹配的标准方法,包含 re.IGNORECASE 标志、(?i) 行内修饰符、局部修饰及与 text.lower() 预处理的机制辨析。
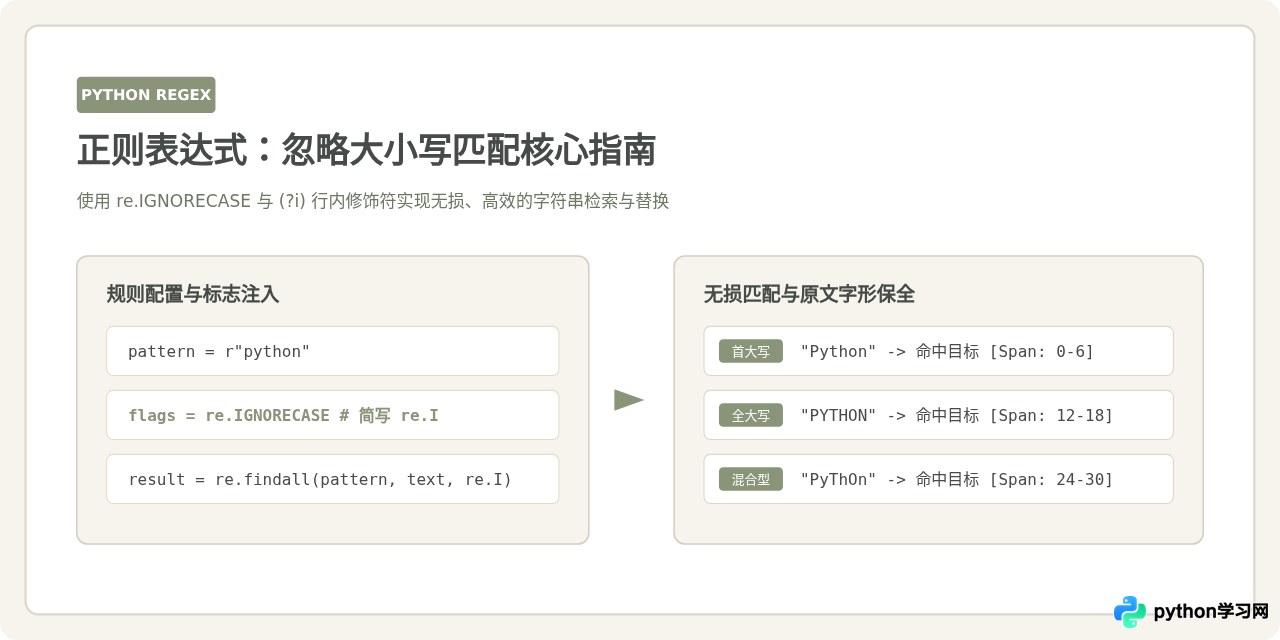
在 Python 中使用正则表达式进行忽略大小写的字符串匹配,核心解决路径非常明确:最标准且常用的方式是在调用 re 模块的匹配函数时,通过 flags 参数传入 re.IGNORECASE(或其等价简写 re.I);如果使用预编译模式,则将其传入 re.compile() 中。此外,在无法直接传递参数的纯正则配置场景下,还可以在正则表达式字符串的开头内嵌 (?i) 修饰符,或者使用 (?i:...) 严格限制忽略大小写的局部作用域。
一、使用 flags=re.IGNORECASE(或 re.I)实现全局匹配
Python 标准库自带的 re 模块为各大检索函数都预留了 flags 标志位参数。常量 re.IGNORECASE 与 re.I 完全等价,代表同一个整数标志。传入该标志后,正则引擎会将 ASCII 字母(以及在默认 Unicode 模式下的相关字母字符)视作大小写同等处理。
1. 单次搜索:re.search() 与 re.match()
re.search() 扫描整个字符串并返回首个匹配的 Match 对象,若未匹配则返回 None;而 re.match() 仅从字符串首字符开始比对。在这些函数中,将 re.I 传给 flags 即可:
import re

text = "Hello Python, welcome to PYTHON world!"
pattern = r"python"

# 查找首个匹配项
match = re.search(pattern, text, flags=re.IGNORECASE)

if match:
    print("匹配成功:", match.group())       # 输出示例:匹配成功: Python
    print("匹配区间:", match.span())        # 输出示例:匹配区间: (6, 12)
else:
print("未找到匹配项")需要注意,match.group() 返回的是原始文本中实际出现的字符切片(如 "Python"),而不会被强行转成模式串中的纯小写形态。这在需要原汁原味提取用户输入的场景中尤为关键。
2. 全文查找与提取:re.findall() 与 re.finditer()
当需要找出文本中所有不区分大小写的目标时,可以使用 re.findall()(返回所有匹配字符串的列表)或 re.finditer()(返回可迭代的 Match 迭代器):
import re

text = "Error: Code 404. ERROR: Code 500. Warning: code 200."
pattern = r"error:\s*code\s*\d+"

# 获取所有匹配到的字符串列表
matches = re.findall(pattern, text, flags=re.I)
print("findall 结果:", matches)
# 示例输出:['Error: Code 404', 'ERROR: Code 500']

# 若需要获取每一次匹配的跨度坐标,使用 finditer
for m in re.finditer(pattern, text, flags=re.I):
    print(f"找到目标:'{m.group()}',位于区间 {m.span()}")
3. 不区分大小写的替换:re.sub()
很多开发者在需要替换不规范大小写的敏感词或标签时感到棘手。使用 re.sub() 配合 re.I,可以精确把各种大小写变体统一替换为目标格式:
import re

content = "Visit our site at Http://example.com or HTTP://test.org."
clean_content = re.sub(r"http://", "https://", content, flags=re.I)

print("替换后文本:", clean_content)
# 示例输出:Visit our site at https://example.com or https://test.org.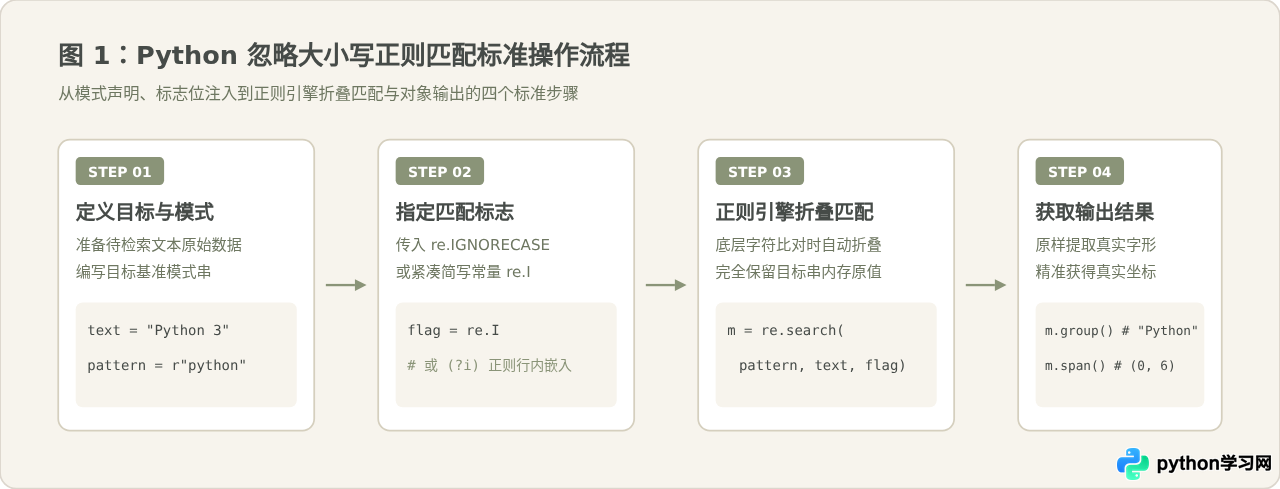
二、通过 re.compile() 预编译提升高频匹配性能
如果需要在循环体、大型文本批处理或高并发服务端频繁执行同一条忽略大小写的正则规则,每次都调用 re.search() 会导致 Python 内部反复进行模式解析或依赖有限的底层 LRU 缓存。更优雅且高效的做法是使用 re.compile() 将模式与忽略大小写标志一起预先编译为 Pattern 对象:
import re

# 预编译模式,将 re.IGNORECASE 绑定在 Pattern 对象上
pattern = re.compile(r"^log_error:.*", flags=re.I)

log_lines = [
    "LOG_ERROR: Database timeout",
    "info: user logged in",
    "Log_Error: Connection reset by peer",
    "warning: disk usage 85%"
]

# 在循环中直接复用 Pattern 对象,无需反复传参
matched_logs = [line for line in log_lines if pattern.match(line)]

print("过滤出的错误日志:")
for log in matched_logs:
    print(" -", log)
# 示例输出:
#  - LOG_ERROR: Database timeout
#  - Log_Error: Connection reset by peer
一旦预编译了该模式,后续调用 pattern.match()、pattern.findall() 或 pattern.sub() 时均已天然处于忽略大小写状态,代码更精简且执行效率更高。
三、在正则表达式内部使用行内修饰符 (?i)
在部分工程实践中,用户可能面临无法修改 Python 函数调用代码的限制。例如,正则表达式是从外部配置文件、JSON 策略文件、数据库表或第三方框架接口中读取的纯字符串。此时,无法在 Python 代码中显式传入 flags=re.I。
针对这种场景,正则表达式语法本身支持行内修饰符(Inline Flag):只要在表达式开头写入 (?i),即可在规则内部直接开启忽略大小写模式。
1. 全局行内修饰符
import re

# 正则表达式以 (?i) 开头,无需传递 flags 参数
pattern = r"(?i)apple"

text = "Apple, APPLE, apple, and ApPlE."
print(re.findall(pattern, text))
# 示例输出:['Apple', 'APPLE', 'apple', 'ApPlE']
2. 局部修饰语法:严格限定部分内容忽略大小写
有时业务要求只对模式中的某一段忽略大小写,而其余部分必须严格匹配。例如,我们希望协议前缀(如 http 或 https)不区分大小写,但紧随其后的主机域名或特定标识必须为严格大写或严格小写。Python 支持扩展非捕获组语法 (?i:...):
import re

# 仅 (?i:get) 忽略大小写,后面的 _TOKEN 必须严格大写
pattern = r"(?i:get)_TOKEN"

test_samples = ["get_TOKEN", "GET_TOKEN", "Get_TOKEN", "GET_token"]

for s in test_samples:
    m = re.match(pattern, s)
    status = "匹配成功" if m else "匹配失败"
    print(f"测试文本 '{s}': {status}")

# 示例输出:
# 测试文本 'get_TOKEN': 匹配成功
# 测试文本 'GET_TOKEN': 匹配成功
# 测试文本 'Get_TOKEN': 匹配成功
# 测试文本 'GET_token': 匹配失败(因为 _token 不是大写)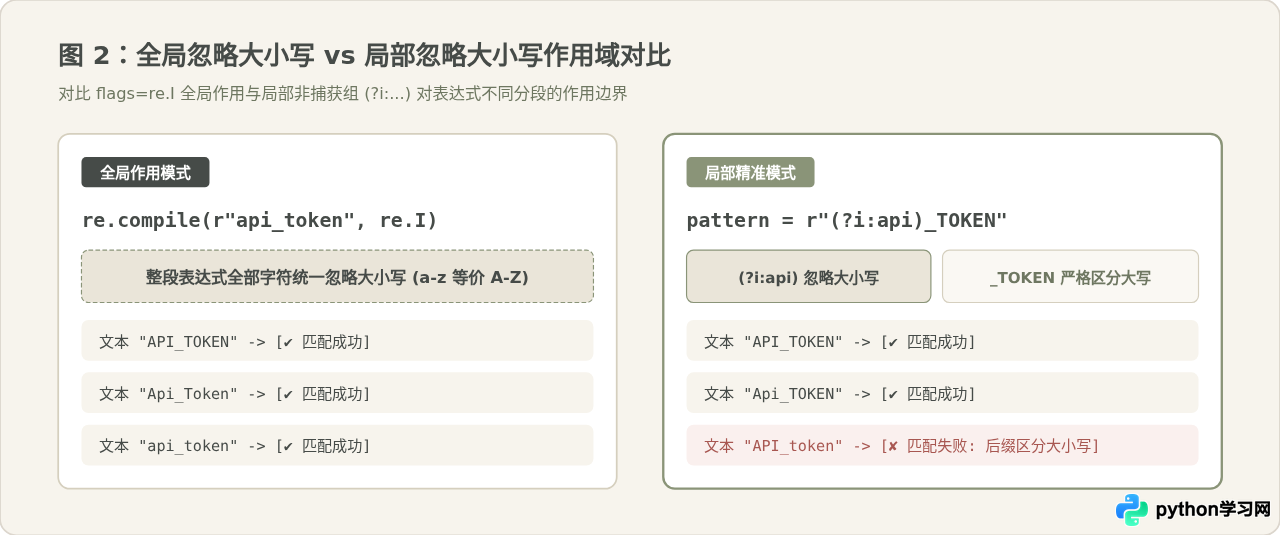
四、常见做法辨析:先 text.lower() 再匹配为什么需要修正?
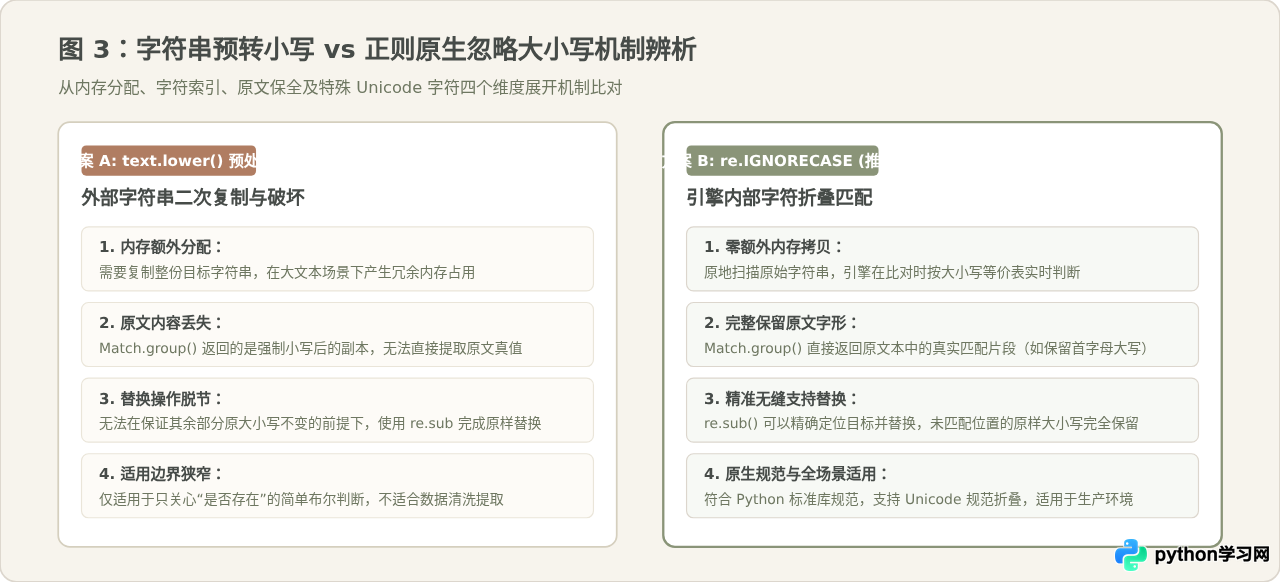
初学者在解决大小写匹配问题时,往往会形成一种直觉做法:既然要忽略大小写,为什么不先把原字符串和正则表达式全部转成小写,即写成 re.search(pat.lower(), text.lower()) 呢?
这种做法之所以在很多初学者代码中广泛存在,是因为在极其简单、纯 ASCII 且仅做布尔存在性校验的场景下,它确实能够返回匹配成功。然而,将字符串整体预转小写存在明显的架构缺陷与潜在隐患,主要表现在以下四个方面:
- 无法保全原文本内容与字形: 使用
text.lower()匹配后,返回的Match对象中包含的内容全是被强行转为小写的副本。如果你的任务是数据抽取、实体识别或名词抓取,你将丢失用户输入的真实大小写形态(例如专有名词"iPhone"、"MySQL"均变成小写)。 - 冗余内存拷贝与性能开销:
text.lower()会在内存中完整分配并创建一个全新的字符串对象。当目标文本是数兆乃至数百兆的文件或爬虫长文本时,每一次预处理都会产生巨大的内存分配与垃圾回收压力;而re.I标志是由底层 C 语言正则引擎在扫描时进行字符折叠判定,零内存额外复制。 - 难以支持上下文精准替换: 若使用
re.sub()进行部分内容清洗,在转为小写的字符串上操作,将导致原文本原本的大写字母全部被破坏。若要在小写文本上找到索引再映射回原文本,代码逻辑会变得极度脆弱和复杂。 - Unicode 大小写映射非一对一的陷阱: 在涉及多语言或特殊字符集时,某些字符的大小写转换会导致字符串长度发生改变(例如德语字母
ß转为大写是SS),这会导致预处理后的字符偏移量与原文本不再对齐,从而引发切片坐标越界或错位。
五、注意事项与组合技巧
1. 多标志位组合使用(按位或操作)
在实际生产中,忽略大小写常需要与其他标志位配合使用。例如,既要忽略大小写,又要让 ^ 和 $ 支持多行匹配(re.MULTILINE),或让点号 . 匹配换行符(re.DOTALL)。此时应使用 Python 的按位或运算符 | 将它们组合:
import re

text = """
Config_Start: 100
config_start: 200
"""

# 同时启用忽略大小写与多行模式
pattern = re.compile(r"^config_start:\s*(\d+)", flags=re.IGNORECASE | re.MULTILINE)
matches = pattern.findall(text)

print("提取到的配置值:", matches)
# 示例输出:['100', '200']
注意: 标志位是整型掩码(bitmask),请务必使用单竖线 |(按位或),不要使用逻辑与 and 或逻辑或 or,否则会导致标志位计算错误。
2. Python 3 默认的 Unicode 属性与 ASCII 限制
在 Python 3 中,正则表达式默认启用了 Unicode 匹配(等价于 re.UNICODE)。这意味着 re.IGNORECASE 不仅能处理英文字母 a-z 和 A-Z,也能正确识别具备大小写特性的 Unicode 字符(例如带重音符的法文字符 é 与 É)。如果由于特定协议约束,只想对标准 ASCII 范围生效,可以显式组合 re.ASCII(或 re.A)标志:
import re

# 限制大小写折叠仅在 ASCII 范围内生效
pattern = re.compile(r"cafe", flags=re.I | re.A)
六、方案选型与对比总结
为了在不同业务场景下快速做出最佳技术选择,下表对 Python 中实现忽略大小写匹配的常见方式进行了系统对比:
| 实现方式 | 典型语法 | 优点 | 局限与注意事项 | 推荐使用场景 |
|---|---|---|---|---|
| 函数参数 (flags=re.I) | re.search(pat, s, re.I) |
标准直观,语义明确,零额外内存开销 | 高频循环中每次调用会有轻微开销 | 通用开发、脚本工具、单次检索 |
| 预编译 (re.compile) | p = re.compile(pat, re.I) |
执行性能最高,逻辑高度复用 | 需要多写一行预编译语句 | 日志清洗、大数据批量扫描、服务端服务 |
| 行内全局 ((?i)) | r"(?i)keyword" |
规则自包含,不依赖外部 Python 代码传参 | 可读性略逊,容易被误认为是匹配括号 | 配置文件导入、规则引擎、第三方调用 |
| 行内局部 ((?i:...)) | r"(?i:prefix)_CODE" |
作用域粒度最细,前后严格隔离 | 语法较高级,需要熟悉扩展正则规范 | 复合协议校验、部分字段区分大小写 |
| text.lower() 预处理 | re.search(p, s.lower()) |
思路直观简单 | 丢失原文、破坏跨度、内存开销高、无法保全替换 | 仅限极简的快速布尔测试,不建议生产使用 |
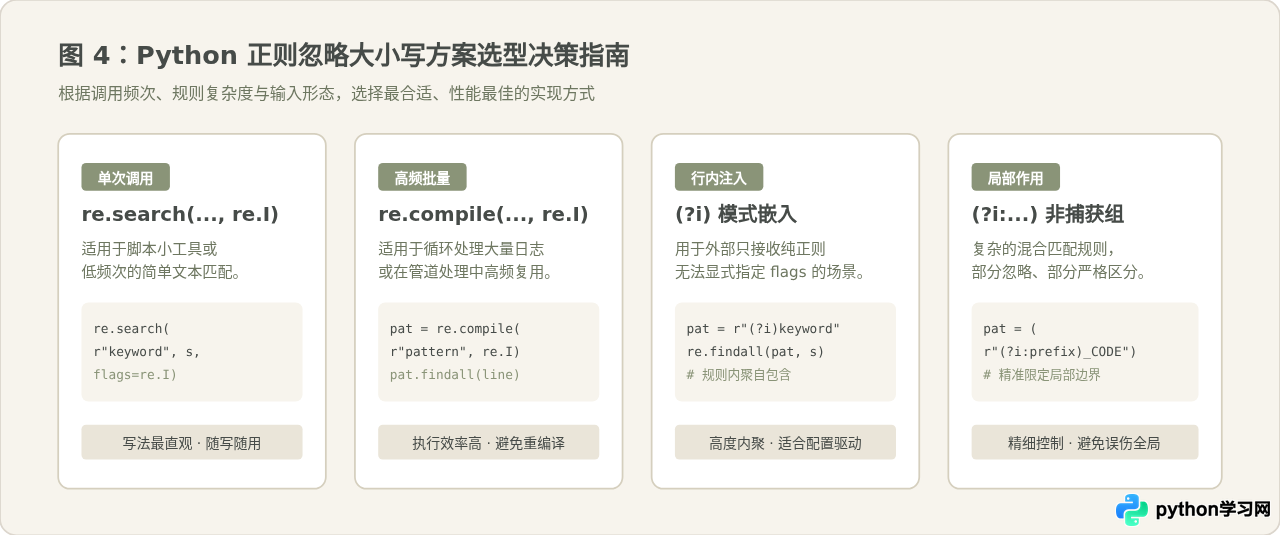
综上所述,在 Python 正则表达式中实现忽略大小写匹配,应当优先选择原生提供的 re.IGNORECASE / re.I 标志位或 re.compile() 预编译机制。在配置驱动的受限环境中,采用 (?i) 行内修饰符或 (?i:...) 局部非捕获组进行内嵌修饰。摒弃全量 .lower() 转换带来的额外内存负担与原文字形破坏,才能编写出兼具高执行性能与鲁棒健壮性的文本匹配程序。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















