
Python pickle模块数据持久化存储与读写详解
本文详细解析Python中pickle模块的基本用法,涵盖数据序列化和反序列化操作。重点介绍pickle.dump()和pickle.load()函数的参数细节,包括协议版本(0、1、2及-1)的区别与选择,以及文件对象的打开模式要求。通过完整代码示例展示如何将Python对象永久存储至文件并重新加载,适用于需要持久化程序运行状态的场景。



本文详细解析Python中pickle模块的基本用法,涵盖数据序列化和反序列化操作。重点介绍pickle.dump()和pickle.load()函数的参数细节,包括协议版本(0、1、2及-1)的区别与选择,以及文件对象的打开模式要求。通过完整代码示例展示如何将Python对象永久存储至文件并重新加载,适用于需要持久化程序运行状态的场景。
本文详细介绍Python中sys模块与常用序列化模块。sys模块提供与解释器交互的接口,如命令行参数和路径。序列化模块包括json(字符串与Python类型转换)、pickle(支持任意Python数据类型)及shelve(基于key的简单持久化),通过实例讲解各模块功能、参数及注意事项,帮助开发者实现数据持久化与传递。
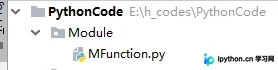
本文详解Python代码模块化方法,阐述函数与类在提升代码可维护性、调试效率及复用性方面的作用。通过PyCharm新建模块文件夹、导入Sources Root及引用函数的具体步骤,结合求值函数与Car类的代码示例,展示模块化编程的实际应用。
本文详细介绍Python3中pickle模块的使用方法,涵盖dumps、dump、loads、load四个核心功能。解析其支持的数据类型范围,包括原生类型、复合结构及自定义类实例。同时说明各方法的参数要求、协议版本差异,并列举PickleError、PicklingError和UnPicklingError三种异常类型及代码示例。
本文深入解析Python中time模块的核心用法,涵盖时间戳获取、字符串格式化、本地时间与格林威治时间的区别,以及结构化时间与字符串、时间戳之间的相互转换方法,帮助开发者高效处理时间数据。
本文详解Python pickle模块的对象序列化功能,通过pickle.dumps和loads实现内存对象与字节流的转换,并结合文件读写演示dump与load方法,帮助开发者掌握数据存储与传输的核心技术。
本文详细解析Python中json模块的四个核心函数:dumps、dump、loads和load。dumps将Python对象转为JSON字符串,loads将JSON字符串转为Python对象;dump和load则专门用于文件读写操作。通过代码示例清晰展示内存数据与文件数据的处理差异,帮助开发者正确使用JSON序列化与反序列化功能。
本文深入解析 Flask 框架中蓝图(Blueprint)的核心机制,通过具体代码示例展示如何拆分路由、解决模块命名冲突及跨域配置问题。文章重点剖析了初学者在模块化重构时容易遇到的函数重名报错、路由注册顺序及跨域预检失败等常见陷阱,并提供标准化的代码结构建议,帮助开发者构建可维护的大型 Web 应用。
本文详细介绍Python标准库pickle模块的使用方法,涵盖dumps、loads、dump和load四个核心函数的语法与参数。通过具体代码示例,演示如何将Python对象序列化为二进制数据并存储至文件或内存,实现对象的持久化与恢复。同时指出pickle在并发和高性能场景下的局限性,并推荐ZODB作为替代方案。
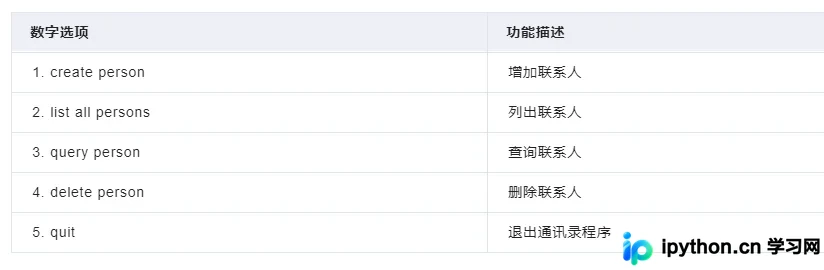
本文详解 Python 函数与模块化程序设计概念,通过自顶向下设计方法,构建一个包含增删改查功能的通讯录管理系统。文章解析字典与列表的数据结构应用,提供完整的 Python 代码实现及命令行交互演示,帮助开发者理解函数在提升代码可读性与维护性中的作用。
本文详解Python3中shelve模块的使用方法。shelve是pickle的封装,支持将字典数据持久化到文件,并可多次dump和load。通过示例展示如何保存列表、字典和时间对象,以及如何生成.bak、.dat、.dir文件并读取数据。
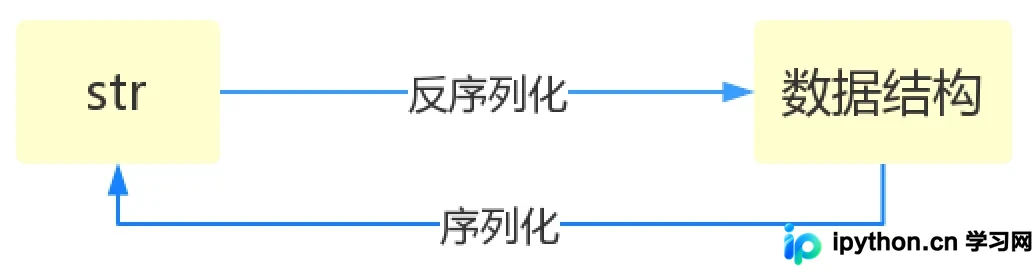
本文详解Python中json与pickle模块的数据序列化操作。对比两者在文本/二进制、可读性及互操作性上的差异,并演示dumps、dump、loads、load四个核心函数的具体用法与代码示例,帮助开发者根据场景选择合适的序列化方案。



