



如果你已经用 Scrapy 写过最基础的列表抓取,下一步通常不是“再多抓几个字段”,而是把列表页、详情页、分页和落库串成一条完整链路。这篇文章就围绕这个目标,把一个抓取慕课网全部免费课程的示例重新梳理一遍:先看 Spider 如何按课程类型展开,再看详情字段和学习人数怎样补齐,最后落到 Item、Pipeline 和 MySQL 表结构,方便你判断这套写法能否直接迁移到自己的项目里。
Spider 如何把免费课程完整抓下来
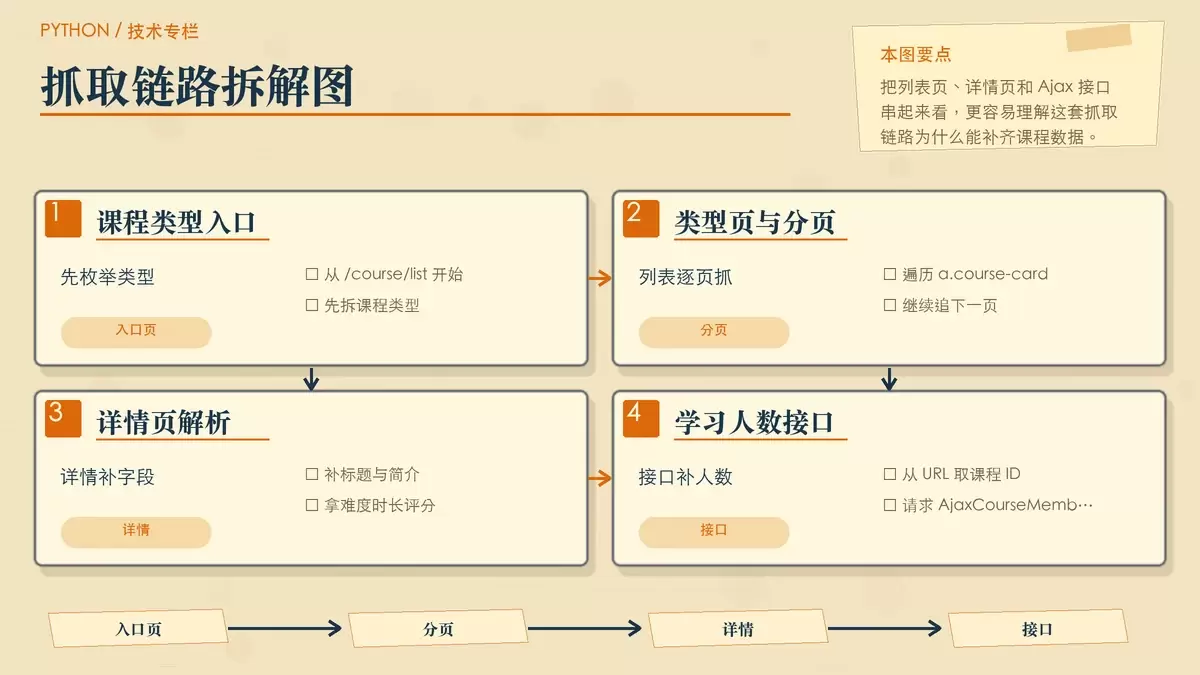
这部分的核心不是单页抓取,而是把“课程类型列表 - 课程卡片列表 - 课程详情页 - 学习人数接口”四层数据串起来。原始入口仍然只有一个课程列表页,但真正的抓取范围,是按类型拆分后的所有免费课程。
入口页负责拆分课程类型
Spider 的入口设置比较直接,依然从 http://www.imooc.com/course/list 开始,并限制在 www.imooc.com 域名内抓取。这里的重点在于:parse 并不直接处理课程详情,而是先从导航区域里取出课程类型,再把每一种类型交给下一级回调处理。
# -*- coding: utf-8 -*-

import scrapy
import json
from urllib import parse as urlparse
from scrapyDemo.ImoocCourseItem import ImoocCourseItem

# 慕课网爬取
class ImoocSpider(scrapy.Spider):
    # spider的名字定义了Scrapy如何定位(并初始化)spider,所以其必须是唯一的
    name = "imooc"

    # URL列表
    start_urls = ['http://www.imooc.com/course/list']
    #  域名不在列表中的URL不会被爬取。
    allowed_domains = ['www.imooc.com']

    def parse(self, response):
        # 课程类型
        types = response.css('div.course-content .course-nav-row')[2].css(
            '.bd ul li a')
        for key in range(len(types)):
            if key == 0:
                continue
            course_type = types[key].css('::text').extract_first()
            # 类型的url
            type_url = types[key].css('::attr(href)').extract_first()
            # print (item)
            yield scrapy.Request(
                url=urlparse.urljoin(response.url, type_url),
                callback=self.parse_by_type,
                meta={
                    'course_type': course_type
                })
这里有两个值得注意的点。
第一,代码通过 response.css('div.course-content .course-nav-row')[2] 直接拿第三组导航,这说明作者预设“课程类型”就在这个位置。第二,meta 里先传入 course_type,这样后续翻页和详情抓取时,就不用重复回头解析类型文本。
列表页负责课程卡片与分页
进入某个课程类型后,parse_by_type 负责两件事:一是遍历当前页的课程卡片,先拿到课程地址、封面图和分类;二是继续追踪“下一页”,直到这个类型下的课程抓完为止。
    # 按课程类型爬取
    def parse_by_type(self, response):
        itemBase = response.meta
        item = ImoocCourseItem()
        item['course_type'] = itemBase['course_type']
        # print(item)
        learn_nodes = response.css('a.course-card')
        # 遍历该页上所有课程列表
        for learn_node in learn_nodes:
            course_url = learn_node.css("::attr(href)").extract_first()
            # 拼接课程详情页地址
            course_url = urlparse.urljoin(response.url, course_url)
            # 课程地址
            item['course_url'] = course_url
            # 课程图片
            item['image'] = learn_node.css(
                "img.course-banner::attr(src)").extract_first()
            # 分类
            cate = learn_node.css("div.course-label label::text").extract()
            item['cate'] = ','.join(cate)
            # 进入课程详情页面
            yield scrapy.Request(
                url=course_url, callback=self.parse_learn, meta=item)

        # 下一页地址
        next_page_url = response.css(
            u'div.page a:contains("下一页")::attr(href)').extract_first()
        if next_page_url:
            yield scrapy.Request(
                url=urlparse.urljoin(response.url, next_page_url),
                callback=self.parse_by_type,
                meta={
                    'course_type': item['course_type']
                })
从抓取路径看,这一步已经解决了“怎么遍历全部免费课程”的问题,因为每个课程类型都会递归翻页。
而从字段拆分看,列表页先取的是适合在卡片上直接拿到的信息,包括:
- 课程地址
course_url - 课程图片
image - 课程分类
cate - 课程类型
course_type
这么做的好处很明确:列表页能拿到的先拿,详情页再补充更深的字段,避免一次回调里塞太多解析逻辑。
不过这段写法也有一个实际使用时要留心的地方:item = ImoocCourseItem() 定义在循环外,随后在 for learn_node in learn_nodes 里不断改写字段,再把 item 通过 meta 传到详情页。示例里这样写能表达流程,但如果你准备长期运行或并发抓取,通常会更稳妥地在循环内为每个课程单独创建一个 item,避免不同请求之间共享同一对象。
详情页和接口页分别补哪些字段
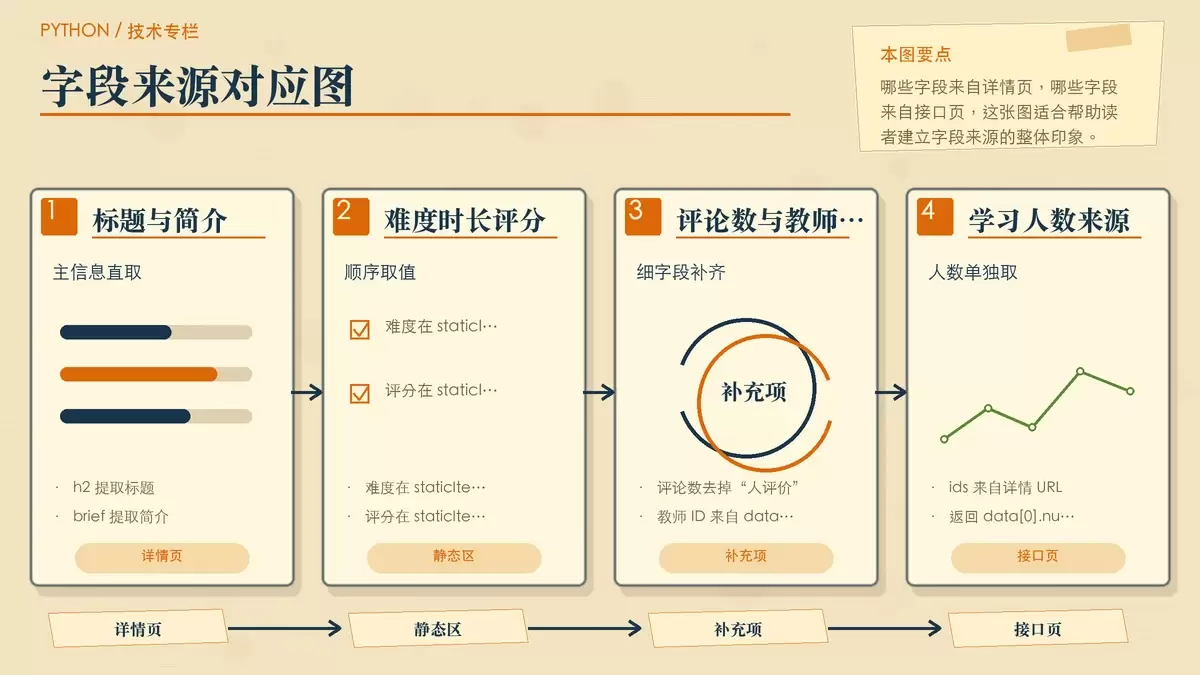
列表页只解决“有哪些课程”,真正让数据完整起来的,是详情页解析和 Ajax 接口补数。这个示例把两部分拆得比较清楚:详情页拿结构化文本,接口页拿动态学习人数。
详情页补齐标题、简介、难度、时长、评分和评论数
进入课程详情页后,parse_learn 会继续完善课程数据。这里抓到的字段,基本就是用户在课程页上最关心的主信息。
    # 课程详情
    def parse_learn(self, response):
        item = response.meta
        # 课程标题
        item['title'] = response.xpath(
            '//h2[@class="l"]/text()').extract_first()
        # 课程简介
        item['brief'] = response.xpath(
            '//div[@class="course-brief"]/p/text()').extract_first()

        staticItem = response.css(
            'div#main div.statics div.static-item span.meta-value::text'
        ).extract()
        # 难度级别
        item['difficulty_level'] = staticItem[0]
        # 课程时长
        item['duration'] = staticItem[1]
        # 综合评分
        item['overall_rating'] = staticItem[2]
        # 评论数
        item['evaluation_number'] = response.css(
            'a.person-num span.person-num::text').extract_first().replace(
                '人评价', '')
        # 教师id
        item['teacher_id'] = response.css(
            'div.teacher-info a img::attr(data-userid)').extract_first()
        # 学习人数
        ids = response.url.split('/')[-1]
        yield scrapy.Request(
            url=urlparse.urljoin(response.url,
                                 '/course/AjaxCourseMembers?ids=' + ids),
            callback=self.parse_learn_num,
            meta=item)
这一段字段来源可以分成三类来理解:
- 标题和简介:直接用 XPath 定位课程页主体内容。
- 难度、时长、综合评分:通过
div.statics下的meta-value一次性提取,再按下标写回字段。 - 评论数和教师 ID:分别从评论人数节点和讲师信息节点提取。
其中 staticItem[0]、staticItem[1]、staticItem[2] 这种写法很直接,适合示例教学,但它默认页面结构和顺序保持稳定。一旦站点把“难度、时长、评分”的排列顺序改了,数据就可能错位。所以你在自己项目里复用时,最好确认目标站点的页面结构是否足够固定。
学习人数通过 Ajax 接口补齐
示例里有一个很实用的处理:学习人数不是直接从详情页静态 HTML 提取,而是从 Ajax 接口单独获取。课程 ID 通过详情页 URL 最后一段拿到,再拼接到接口地址后发起请求。
    # 爬取学习人数
    def parse_learn_num(self, response):
        item = response.meta
        data = json.loads(response.body_as_unicode())
        # 学习人数
        item['learn_num'] = data['data'][0]['numbers']
        # print (item)
        yield item
配合上一步的代码,这里的接口完整路径是:
/course/AjaxCourseMembers?ids=课程ID这样做的意义在于,Spider 最终输出的不是“课程详情页上能直接看见的字段”,而是一份更完整的数据记录。按这套流程,单条课程至少包含:
- 标题
title - 图片
image - 简介
brief - 分类
cate - 课程类型
course_type - 课程地址
course_url - 学习人数
learn_num - 难度级别
difficulty_level - 课程时长
duration - 综合评分
overall_rating - 评论数
evaluation_number - 教师 ID
teacher_id
如果你的目标也是做课程聚合、数据分析或者后续推荐,这种“列表页 + 详情页 + 接口页”拼装字段的方式,比只抓单页要实用得多。
Item、Pipeline 和 MySQL 表结构怎样对应
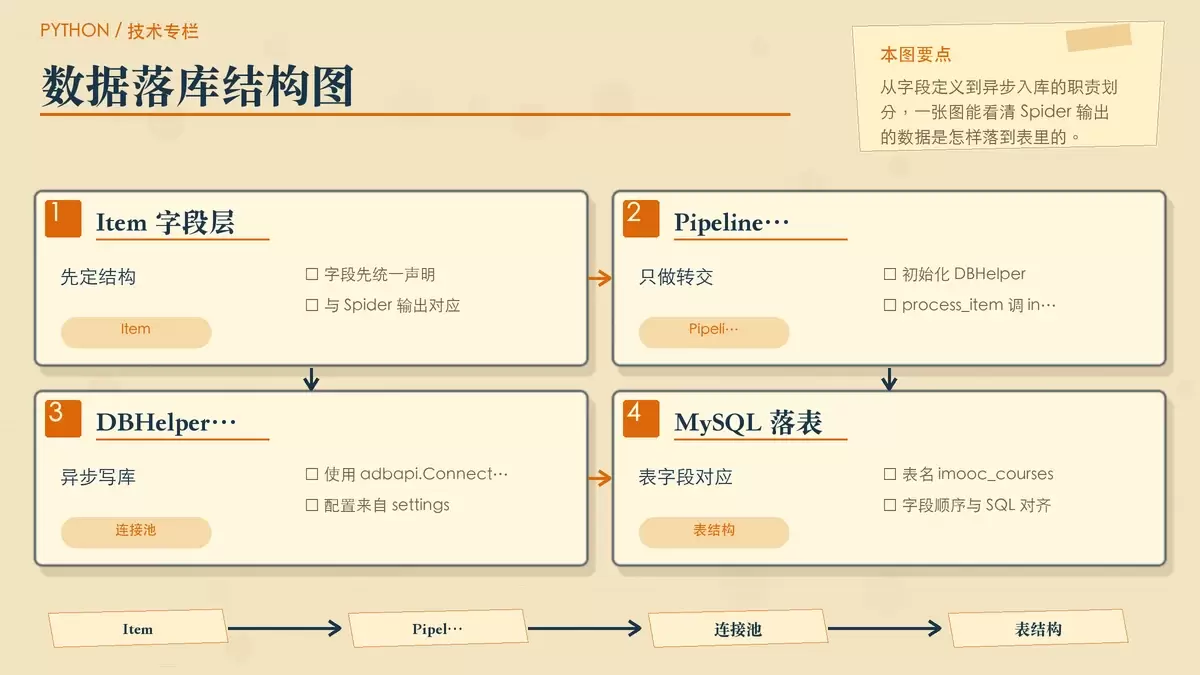
当 Spider 把字段收集完整后,后面的重点就是“如何稳定落库”。这个示例没有做复杂清洗,而是保持字段一一对应,方便从抓取结果直接入表。
Item 先声明完整字段
Item 的作用很简单,就是把要输出的数据结构提前定义出来,避免 Spider 和 Pipeline 各自随手拼字段。
# -*- coding: utf-8 -*-

# Define here the models for your scraped items
#
# See documentation in:
# http://doc.scrapy.org/en/latest/topics/items.html

import scrapy

class ImoocCourseItem(scrapy.Item):
    # define the fields for your item here like:
    title = scrapy.Field()
    image = scrapy.Field()
    brief = scrapy.Field()
    cate = scrapy.Field()
    course_type = scrapy.Field()
    course_url = scrapy.Field()
    learn_num = scrapy.Field()
    difficulty_level = scrapy.Field()
    duration = scrapy.Field()
    overall_rating = scrapy.Field()
    evaluation_number = scrapy.Field()
    teacher_id = scrapy.Field()
    pass
这里的字段和前面 Spider 中填充的内容是一一对应的,因此后续写数据库时不需要额外映射层,逻辑会比较直。
Pipeline 只做一件事:把 item 交给数据库助手
在 Pipeline 这一层,示例保持了很轻的职责划分:连接数据库辅助类在初始化时完成,真正进入 process_item 后,只负责调用插入方法。
# -*- coding: utf-8 -*-

# Define your item pipelines here
#
# Don't forget to add your pipeline to the ITEM_PIPELINES setting
# See: http://doc.scrapy.org/en/latest/topics/item-pipeline.html

from scrapyDemo.db.dbhelper import DBHelper

class ScrapydemoPipeline(object):
    # 连接数据库
    def __init__(self):
        self.db = DBHelper()

    def process_item(self, item, spider):
        # 插入数据库
        self.db.insert(item)
        return item
这类写法的优点是边界清楚。Spider 只管抓数据,Pipeline 只管把数据交出去,真正的 SQL、连接池和异常处理都放在数据库工具类里。
建表语句与异步写库代码
示例中给出的 MySQL 表结构如下,字段设计基本和 Item 对齐,适合直接保存课程信息。
CREATE TABLE `imooc_courses` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `title` varchar(255) DEFAULT NULL,
  `cate` varchar(255) DEFAULT NULL,
  `type` varchar(11) DEFAULT NULL,
  `image` varchar(255) DEFAULT NULL,
  `brief` varchar(255) DEFAULT NULL,
  `course_url` varchar(255) DEFAULT NULL,
  `learn_num` int(11) DEFAULT '0',
  `difficulty_level` varchar(255) DEFAULT NULL,
  `duration` varchar(255) DEFAULT NULL,
  `overall_rating` varchar(255) DEFAULT NULL,
  `evaluation_number` int(11) DEFAULT '0',
  `teacher_id` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=792 DEFAULT CHARSET=utf8mb4;
实际写库则交给 DBHelper 完成。这里使用了 twisted.enterprise.adbapi 和 pymysql,从项目配置中读取数据库连接信息,再通过连接池执行异步插入。
# -*- coding: utf-8 -*-

import pymysql
from twisted.enterprise import adbapi
from scrapy.utils.project import get_project_settings  #导入seetings配置
import time

class DBHelper():
    '''这个类也是读取settings中的配置,自行修改代码进行操作'''

    def __init__(self):
        settings = get_project_settings()  #获取settings配置,设置需要的信息

        dbparams = dict(
            host=settings['MYSQL_HOST'],  #读取settings中的配置
            db=settings['MYSQL_DBNAME'],
            user=settings['MYSQL_USER'],
            passwd=settings['MYSQL_PASSWD'],
            port=settings['MYSQL_PORT'],
            charset='utf8',  #编码要加上,否则可能出现中文乱码问题
            cursorclass=pymysql.cursors.DictCursor,
            use_unicode=False,
        )
        #**表示将字典扩展为关键字参数,相当于host=xxx,db=yyy....
        dbpool = adbapi.ConnectionPool('pymysql', **dbparams)

        self.dbpool = dbpool

    def connect(self):
        return self.dbpool

    #创建数据库
    def insert(self, item):
        sql = "insert into imooc_courses(title,type,cate,image,brief,course_url,learn_num,difficulty_level,duration,overall_rating,evaluation_number,teacher_id) values(%s,%s,%s,%s,%s,%s,%s,%s,%s,%s,%s,%s)"
        #调用插入的方法
        query = self.dbpool.runInteraction(self._conditional_insert, sql, item)
        #调用异常处理方法
        query.addErrback(self._handle_error)

        return item

    #写入数据库中
    def _conditional_insert(self, tx, sql, item):
        params = (item["title"], item['course_type'],item['cate'], item['image'], item['brief'],
                  item['course_url'], item['learn_num'],
                  item['difficulty_level'], item['duration'],
                  item['overall_rating'], item['evaluation_number'],
                  item['teacher_id'])
        tx.execute(sql, params)

    #错误处理方法

    def _handle_error(self, failue):
        print('--------------database operation exception!!-----------------')
        print(failue)
从实现上看,有几处信息是明确的:
- 数据库配置来自
settings,包括MYSQL_HOST、MYSQL_DBNAME、MYSQL_USER、MYSQL_PASSWD、MYSQL_PORT。 - 字符集设置为
utf8,注释里也明确说明是为了避免中文乱码。 - 插入 SQL 使用参数化占位符
%s,字段顺序与表结构、Item 字段基本一致。 - 异常通过
addErrback交给_handle_error处理。
如果你准备把这个例子继续扩展,下一步通常会考虑去重、更新策略和字段容错,但就“把慕课网免费课程完整抓下来并保存到数据库”这个目标而言,这套结构已经足够清晰。
运行命令与这套示例的实际适用范围
代码准备完成后,运行命令仍然只有一条:
scrapy crawl imooc执行后,Spider 会从课程列表入口出发,先枚举课程类型,再逐页抓取课程卡片,随后进入详情页补充课程信息,最后通过 Ajax 接口获取学习人数,并通过 Pipeline 写入 MySQL。
把这篇示例重新拆开来看,它最适合帮助你理解三个问题:
- 当一个站点既有列表页又有详情页时,Scrapy 应该如何分阶段抓取。
- 当部分字段不在静态 HTML 中时,怎样继续追 Ajax 接口补齐数据。
- 当抓取结果需要长期保存时,如何用 Item、Pipeline 和数据库工具类把流程接起来。
如果你只是想练习 Scrapy 的基本请求与解析,这个案例已经覆盖了列表遍历、分页、详情页回调、接口请求、meta 传参和异步入库等关键环节。相比单纯抓一个页面,它更接近真实项目里“把一类内容完整采集下来”的工作方式。















