



在 pandas 里处理大规模字符串列,很多慢和错并不是因为正则太复杂,而是把逐行 re.search/re.sub 当成了默认方案。下面按提取、替换、内存控制和超大规模处理四个场景展开,帮助你判断什么时候该用向量化字符串方法、哪些参数会拖慢速度,以及哪些返回结果和空值细节最容易埋坑。
提取时,优先用 Series.str.extract 代替逐行 re.search
如果面对的是百万级字符串列,逐行调用 re.search 往往是最先该淘汰的写法。问题不只是正则匹配本身,而是 Python 解释器在循环中的函数调用开销太高。相比之下,pandas.Series.str.extract 走的是底层向量化实现,通常能比循环方案快 5–10 倍。
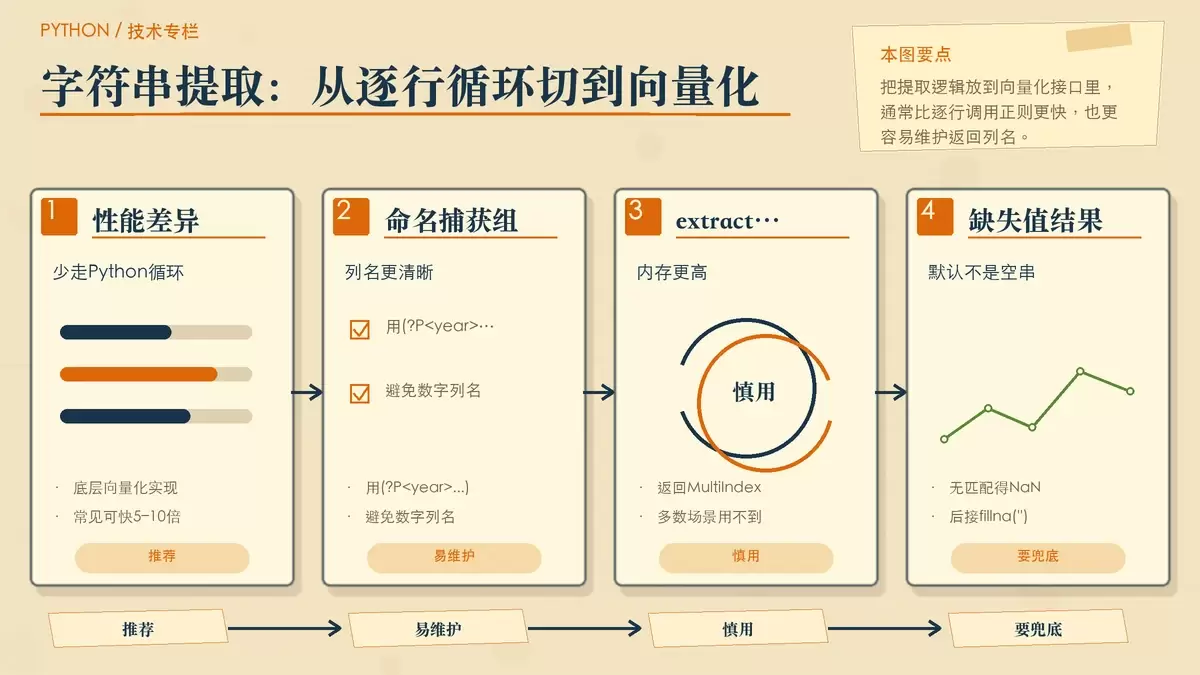
这类提取场景里,正则最好直接写成带命名捕获组的形式。比如使用 (?P<year>\d{4}),后续返回结果会带上清晰列名;如果只写普通捕获组,结果列通常是数字索引,短期能跑,长期维护会越来越难。
另一个常见误区是把 extractall 当成通用提取工具。它适合“一行里要拿到多个匹配”的场景,但返回的是长格式 MultiIndex 结果,内存占用明显更高。若你只关心每行的单个匹配值,应直接使用 extract。
extract 本身还有一个很容易被忽略的行为:无匹配时会填充为 NaN。如果业务需要默认值,比如空字符串,应该显式接上 .fillna(''),而不是去找一个并不存在的 default 参数。
result = s.str.extract(r'(?P<year>\d{4})', expand=False).fillna('')这类写法既保留了向量化性能,也让返回结构更贴近后续处理需求。
替换时,优先用 str.replace,少用 apply + re.sub
字符串替换也是同样的道理。Series.str.replace 会复用底层编译缓存,并避开 Python 层逐个调用函数的成本;而 apply(lambda x: re.sub(...)) 不仅有额外函数调用开销,如果没有显式预编译正则,还会重复触发编译。
如果只是简单字面量替换,比如把所有 'abc' 换成 'xyz',直接传字符串通常就是最快的选择。pandas 对这种情况做了专门优化,没有必要为了“统一风格”强行传 re.compile 对象。
但当替换规则是复杂正则时,预编译就变得很重要。建议先写:
import re

pattern = re.compile(r'\s+')
out = s.str.replace(pattern, ' ')
这样可以避免每次调用时重复 compile。对于长列、大批量数据和频繁重复任务,这类差异会被放大。
还有一个容易造成误解的细节:不要把 regex=False 当成“完全绕开正则”的按钮。它只是禁用元字符解释,底层并不等于换了一套完全不同的处理路径。如果需求本来就是纯字面替换,最直接的方式仍然是传普通字符串,而不是在参数层面制造额外理解成本。
想省内存和减少隐性报错,重点看 expand、flags 和空值
很多性能问题不是出在模式本身,而是出在返回结构和参数传法上。比如 str.extract(..., expand=True) 默认会返回 DataFrame。如果你其实只提取一组内容,这就相当于多包了一层结构,增加了内存和拷贝成本。
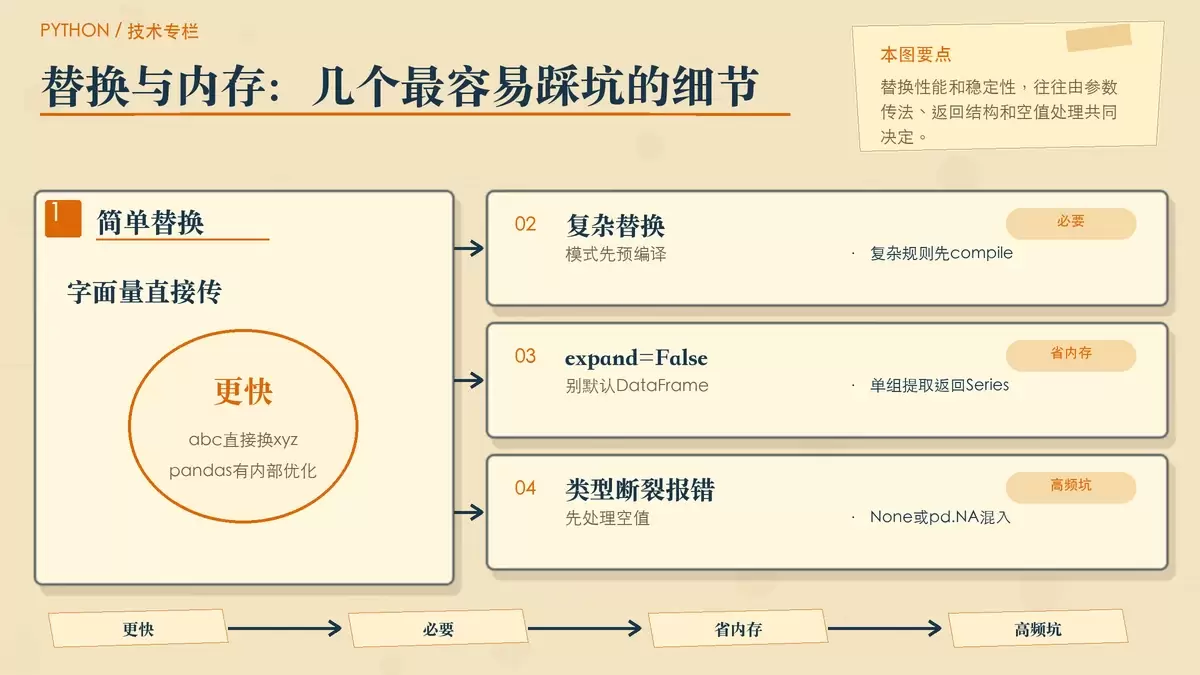
单列提取场景里,更适合显式指定 expand=False。这样返回的是 Series,后面无论接 .astype(int)、.fillna('') 还是链式赋值,都会更顺手。
year = s.str.extract(r'(?P<year>\d{4})', expand=False)
year = year.astype(int)
flags 也是一个常被低估的性能点。如果每次调用都单独传 flags=re.I 这类参数,pandas 更难稳定复用已有编译结果。更稳妥的方式,是直接把标志写进正则表达式,例如用 r'(?i)hello' 代替 r'hello' + flags=re.I。
相比性能,更麻烦的是空值导致的类型断裂。原始列里如果混有 pd.NA 或 None,str.extract 通常会跳过处理并保留缺失;但 str.replace 在某些情况下可能直接报错,典型表现就是:
AttributeError: 'float' object has no attribute 'replace'这类问题往往比语法错误更难查,因为它不是正则没写对,而是列中已经混入了非字符串值。较稳妥的做法,是在替换前先做一次兜底处理:
clean = s.fillna('')
out = clean.str.replace('abc', 'xyz')
如果是字面替换场景,也可以结合 regex=False 使用,但前提仍然是你明确知道当前处理的是纯文本替换,而不是正则规则。
数据上到千万级,再考虑 dask 或 modin
当数据量继续扩大到千万级以上,单机内存可能先于 CPU 成为瓶颈。这时再讨论 pandas 某个参数快几个百分点,意义就没那么大了。更实际的方向,是评估是否要改用 dask 或 modin 这类分块或并行方案。
前提是你的正则逻辑不依赖跨行上下文。例如,不需要围绕整列做全局 lookbehind/lookahead 匹配时,按分区处理会更容易落地。两者里,modin.pandas 的接口通常更接近 pandas,很多 str.extract/str.replace 代码可以少改甚至不改直接运行;但像 flags 这类参数,兼容性细节仍然要实测,不能默认完全一致。
如果你自己切分数据,也要避免一种常见伪并行:用 df.iloc[i:j] 切片后继续 apply。这本质上还是串行循环,只是把大循环切成了小循环。更合理的思路,是使用分区级接口,例如:
df.partitions[n].str.extract(...)

df.map_partitions(lambda x: x.str.extract(...))
不过,真正在超大规模场景里决定总耗时的,往往还是正则本身的复杂度。一个以 .* 开头的贪婪模式,在千万行上可能比十个简单模式还慢。与其急着改框架,不如先对单条正则做 profile,确认瓶颈究竟在匹配器、数据分布,还是返回结果结构。
真正影响效果的,不只是 API 选择
回头看这类任务,最值得优先处理的通常有三件事:一是把逐行 re.search/re.sub 换成 pandas 的向量化字符串方法;二是明确返回结果到底该是 Series 还是 DataFrame;三是提前处理好空值,避免在替换阶段触发隐蔽的类型错误。
很多卡顿和报错,并不是因为正则语法难,而是对这些默认行为没有形成预期。只要先把提取、替换、返回结构和空值边界理顺,处理大规模字符串列时,性能和可维护性通常都会比“循环加正则函数”稳定得多。















