


Python中单下划线和双下划线变量名的区别

在Python开发中,下划线并非简单的字符修饰,而是解释器解析机制与社区工程规范的核心载体。单下划线与双下划线在放置位置(前导、末尾、双侧)不同的情况下,承担着截然不同的语义职能:从提示内部使用的团队约定,到防止子类继承覆盖的名称修饰(Name Mangling),再到语言底层的魔术方法保留字。理解它们的本质差异,能够直接避免变量污染、属性遮蔽以及不规范的代码重构风险。
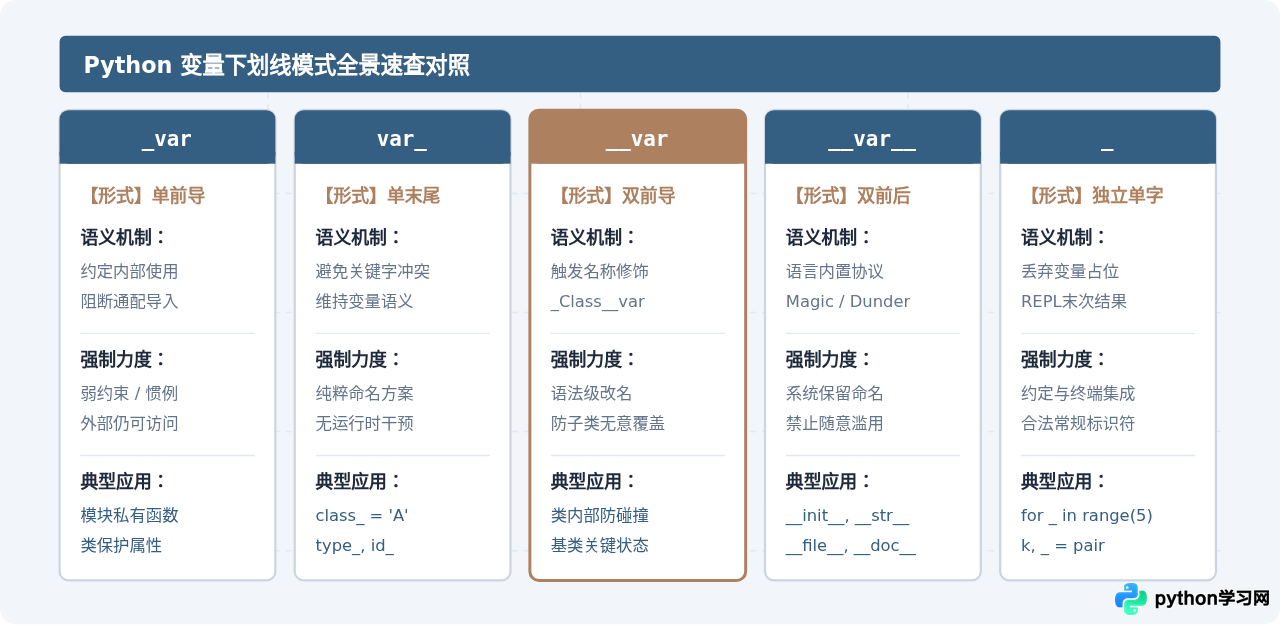
一、单前导下划线(_var):非强制定约与模块过滤
在变量或函数名前增加单个前导下划线(例如 _internal_cache 或 _calculate_sum()),在Python中主要表达“供内部使用”的提示性约定(PEP 8)。与 Java 或 C++ 中的 private/protected 关键字不同,Python解释器不会在语法层面阻止外部代码直接读取或修改该变量。
1. 类作用域中的提示性封装
当在类中定义 self._status 时,它表明该属性是类的实现细节,公共API调用者不应直接依赖它,但在实例外部访问它完全不会触发报错:
class NetworkConnector:
    def __init__(self, host, port):
        self.host = host          # 公开属性
        self.port = port          # 公开属性
        self._retry_count = 0     # 约定内部属性,不建议外部直接操作

connector = NetworkConnector("127.0.0.1", 8080)
# 外部仍然可以无阻碍读取与赋值(仅破坏约定,不破坏语法)
print(connector._retry_count)  # 示例输出: 0
connector._retry_count = 3
print(connector._retry_count)  # 示例输出: 3
2. 模块作用域对通配符导入的拦截
单前导下划线在模块层级具有真实的运行时拦截行为:当使用 from module import * 导入模块时,所有以单前导下划线开头的变量、函数和类都不会被导入当前命名空间。不过,显式指定名称的导入(如 from module import _internal_func)或直接通过模块名访问(module._internal_func)依然有效。
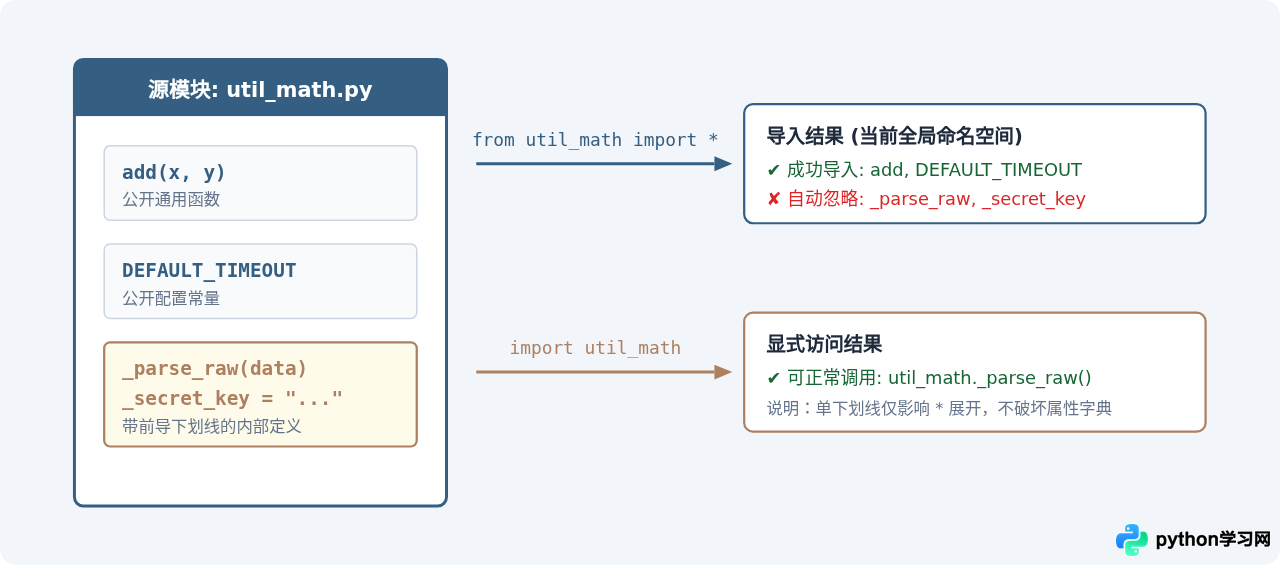
工程注意点:若模块中显式定义了 __all__ = ['_parse_raw'],则通配符导入将完全遵循 __all__ 列表的内容,即使变量带单下划线也会被强制导出。因此,单下划线仅作为默认规则起效。
二、单末尾下划线(var_):规避关键字命名冲突
在Python中,诸如 class、def、in、type、id、format 等单词属于保留关键字或高频内置函数名。当业务逻辑客观需要使用这些词汇作为参数名或属性时,PEP 8 推荐在词尾追加一个单下划线(例如 class_),以避免语法冲突。
# 场景:ORM框架中定义HTML元素类,需要接收 class 属性
def create_div_element(content, class_=None, id_=None):
    attributes = []
    if class_ is not None:
        attributes.append(f'class="{class_}"')
    if id_ is not None:
        attributes.append(f'id="{id_}"')
    attr_str = " " + " ".join(attributes) if attributes else ""
    return f"<div{attr_str}>{content}</div>"

# 调用示例
print(create_div_element("欢迎使用Python", class_="main-card", id_="card-01"))
# 示例输出: <div class="main-card" id="card-01">欢迎使用Python</div>
单末尾下划线完全不改变变量在解释器底层的寻址方式,它是一项纯粹的代码风格与语义保持方案。相比使用 clazz、my_class 或拼写缩写,末尾下划线既保留了最精准的命名意图,又杜绝了 SyntaxError。
三、双前导下划线(__var):名称修饰(Name Mangling)机制
以至少两个下划线开头、至多一个下划线结尾的属性名(如 __var),会触发 Python 解释器的名称修饰(Name Mangling)机制。解释器会自动将该属性重命名为 _ClassName__var。
1. 为什么需要名称修饰?
名称修饰的核心工程目的不是为了提供严格的私有化封装,而是为了防止基类属性被子类意外重写(Override)。在多层继承或大型继承体系中,子类开发者很可能无意中声明了与父类同名的内部状态变量,导致父类内部方法被破坏。
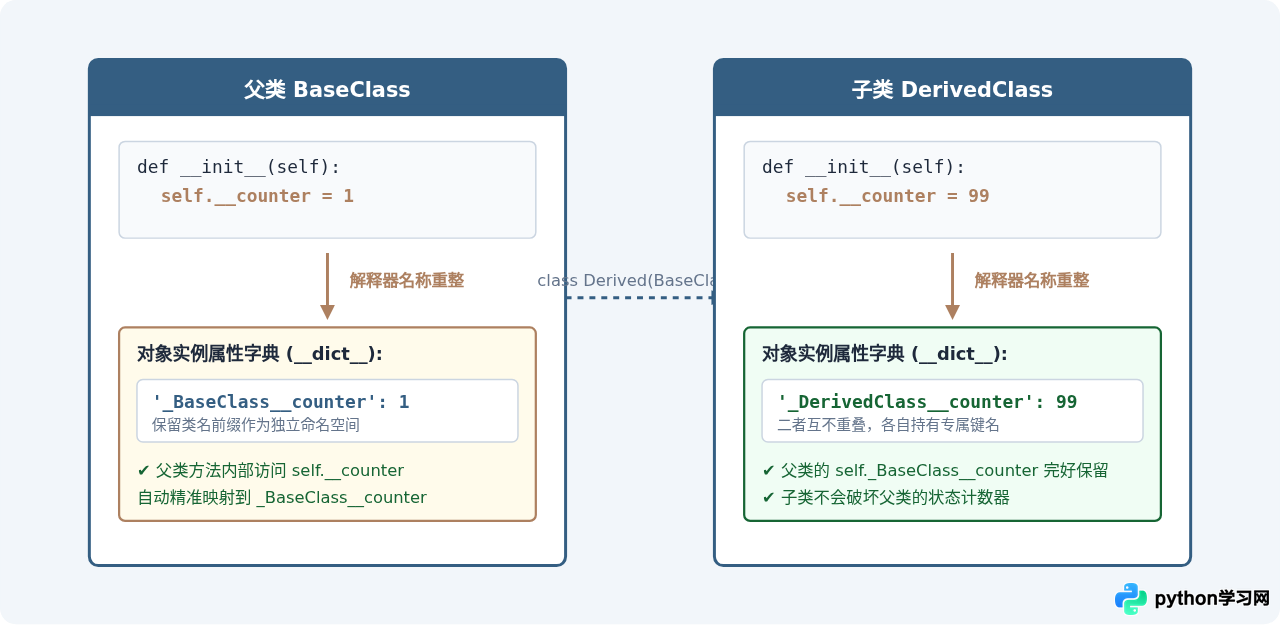
2. 代码验证与属性字典剖析
通过打印实例对象的 __dict__,可以直观观察到重整后的属性名称变化:
class DatabasePool:
    def __init__(self):
        self._pool_name = "MasterPool"  # 单下划线
        self.__max_conns = 50           # 双下划线

pool = DatabasePool()

# 打印实例所有的属性键值
print(pool.__dict__)
# 示例输出: {'_pool_name': 'MasterPool', '_DatabasePool__max_conns': 50}

# 直接访问 __max_conns 会触发 AttributeError
try:
    print(pool.__max_conns)
except AttributeError as err:
    print(f"捕获错误: {err}")
    # 示例输出: 捕获错误: 'DatabasePool' object has no attribute '__max_conns'

# 但通过修饰后的名称依然可以读取与修改(证明并非绝对安全保护)
print(pool._DatabasePool__max_conns)  # 示例输出: 50
四、双前后下划线(__var__):语言内置协议(Dunder / Magic)
以双下划线开头且以双下划线结尾的标识符被称为 Dunder(Double Underscore) 或 魔术属性/方法。这类名称在 Python 语法体系中拥有专有的核心地位,用于挂载各种底层协议:
- 对象生命周期控制:
__init__(初始化构造)、__new__(对象创建)、__del__(析构)。 - 运算与类型转换协议:
__str__、__repr__、__len__、__add__、__eq__。 - 上下文管理与迭代协议:
__enter__、__exit__、__iter__、__next__。 - 模块级元数据:
__file__、__name__、__doc__、__all__。
严谨编码准则:开发者应当仅在实现 Python 官方定义的魔术方法时使用双前后下划线,绝对不要为自定义的业务逻辑发明新的 __custom_name__。自定义的 Dunder 变量可能与未来 Python 版本新增的内置关键字发生同名碰撞,从而导致意外语法错误或行为异常。
五、单独立下划线(_):临时丢弃与交互计算
单个独立的下划线字符 _ 也是一个合法的 Python 标识符。在日常开发中,它承担两种明确的约定与环境行为:
1. 占位符与丢弃变量
当解构元组、列表或循环执行固定次数时,如果某些返回值后续完全不会被读取,使用 _ 能够明确告知代码阅读者与静态检查工具(如 flake8、mypy)该值已被丢弃,避免产生“未使用变量”的警告:
# 场景 1: 仅重复循环固定次数,无需关注索引值
for _ in range(3):
    print("Executing ping test...")

# 场景 2: 元组解包,只关注主体信息而忽略末尾扩展元数据
user_info = ("alice", "developer", 2026, "Shanghai", "Active")
username, role, *_, status = user_info
print(username, role, status)
# 示例输出: alice developer Active
2. 交互式解释器(REPL)的历史缓存
在 Python 交互式 Shell(终端 REPL)中,_ 变量由环境自动绑定为上一条表达式的运算结果:
>>> 125 * 8
1000
>>> _ + 50
1050
>>> f"Total is {_}"
'Total is 1050'
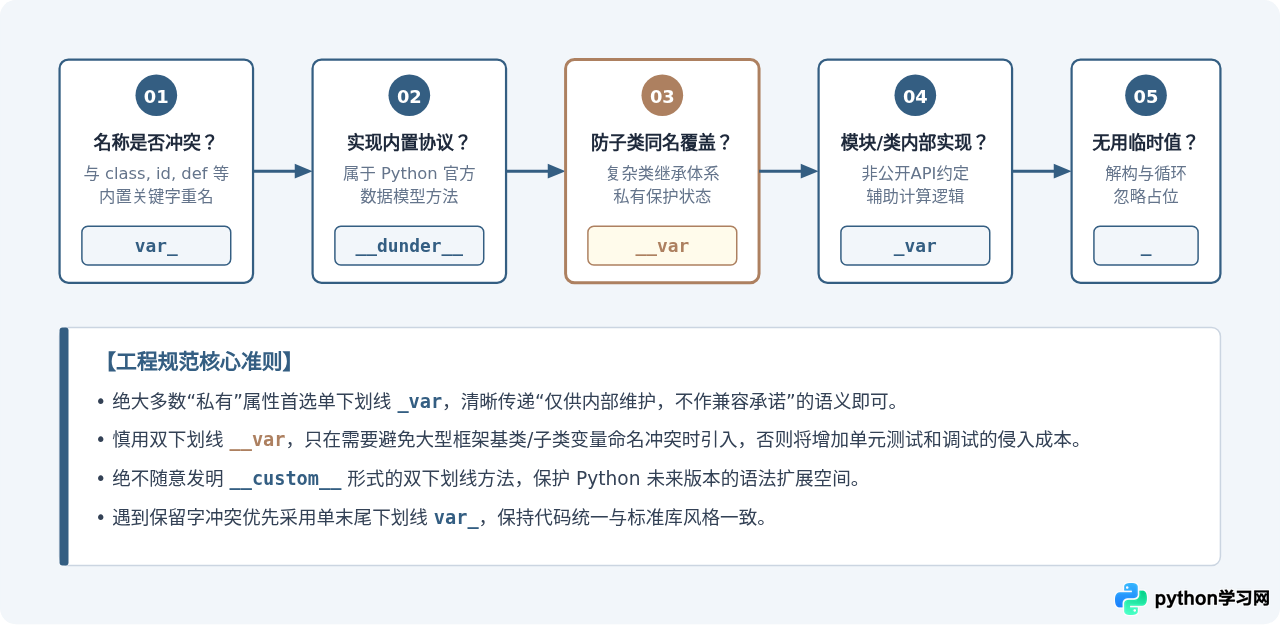
六、下划线命名工程决策流程
在实际项目开发中,选择何种下划线模式应建立在严格的工程意图之上。通过以下决策流程图,可以快速判断应该采用哪种命名方式:
七、总结对比矩阵
为了便于速查与团队代码审查,下表梳理了各类下划线命名的综合对比:
| 命名模式 | 典型示例 | 强制性约束 | 解释器底层机制 | 主要应用场景 |
|---|---|---|---|---|
| 单前导下划线 | _status, _helper() |
无语法阻拦(弱约束) | 阻止 from module import * 通配导入 |
标识内部方法、模块私有函数、类受保护属性 |
| 单末尾下划线 | class_, type_ |
无语法变动 | 普通标识符,完全无特殊干预 | 规避与 Python 内置关键字或标准函数的命名冲突 |
| 双前导下划线 | __secret, __hash |
语法级重整(强机制) | 触发 Name Mangling 重命名为 _Class__var |
深层继承体系中防止子类属性碰撞遮蔽 |
| 双前后下划线 | __init__, __call__ |
语言协议规范 | 绑定至底层数据模型或魔法钩子 | 实现 Python 官方定义的操作符重载或上下文管理 |
| 独立单下划线 | _ |
环境约定 | REPL 中缓存上次求值结果;代码中表示占位 | 迭代器无用索引占位、序列解包忽略值、交互计算 |
在日常 Python 编程中,应当建立“以约定优于强制、最小特权显式化”的命名习惯:以单前导下划线表达封装意向,以单末尾下划线解决关键字冲突,谨慎而精准地使用双前导下划线,从而让代码具备清晰的工程可读性与健壮的维护性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















