



做数据采集、清洗或批量报表处理时,Pandas 读 Excel 往往是最顺手的一步,但它也是不少脚本突然崩掉的起点。明明文件只有几百 KB,却在解析阶段直接抛出 MemoryError,甚至申请数 GiB 内存失败。要判断这是不是数据量本身过大,关键要看 Excel 的已用区域、DataFrame 的类型膨胀,以及循环处理中对象是否及时释放。
为什么小 Excel 也会触发 MemoryError
这类问题最常见的表现,是程序在读取 Excel 时直接报出大规模数组分配失败,错误信息里通常会反复出现一个非常醒目的数字:
Unable to allocate ... MiB for an array with shape (7, 1048478) and data type object
这个报错里有几个值得立刻注意的信号:
- 1,048,478 反复出现,它接近 Excel 2007 及之后版本的最大行数上限。
- 报错发生在“分配数组”阶段,说明问题不只是读取慢,而是内存峰值已经超出可承受范围。
- 文件体积可能并不大,但 Pandas 实际尝试读取的数据范围远超肉眼看到的有效内容。
也就是说,真正撑爆内存的,往往不是业务数据本身,而是 Excel 工作表里那些被错误视作“有效区域”的空白行和空白单元格。
内存溢出的根因在哪里
Excel 的“幽灵行”会扩大读取范围
很多 Excel 文件在人工编辑过程中,会在空行上留格式、敲过空格,或者做过不彻底的删除操作。对用户来说,这些区域看上去已经空了,但在 Excel 内部,它们仍可能被算进 UsedRange,也就是“已用区域”。
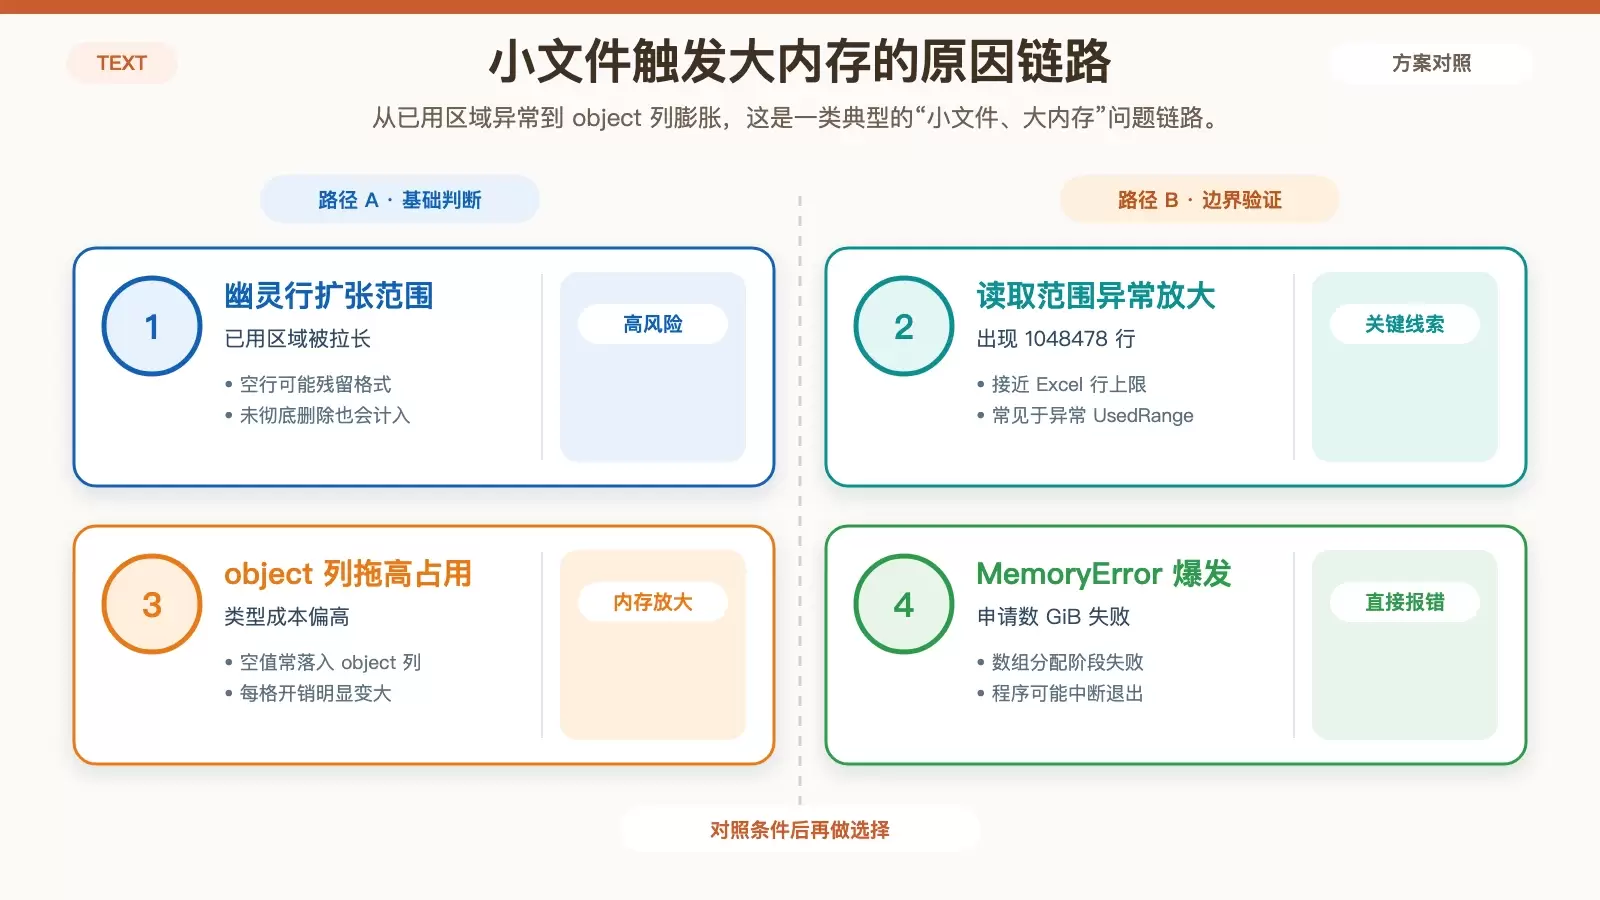
Pandas 的读取引擎在解析工作表时,往往会按这个区域去加载内容。结果就是:真正有值的只有几百行,实际却可能被当成上百万行来读入。
object 类型会放大空数据的内存成本
当这些“看起来空”的区域被读进 DataFrame 后,Pandas 往往会将其表示为 NaN。如果列里同时存在空值、混合类型或不规则内容,底层就更容易落到 object 类型。
object 列的内存成本远高于数值型列。单看几行数据似乎没有问题,但一旦行数放大到 104 万级别,即便只有少数几列,也足以把内存迅速推到数 GiB。
批量处理时,旧对象可能来不及释放
如果脚本是循环处理多个 Excel 文件、多个 Sheet,风险会进一步放大。前一个 DataFrame、文件句柄或中间对象还没来得及释放,后一个读取动作就已经开始申请新内存,峰值很容易被叠高。
这也是为什么有些脚本单次跑一个文件没问题,一旦进入批处理就开始随机崩溃。
三种最有效的优化方式
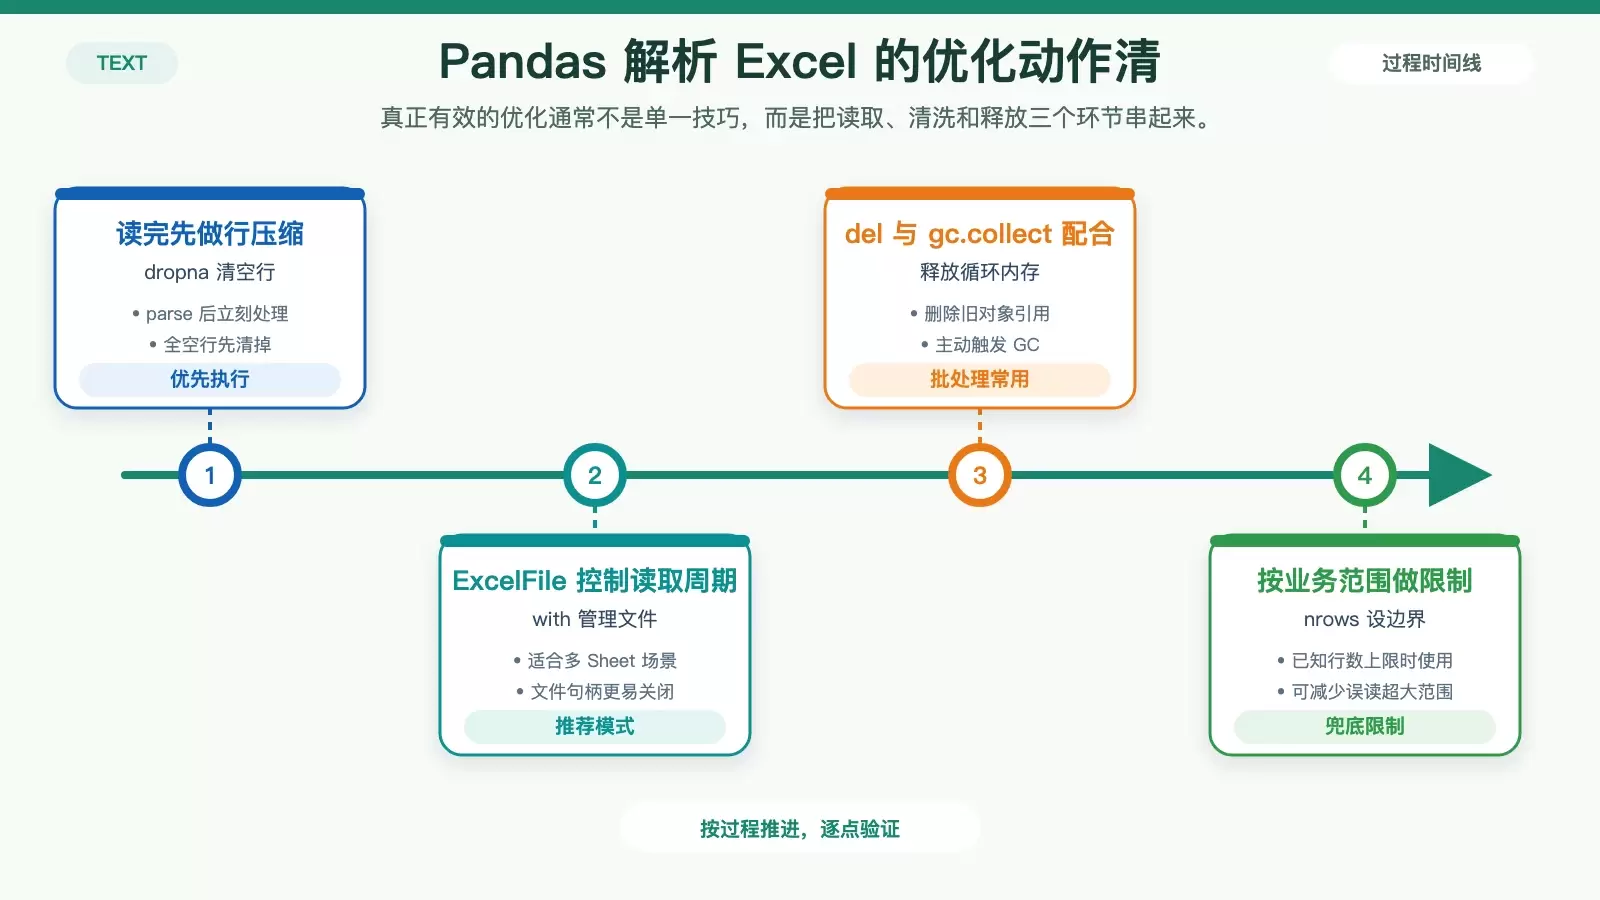
这类问题不一定需要复杂重构,通常把读取后的清洗、文件句柄管理和内存回收三件事做扎实,脚本稳定性就会明显提升。
1. 读入后立刻删除全空行
如果“幽灵行”已经被读进来了,第一步就不要让它们继续参与后续逻辑。最直接的方式,是在解析每个 Sheet 后立即做一次全空行清理:
import pandas as pd

# 假设 xl 是已经打开的 ExcelFile 对象
df = xl.parse(sheet_name)

# 核心代码:立即剔除全空行,防止百万级空数据撑爆内存
df.dropna(how='all', inplace=True)

if df.empty:
    # 如果剔除后没有数据,直接跳过处理
    return
这一步的价值在于尽早止损。哪怕不能减少读取时的首次内存申请,也能避免这些无效空行继续拖累后面的字段处理、拼接、导出和聚合计算。
2. 用 ExcelFile + with 管理读取过程
如果只是偶尔读取一个文件,pd.read_excel 用起来当然方便;但在需要遍历多个 Sheet,或者反复处理大量文件时,显式使用 pd.ExcelFile 更稳妥。
配合 with 语句,可以确保文件句柄在作用域结束时被及时关闭,减少资源滞留:
def process_excel(file_path):
    # 使用 with 确保文件句柄被正确关闭
    with pd.ExcelFile(file_path, engine='calamine') as xl:
        for sheet in xl.sheet_names:
            df = xl.parse(sheet)
            # 执行数据清洗与逻辑...
这里的重点不只是语法更规范,而是把“打开文件、遍历 Sheet、退出即释放资源”变成一个完整闭环。对于长期运行的自动化脚本,这种写法通常更可控。
3. 在循环里显式回收大对象
当 DataFrame 很大、文件很多,或者运行环境本身内存紧张时,仅依赖 Python 自动垃圾回收不一定够快。对象已经“不再使用”,不代表底层占用会立刻回落。
这时可以在每轮处理结束后,明确删除引用并触发垃圾回收:
import gc

# 1. 删除对象引用
del df

# 2. 强制触发垃圾回收,归还内存空间给系统
gc.collect()
这个做法特别适合批量任务。它未必能让单次读取更省内存,但能把多轮处理中的峰值尽量压平,避免内存一轮一轮累积上去。
批量处理 Excel 的实用避坑清单
如果要把这类问题尽量挡在脚本入口,下面几条可以直接当作日常规范使用:
| 场景 | 建议做法 |
|---|---|
| 文件读取 | 优先使用 with pd.ExcelFile(...),在多 Sheet 或批处理场景下比直接 read_excel 更利于资源管理。 |
| 清理空数据 | 每次读取后尽快执行 df.dropna(how='all'),尽早剔除整行空值。 |
| 批量循环 | 在循环内部对已处理完的 DataFrame 使用 del df,必要时再配合 gc.collect()。 |
| 读取兜底 | 如果业务上已知有效数据不可能超过某个范围,可以增加 nrows 作为硬性上限。 |
其中,nrows 虽然不是解决“幽灵行”的根本办法,但在结构稳定、行数预期明确的场景里,确实能作为一层简单有效的保险。
怎么判断问题是不是“幽灵行”导致的
如果你遇到的是“文件很小,但报错里行数接近 104 万,且 data type object 明显出现”的情况,那么大概率就不是正常数据量过大,而是工作表有效区域异常扩张造成的。
这类问题的处理顺序也很明确:先怀疑 Excel 的已用区域,再检查读取后是否及时清掉全空行,最后看批处理过程中是否存在对象和句柄滞留。把这三层控制住,Pandas 解析 Excel 时的 MemoryError 通常就能明显减少。















