



PHP-FPM 内存高并不罕见,尤其是在低配 VPS、共享主机或同时承载数据库服务的机器上,一旦内存被吃满,轻则响应变慢,重则被 OOM Killer 直接回收,网站出现白屏。真正有效的处理方式,不是只改一两个参数,而是先确认到底是不是 PHP-FPM 在占内存,再根据机器规格调整进程模型、缓存和系统参数。
下面按排查、配置、缓存、扩展、系统和监控几个层面展开。看完之后,你可以判断:当前瓶颈到底是 PHP-FPM 进程数过多、单进程内存过大、代码存在慢请求,还是系统本身的回收策略不合适。
先确认是不是 PHP-FPM 在吃内存
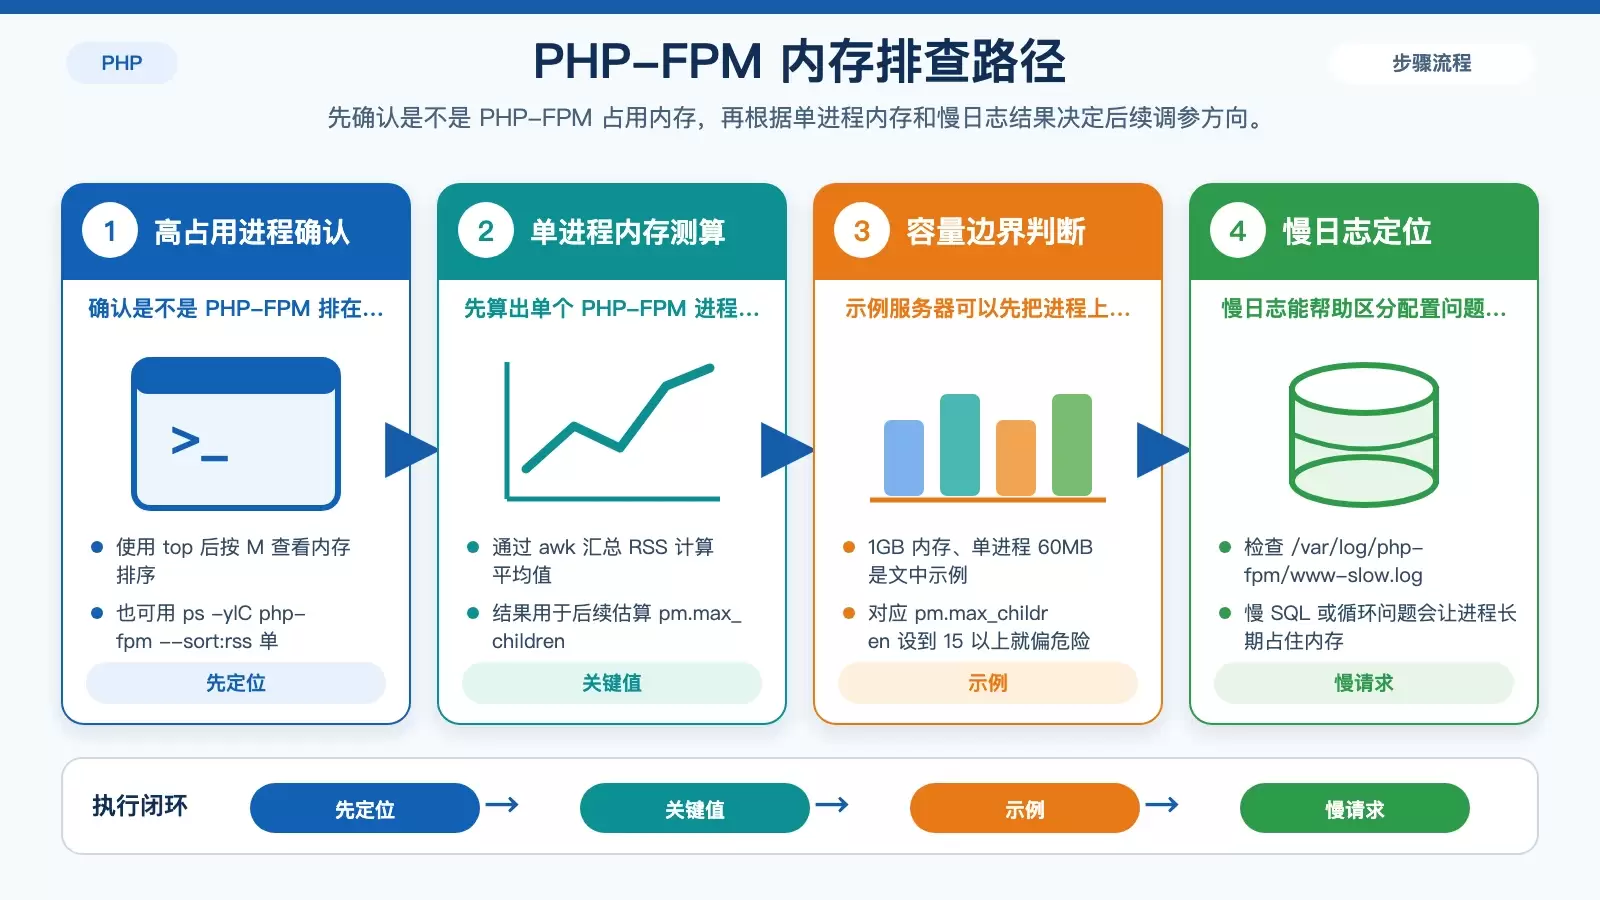
动手调优前,先把问题源头找准。高内存占用不一定就是 PHP-FPM,也可能是 MySQL、某个 Python 脚本,或者其他后台服务。
先看高占用进程排位
可以直接用 top,然后按 M 键,按内存占用排序。如果 php-fpm 长期排在前列,基本就能确认方向。
想看得更聚焦,可以用下面这条命令,单独列出 PHP-FPM 进程并按物理内存排序:
ps -ylC php-fpm --sort:rss算出单个进程平均吃多少内存
这个数值直接决定后面 pm.max_children 能设多大。可用命令如下:
ps --no-headers -o "rss,cmd" -C php-fpm | awk '{ sum+=$1 } END { printf ("%d%sn", sum/NR/1024,"M") }'例如一台 1GB 内存的服务器,平均每个 PHP-FPM 进程占用 60MB,那 pm.max_children 设到 15 以上通常就比较危险,因为系统和数据库也需要内存余量。
慢日志往往比配置更关键
如果某些请求执行时间特别长,进程就会长时间占住内存不释放。这类问题只靠调大或调小进程数很难根治。
优先检查慢日志,例如:
/var/log/php-fpm/www-slow.log不同 PHP 版本或发行版,路径可能略有变化。这里常能看到慢 SQL、死循环、批量处理脚本等线索。
核心是调好 PHP-FPM 进程池参数
大多数情况下,真正影响内存占用上限的,还是进程池配置。配置文件通常位于:
/etc/php/{version}/fpm/pool.d/www.conf先选对进程管理模式
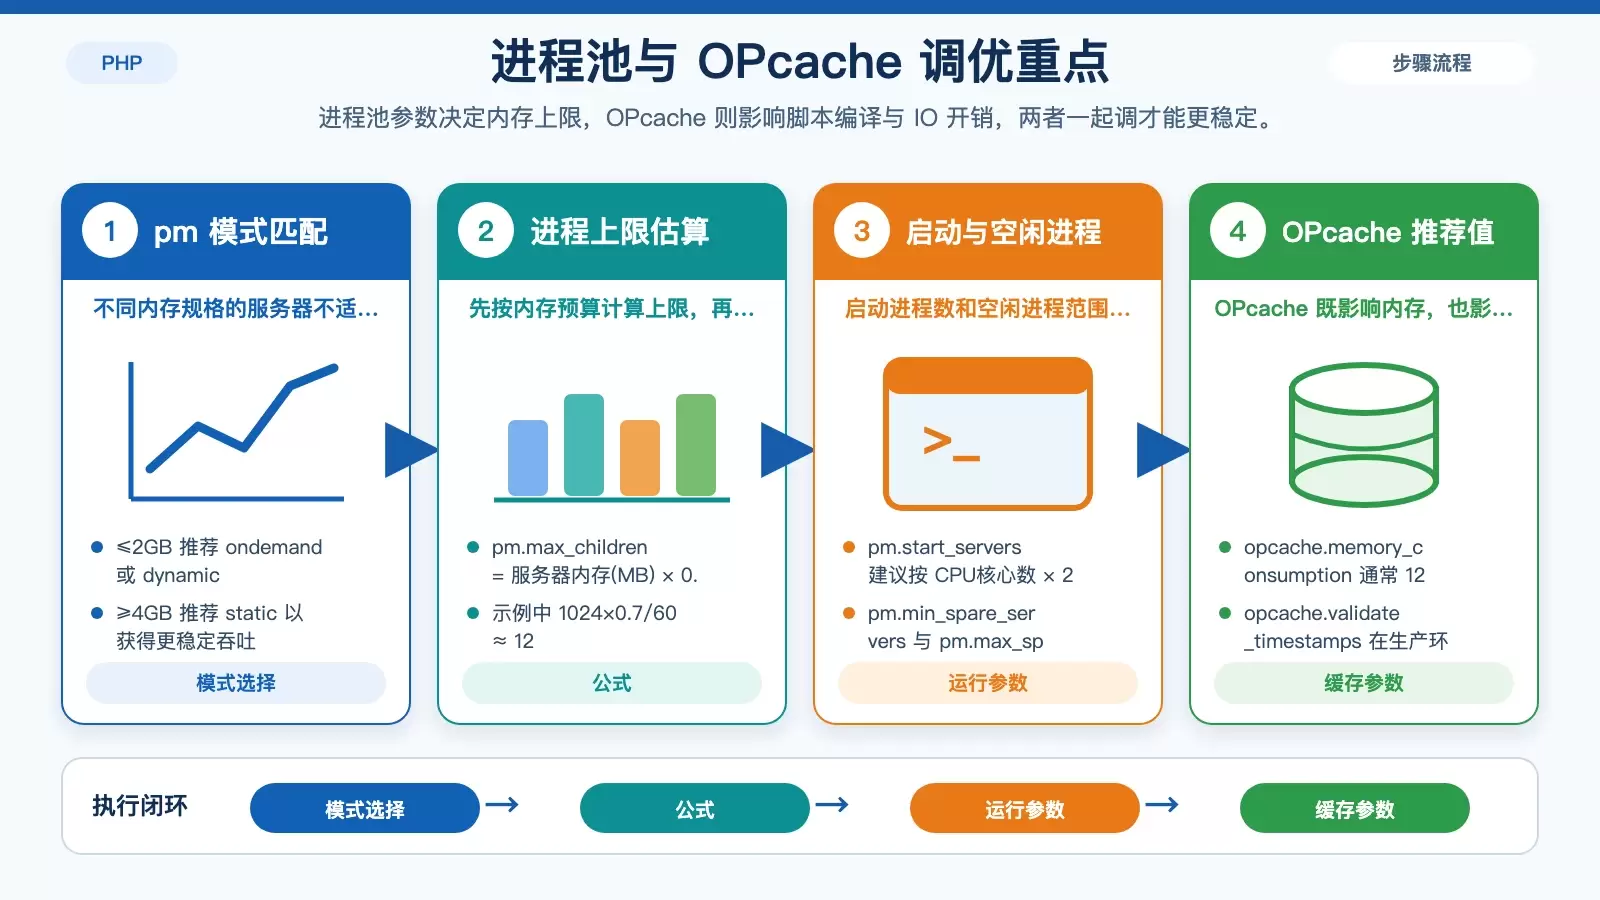
pm 参数决定 PHP-FPM 用什么方式管理工作进程,不同内存规格的服务器,选择应当不同。
- 小内存服务器(≤2GB):优先考虑
ondemand或dynamic。 - 大内存服务器(≥4GB):更适合
static,吞吐会更稳定。
原因很简单:小内存机器如果使用 static,在低流量时也会保留一批空闲进程,白白占内存;而大内存机器用固定进程数,能减少频繁创建和销毁进程带来的开销。
几个关键参数怎么估算
pm.max_children 是最重要的上限值,可以按下面的公式估算:
服务器内存(MB) × 0.7 / 单个进程平均内存(MB)比如 1GB 服务器、单进程平均 60MB:
1024 × 0.7 / 60 ≈ 12这时把 pm.max_children 设为 12,通常比盲目拉高更稳妥,因为还要给系统、Nginx、数据库预留空间。
其他几个常用参数可以按经验值起步:
pm.start_servers:建议设为CPU核心数 × 2,例如 4 核设为8。pm.min_spare_servers和pm.max_spare_servers:建议设为CPU核心数 × 1到CPU核心数 × 2,例如 4 核可设4~8。pm.max_requests:建议从500~1000开始。
其中 pm.max_requests 很值得重视。它表示单个进程处理一定数量请求后自动重启,这对缓解内存泄漏尤其有效,属于线上环境里很常见的一道保险。
别忽略 OPcache,这一项通常能立刻见效
如果 OPcache 没开,PHP 每次请求都需要重新编译脚本,既浪费 CPU,也增加内存与 IO 压力。对线上环境来说,这通常是必须启用的能力。
先确认在 php.ini 中已经开启:
/etc/php/{version}/fpm/php.iniopcache.enable=1几个常见参数的参考值
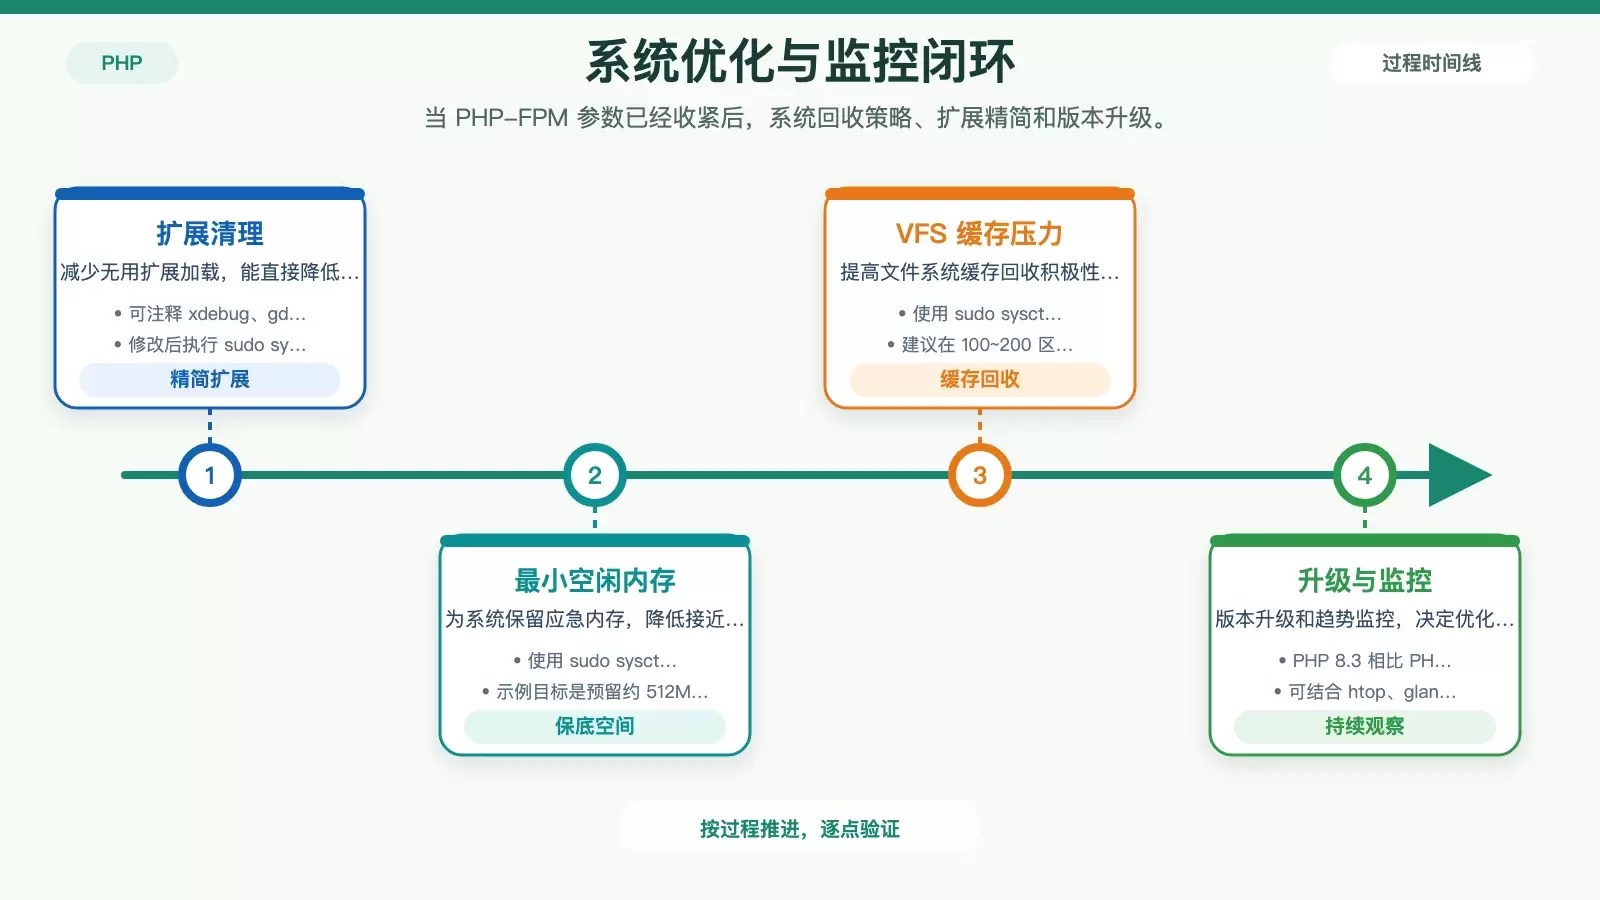
opcache.memory_consumption:一般可设为128M,大内存服务器可以提高到256M。opcache.interned_strings_buffer:可设为32M。opcache.max_accelerated_files:项目文件较多时可设为10000或更高。opcache.validate_timestamps:生产环境建议设为0。
opcache.validate_timestamps=0 的意义在于,PHP 不再频繁检查文件是否被修改,能明显减少磁盘 IO。不过这也意味着代码更新后需要自行 reload 或重启相关服务,适合部署流程规范的生产环境。
清理没用到的 PHP 扩展
默认安装的 PHP 环境,往往会顺手加载不少扩展。单看每一个占用不大,但累积起来,尤其是在多进程模型下,内存成本并不低。
可以在 php.ini 中把不需要的扩展注释掉。常见例子是开发环境调试用的 xdebug,以及业务根本不涉及图片处理时的 gd:
;zend_extension=xdebug.so
;extension=gd.so
改完后记得重启 PHP-FPM,使配置生效:
sudo systemctl restart php{version}-fpm系统层面的内存回收参数也能帮忙
当服务器本身内存紧张时,只调 PHP-FPM 还不够,内核的回收策略也会影响机器是否容易卡死、是否能及时腾出缓存空间。
先看内存回收阈值
可以先查看内核当前的 zone 水位:
grep -E "low|high" /proc/zoneinfo记下 low 值后,按原文给出的方式计算:乘以 3,再乘以 4(每页是 4KB),可以估算系统开始主动回收内存的临界值。
两项常见 sysctl 调整
第一项是保留最小空闲内存:
sudo sysctl -w vm.min_free_kbytes=524200这里示例设为 512MB,作用是让系统在接近内存耗尽时,仍保留一部分应急空间,减少整机卡死的概率。
第二项是提高目录项和 inode 缓存的回收积极性:
sudo sysctl -w vm.vfs_cache_pressure=130默认值一般是 100。如果调到 130,内核会更积极地回收文件系统相关缓存。通常建议在 100~200 区间内观察,不要拉得过高,否则可能影响文件系统性能。
能升级的话,优先考虑升级到 PHP 8.x
如果当前还停留在较旧版本,升级 PHP 本身就是一项有效优化。新版本在执行效率和内存管理上的改善,往往比零碎调参更直接。
原文给出的判断是:同样的代码,在 PHP 8.3 上运行,可能比 PHP 7.4 节省约 20% 的内存,同时执行速度也更快。
以 PHP 8.3 为例,可使用:
sudo apt update && sudo apt install php8.3-fpm安装完成后重启服务:
sudo systemctl restart php8.3-fpm调完不是结束,还要继续监控
PHP-FPM 内存优化很少是一锤子买卖。参数改完之后,最好继续观察一段时间,确认峰值内存、慢请求数量和响应时间是否真的改善。
先用实时工具看趋势
htop:可按M键按内存排序。glances:安装命令为sudo apt install glances,启动后按m键查看内存。
这类工具适合快速判断调整后是否还存在 PHP-FPM 持续堆高的情况。
日志和长期监控要结合看
除了实时观察,还应定期检查:
/var/log/php-fpm/error.logwww-slow.log
错误日志里可能出现内存泄漏、进程异常退出等线索,慢日志则更适合定位具体脚本和业务逻辑瓶颈。
如果服务器数量较多,或者需要看长期趋势,可以继续搭建 Prometheus + Grafana,把内存使用、进程数和请求耗时做成图表。这样一旦某天内存占用开始异常爬升,通常能比故障发生更早发现问题。















