


Python子类怎么正确调用父类构造函数(super用法)

__init__ 构造函数时,父类的 __init__ 并不会自动执行。最规范且推荐的做法是在子类的 __init__ 中使用 super().__init__(参数...)。这种方式不仅解除了对具体父类名称的硬编码绑定,更关键的是它遵循方法解析顺序(Method Resolution Order, MRO),能够安全支持复杂的单继承与多重继承协作调用。
一、为什么需要显式调用父类构造函数
面向对象编程中,子类通常是在父类的基础上增加新的属性或方法。在 Python 的对象生命周期中,当通过 Child() 实例化一个对象时,解释器首先调用 __new__ 分配内存,随后调用 __init__ 初始化状态。
如果子类没有定义自己的 __init__ 方法,Python 会自动沿继承链向上查找并执行父类的 __init__。但是,一旦子类重写(Override)了 __init__,它就会完全遮蔽父类的同名方法。此时,如果不主动调用父类构造函数,父类所负责的属性初始化逻辑将被直接跳过,导致子类实例缺失关键属性并引发 AttributeError。
二、单继承场景下的标准实现步骤
在标准的单继承结构中,调用父类构造函数可分为四个明确步骤:确定父类参数需求、声明子类继承关系、使用 super() 派发参数,以及最后完成子类自有属性的赋值。
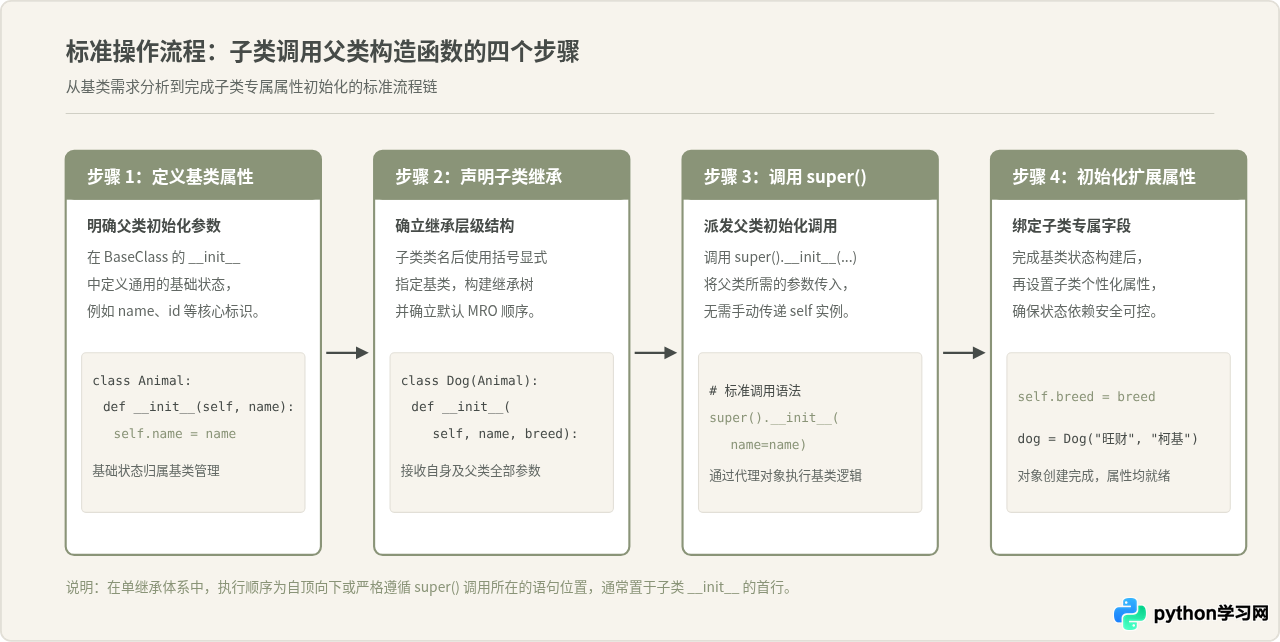
代码实现范例
以下是单继承环境下的规范代码示例。注意看子类的构造方法如何接收参数,并明确区分哪些参数交给父类、哪些留在子类:
class Vehicle:
    def __init__(self, brand, model):
        self.brand = brand
        self.model = model
        print(f"[Vehicle] 初始化完成: {self.brand} {self.model}")

class ElectricCar(Vehicle):
    def __init__(self, brand, model, battery_capacity):
        # 1. 调用父类构造函数,初始化 brand 和 model
        super().__init__(brand, model)
        # 2. 初始化子类专属属性
        self.battery_capacity = battery_capacity
        print(f"[ElectricCar] 初始化完成: 电池容量 {self.battery_capacity} kWh")

# 实例化验证
car = ElectricCar("Tesla", "Model 3", 75)
print(f"品牌: {car.brand}, 电池容量: {car.battery_capacity}")
运行该代码后的输出示例:
[Vehicle] 初始化完成: Tesla Model 3
[ElectricCar] 初始化完成: 电池容量 75 kWh
品牌: Tesla, 电池容量: 75
三、深入理解 super() 的工作原理与 MRO 机制
初学者常常将 super() 直观地理解为“指向直接父类的指针”,但这种理解是不准确的。在 Python 中,super() 实际上返回的是一个绑定在当前实例及其方法解析顺序(MRO)上的代理对象。
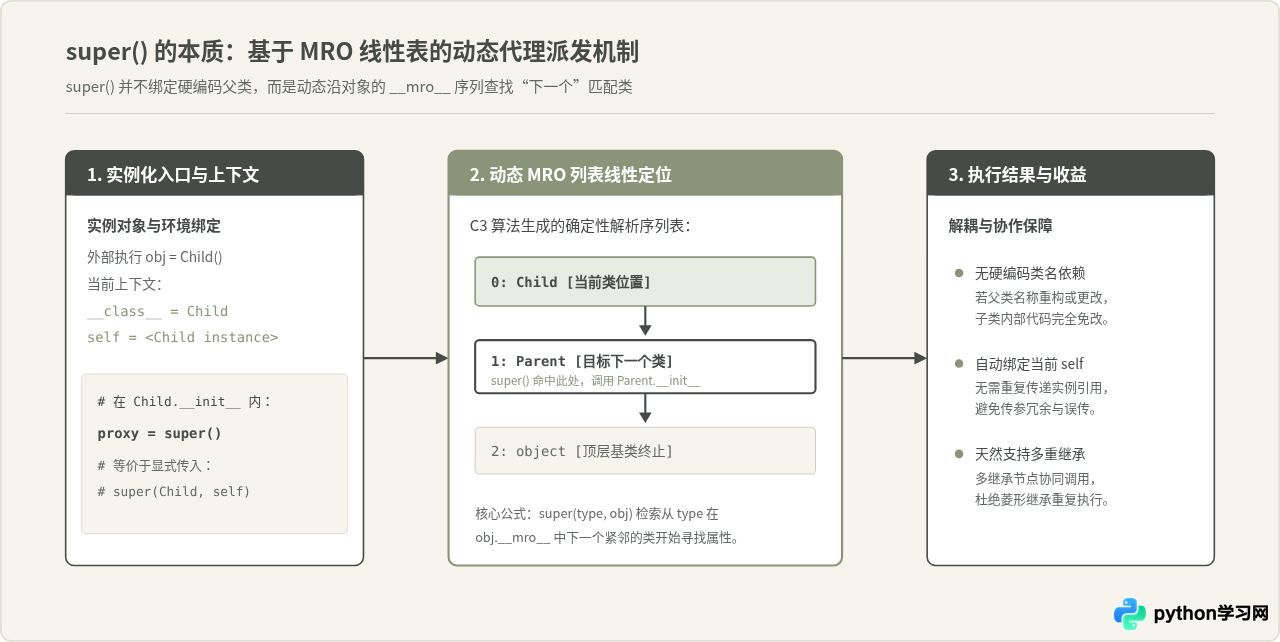
Python 3 与 Python 2 语法的演进
在 Python 2 中,调用 super 需要显式传入当前类名和实例变量:
# Python 2 风格(过时且冗长)
super(ChildClass, self).__init__(arg1, arg2)
而在 Python 3 中,解释器引入了零参数形式:
# Python 3 现代标准写法(推荐)
super().__init__(arg1, arg2)
在 Python 3 中,当在方法内部无参数调用 super() 时,编译器会在作用域内自动注入隐含的 __class__ 闭包单元,并将当前函数的第一个参数(即 self)自动绑定到 super 代理上。因此,手写 super(Class, self) 不仅容易在类名变更时产生拼写不一致,而且毫无额外收益。
四、容易混淆的写法:super() vs 显式调用 Parent.__init__(self)
不少开发者在刚开始学习面向对象时,会接触到类似 Parent.__init__(self, ...) 的写法。这种写法为什么看似合理?在什么情况下成立?又存在什么隐患?
1. 为什么这种写法看起来能用?
在最简单的单继承模式下,Parent.__init__(self, arg) 作为普通的未绑定方法调用,将子类的 self 作为第一个参数传入,在功能上确实能够顺利完成父类属性的初始化。它的逻辑直观、易懂,因此经常出现在一些初级教程中。
2. 致命缺陷:多重继承(菱形继承)下的灾难
一旦继承体系中出现了“菱形继承”(Diamond Inheritance,即类 D 同时继承自 B 和 C,而 B 和 C 共同继承自 A),显式调用父类构造函数的缺点就会暴露无遗。
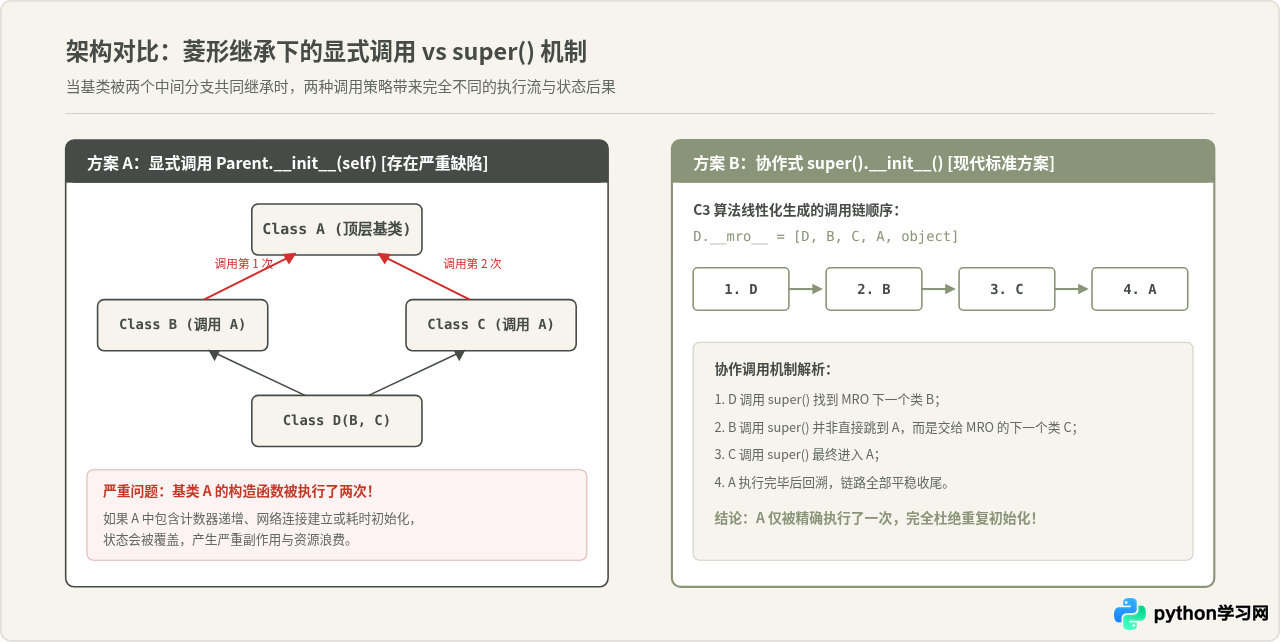
代码对比实验:菱形继承
我们通过具体的代码来验证菱形继承中两种写法的真实行为差异:
# 错误示例:显式指定父类调用
class A:
    def __init__(self):
        print("初始化 A")

class B(A):
    def __init__(self):
        A.__init__(self)
        print("初始化 B")

class C(A):
    def __init__(self):
        A.__init__(self)
        print("初始化 C")

class D(B, C):
    def __init__(self):
        B.__init__(self)
        C.__init__(self)
        print("初始化 D")

d = D()
输出示例显示 A 被执行了两次:
初始化 A
初始化 B
初始化 A
初始化 C
初始化 D
改用 super().__init__():
# 正确示例:协作式 super() 调用
class A:
    def __init__(self):
        print("初始化 A")

class B(A):
    def __init__(self):
        super().__init__()
        print("初始化 B")

class C(A):
    def __init__(self):
        super().__init__()
        print("初始化 C")

class D(B, C):
    def __init__(self):
        super().__init__()
        print("初始化 D")

d = D()
改写后的输出示例中,A 仅被执行一次:
初始化 A
初始化 C
初始化 B
初始化 D
五、多重继承下的参数传递最佳实践
在单继承中,参数关系通常是一对一的;但在多重继承的协作链条中,每个类需要的初始化参数可能各不相同。如果在协作链中随意使用固定位置参数,会导致中间某个类收到不属于它的参数而抛出 TypeError。
在多重继承体系中,正确传递参数的核心原则是:统一使用关键字参数(Keyword Arguments),并通过 **kwargs 向后透传未消费的参数。
class Root:
    def __init__(self, **kwargs):
        # 作为协作链的终点,忽略或校验剩余未处理的参数
        pass

class ComponentA(Root):
    def __init__(self, tag, **kwargs):
        super().__init__(**kwargs)
        self.tag = tag
        print(f"ComponentA 绑定标签: {self.tag}")

class ComponentB(Root):
    def __init__(self, score, **kwargs):
        super().__init__(**kwargs)
        self.score = score
        print(f"ComponentB 绑定分值: {self.score}")

class Combined(ComponentA, ComponentB):
    def __init__(self, custom_title, **kwargs):
        super().__init__(**kwargs)
        self.custom_title = custom_title
        print(f"Combined 初始化完成: {self.custom_title}")

# 实例化:所有参数均以关键字方式提供
item = Combined(custom_title="综合测试", tag="Alpha", score=98)
六、常见错误排查与避坑指南
在实际编写 Python 代码时,有几个非常普遍的误区需要格外注意:
| 常见错误表现 | 根本原因 | 正确纠正方法 |
|---|---|---|
TypeError: __init__() takes 2 positional arguments but 3 were given |
在 super().__init__(self, ...) 中多传了 self。super() 会自动绑定当前实例。 |
移除多余的 self,直接写 super().__init__(arg)。 |
子类无法访问父类属性(AttributeError) |
子类重写了 __init__ 但彻底遗漏了 super().__init__() 调用。 |
在子类 __init__ 中补上 super().__init__(...)。 |
TypeError: super() takes at least 1 argument (0 given) |
在遗留的 Python 2 环境或不兼容的作用域中尝试了无参形式。 | 确认当前运行环境为 Python 3,或显式补齐 super(Class, self)。 |
| 多继承下部分基类属性未初始化 | 多重继承链中间的某一个类断开了 super() 调用,导致后续链路无法执行。 |
确保链路上的每一个协作基类都完整调用了 super().__init__(**kwargs)。 |
七、总结与决策速查
为帮助在日常编码与代码重构中迅速作出正确判断,下方的决策图汇总了子类构造函数编写的判断树与核心规则:
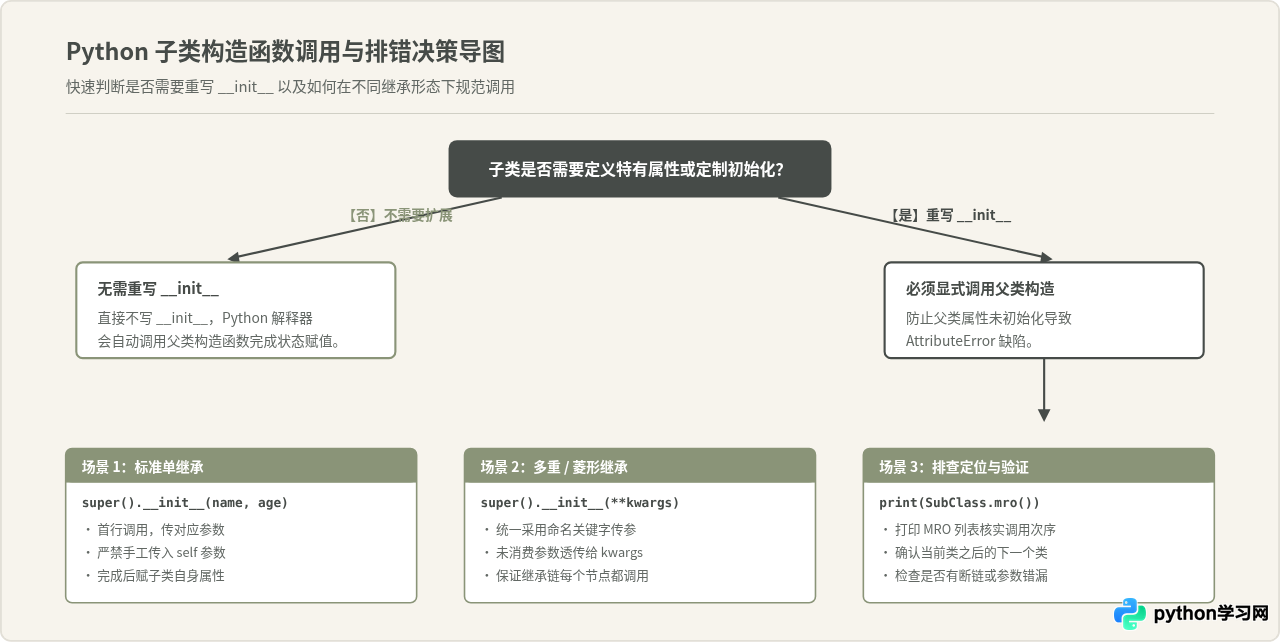
- 优先使用无参
super(): 在 Python 3 环境下始终使用super().__init__(...),避免手写super(Class, self)或Parent.__init__(self)。 - 千万不要手传
self:super()返回的代理对象已经绑定了当前实例,传入self会导致实参数量多出一个。 - 按序分工赋值: 父类管通用字段,子类管扩展字段,遵循先父后子的执行顺序。
- 遇到复杂继承查 MRO: 当多继承逻辑令人困惑时,直接使用
Class.mro()输出当前类的解析顺序,代码流向一目了然。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















