


Python中怎么用upper()实现不区分大小写的字符串比较
详细讲解在Python中使用upper()实现不区分大小写字符串比较的具体方法、底层原理、输入防御处理以及与casefold的差异。
在 Python 中实现不区分大小写的字符串比较,最直接的方式是在比较前调用两端字符串对象的 .upper() 方法,将其统一转换为大写副本后再使用相等运算符 == 进行比对。代码形式为 str1.upper() == str2.upper()。这种方式将两侧字符串的字母映射到相同的编码空间,从而消除大小写输入差异对结果判定的干扰。
一、核心语法与基础比较范式
Python 默认的相等运算符 == 严格比对字符的 Unicode 码点数值。例如大写字母 'A' 的编码值为 65,而小写字母 'a' 的编码值为 97,两者直接比较必定返回 False。通过 upper() 方法,可以将英文字符串中的所有小写字母转为对应的大写形式。
以下是使用 upper() 完成双端比较的标准代码模式:
# 定义两个大小写不同的待比较变量
input_role = "Admin"
target_role = "ADMIN"

# 正确做法:两端同时调用 .upper() 进行规范化
is_matched = input_role.upper() == target_role.upper()

print("比较结果示例:", is_matched)  # 示例输出:True
需要特别注意,比较表达式的两侧必须都显式调用 .upper()。如果只对其中一侧调用,一旦另一侧的基准值发生变动(例如目标变量被写成混合大小写 "Admin"),未转换的一侧就会因为含有小写字母导致比较失效。
二、内存机制与字符串不可变性
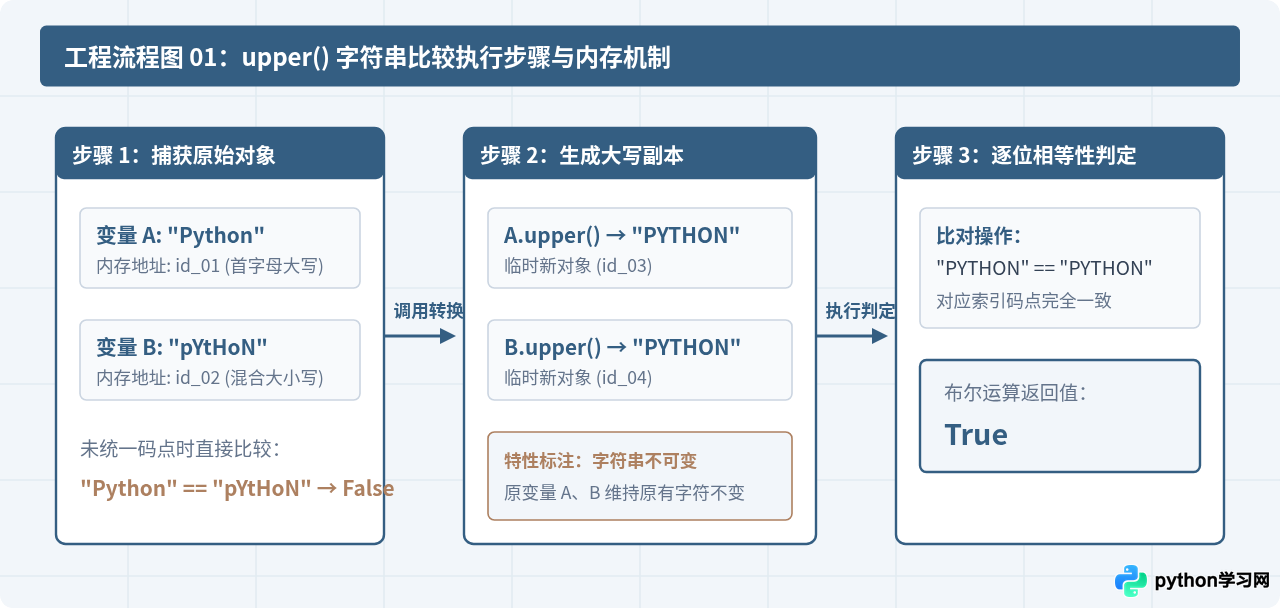
理解 upper() 的运作机制有助于避免编写冗余或错误的逻辑。在 Python 中,字符串是不可变对象(Immutable)。
当执行 s = "test" 并调用 s.upper() 时,Python 解释器并不会直接更改 s 在内存中的原始数据,而是在堆内存中开辟一块新的存储空间,放入转为大写后的新字符串 "TEST",并将其作为返回值输出。因此:
- 原变量保持原样:
s依然指向"test",其原本的内容和大小写状态未被破坏。 - 比较表达式中直接连写:写为
s1.upper() == s2.upper()即可,无需在外部额外声明两个新变量来存放转换结果。 - 无用副本自动回收:比对表达式计算完毕后,如果没有其他变量引用产生的临时大写字符串,Python 的垃圾回收器(GC)会自动释放这两个临时对象占用的内存。
三、实际开发中的清洗与防御性处理
在控制台输入、Web 表单或配置文件读取等现实业务场景中,待比较的字符串往往不仅包含大小写差异,还常伴随首尾多余空格,甚至可能是空值(None)或非字符串类型。若直接无条件调用 .upper(),代码极易发生异常。
1. 结合 strip() 过滤空格
用户在输入 "yes " 或 " YES" 时,尾部或头部的空白字符会导致 upper() 后的字符串长度不一致,比对依然失败。常规做法是通过链式调用将 strip() 与 upper() 配合使用:
user_cmd = "  confirm  "

# 链式处理:先去除首尾空白,再统一转换为大写
if user_cmd.strip().upper() == "CONFIRM":
    print("命令识别成功:操作已确认")
else:
    print("命令不匹配")
2. 非字符串与 None 值的防御判断
若变量来源不可靠(例如字典中未取到的键,返回值为 None),直接调用 None.upper() 会抛出 AttributeError: 'NoneType' object has no attribute 'upper'。为此应当加入类型前置检查:
def is_target_role(role_name, target="OPERATOR"):
    # 确保传入对象为字符串类型,避免 NoneType 异常
    if not isinstance(role_name, str):
        return False
    return role_name.strip().upper() == target.upper()

# 测试用例验证
print("正确字符串:", is_target_role(" operator "))  # 示例输出: True
print("None 值安全返回:", is_target_role(None))          # 示例输出: False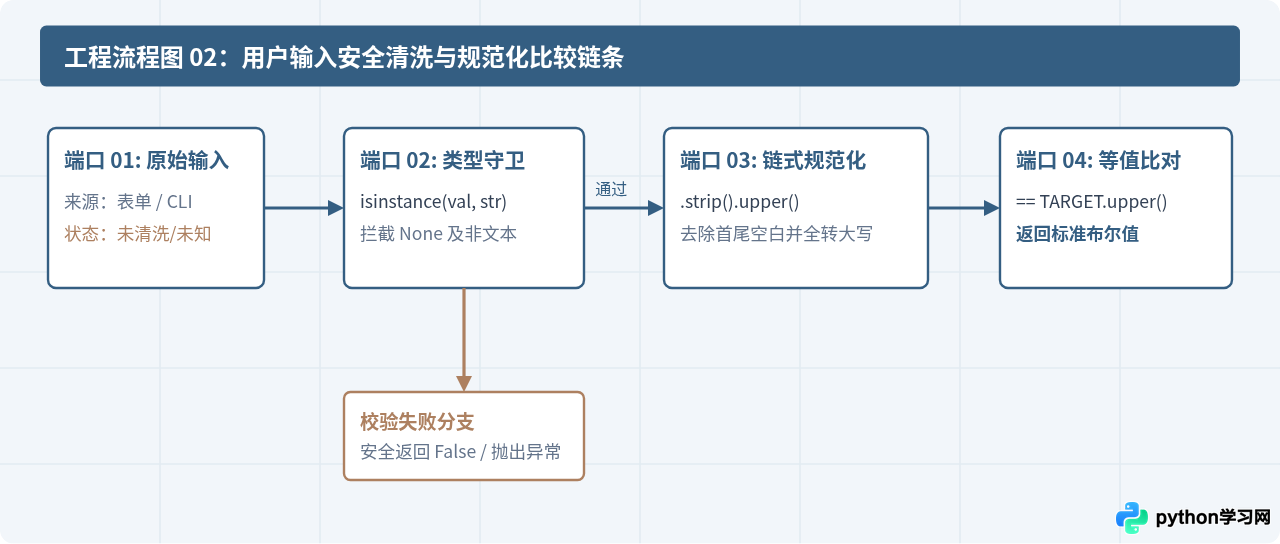
四、upper()、lower() 与 casefold() 的选型对比
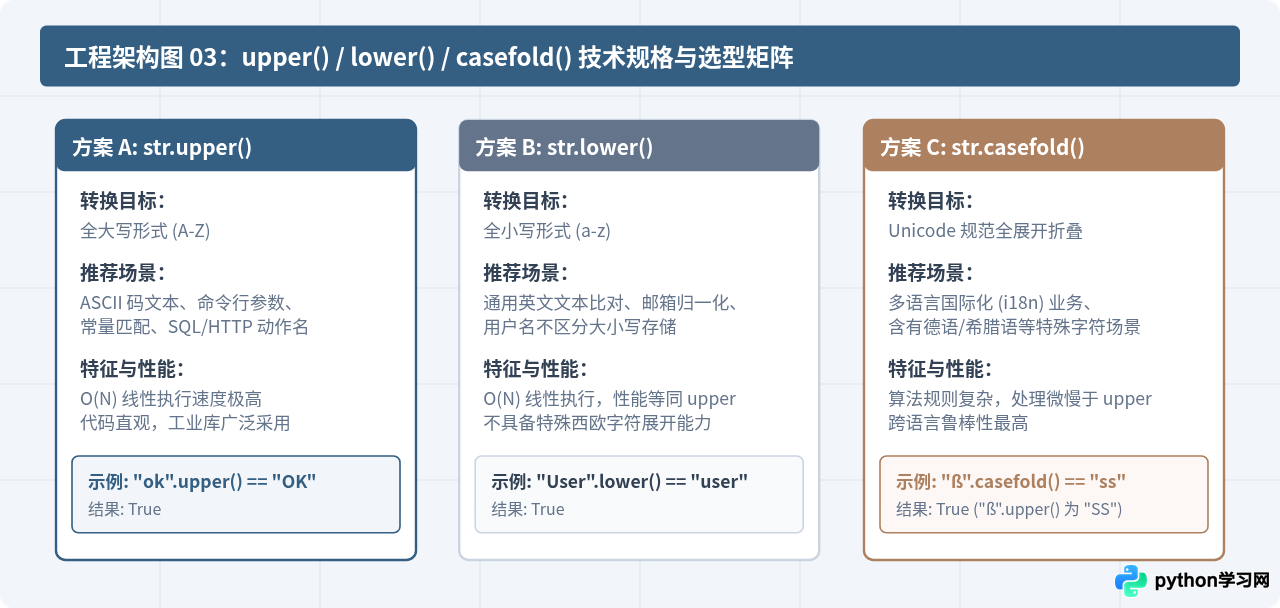
在处理不区分大小写的需求时,Python 提供了多个转换工具。很多读者容易混淆 upper()、lower() 和 casefold() 的使用边界:
- upper() 与 lower():在 ASCII 字符集(标准英文字母 A-Z 与 a-z)范围内,两者在功能与效率上完全等价。选择
upper()还是lower()通常取决于编码团队的约定。在涉及 SQL 命令、常量配置或网络协议关键字匹配时,许多工程团队偏好使用upper(),因为这与常量命名大写的习惯保持统一。 - casefold():Python 3.3 引入了专为“无大小写匹配”(Caseless Matching)设计的
casefold()方法。它不仅执行小写转换,还会对德语等特殊语言中的特殊字符进行激进展开。例如德语字母"ß"(Eszett)在经过upper()转换后变成"SS",但其调用lower()依然是"ß";而"ß".casefold()会直接转化为"ss"。
五、大规模数据与集合查询中的性能优化
在循环、列表过滤或大数据量查找场景中,如果在每一次比较时都重复调用 upper(),会产生大量不必要的字符串对象和重复计算。
1. 避免在循环内部重复转换基准项
# 低效做法:在每次循环中都对固定基准值调用 upper()
valid_tokens = ["token_a", "Token_B", "TOKEN_C"]
query = "TOKEN_B"

# 高效做法:在循环外部提前将固定目标转为大写
target_upper = query.upper()
matched = [item for item in valid_tokens if item.upper() == target_upper]
print("匹配结果示例:", matched)  # 示例输出: ['Token_B']
2. 使用集合(set)实现 O(1) 复杂度的查找
如果需要在大量候选字符串中进行不区分大小写的成员判断,最佳做法是在初始化时将所有元素提前转为大写并存入 set,查询时只需对输入执行一次 upper():
# 预先构建大写集合索引
RAW_STATUS_LIST = ["Active", "Pending", "Suspended", "Archived"]
UPPER_STATUS_SET = {s.upper() for s in RAW_STATUS_LIST}

def is_valid_status(status_str):
    if not isinstance(status_str, str):
        return False
    # 集合查询时间复杂度为 O(1)
    return status_str.strip().upper() in UPPER_STATUS_SET

print("有效状态验证:", is_valid_status("active"))     # 示例输出: True
print("无效状态验证:", is_valid_status("deleted"))    # 示例输出: False
六、总结与避坑清单
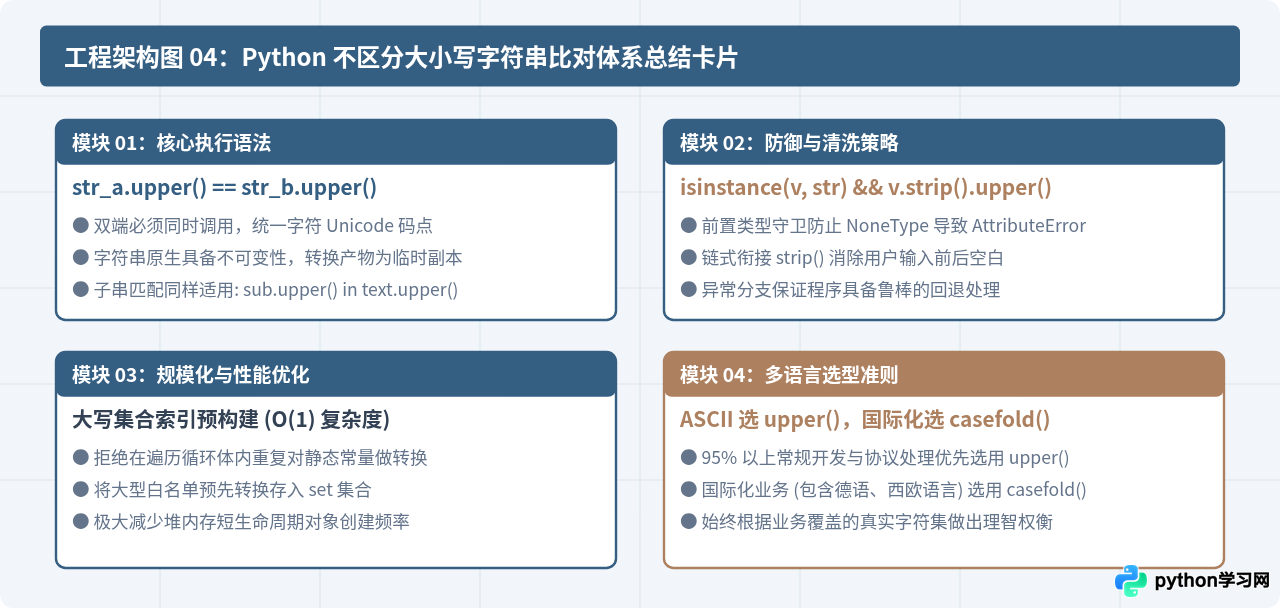
使用 upper() 实现不区分大小写比较是 Python 编程中的基础高频操作。掌握这一方法需要牢记以下四个核心原则:
- 双端转换原则:
==运算符两侧必须同时使用.upper(),不要假设任何一方已处于全大写状态。 - 不可变副本意识:
upper()不会改变原字符串对象,它始终返回新的字符串实例。 - 健壮性链式处理:面对不可信外部输入,配合
isinstance(val, str)守卫与.strip()消除空白符干扰。 - 大批量索引前置:高频查询时预先构建大写集合,避免在循环体内重复产生垃圾对象。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















