Python读取CSV时CParserError与NULL byte错误的编码排查
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
2026-10-15
0



本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
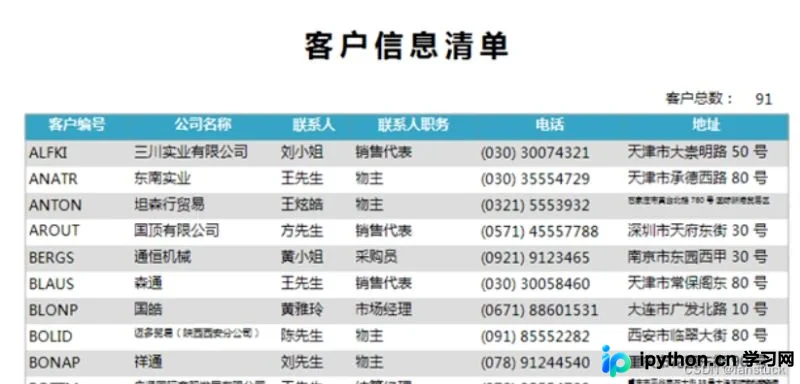
本文详细介绍如何利用Python实现报表自动化流程,涵盖从数据源读取、DataFrame计算、统计指标处理到图表生成的全过程。重点讲解使用Matplotlib和Echarts绘制可视化图表,并通过smtplib与email模块实现报表自动打包及发送至指定邮箱的功能,旨在提升数据分析效率并减少人工操作错误。
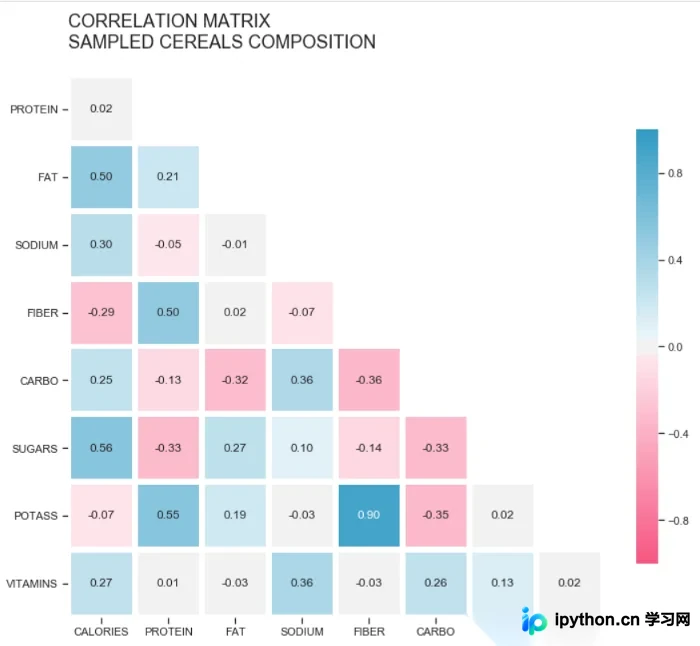
本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
本文介绍如何使用Python批量从TXT文件中提取特定文本并写入Excel。通过正则表达式匹配特定标识符(如栖息地描述),结合Pandas库扩展数据框列,实现非结构化数据的结构化处理。文中包含代码示例与参数说明,解决跨行匹配及编码问题,适用于数据清洗与批量处理场景。
本文详细介绍如何使用Python进行疫情数据爬取与可视化。通过requests获取腾讯接口数据,利用pandas清洗保存,最后使用pyecharts绘制死亡率、治愈率及各地区确诊分布图表,完整展示从数据获取到可视化展示的全流程。
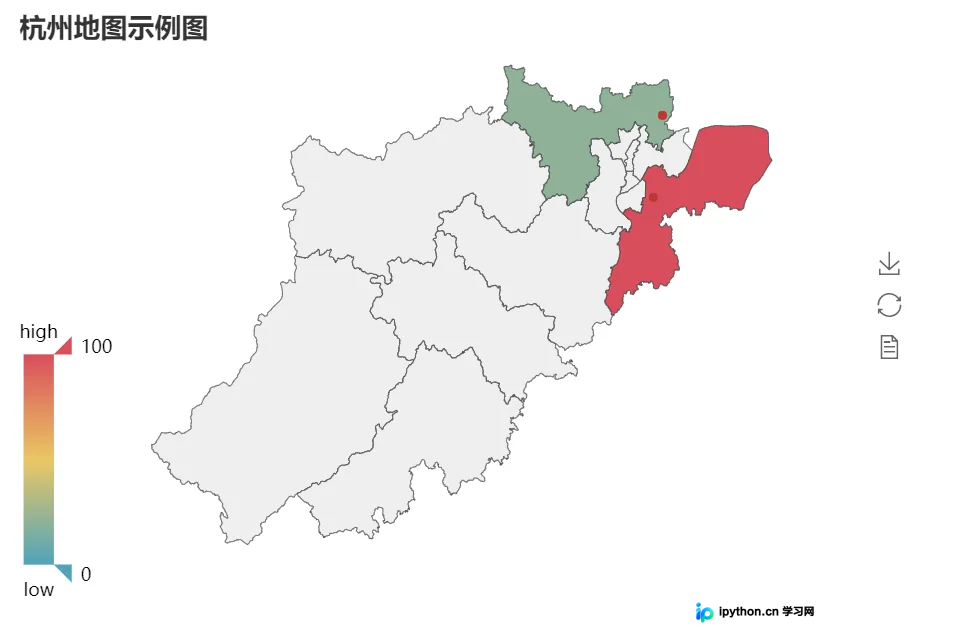
本文介绍如何利用pyecharts在Python中绘制中国及杭州地图,涵盖环境配置、包安装及核心API用法。重点解析因pandas处理导致数据变为numpy.int64从而引发图表不显示的常见错误,并提供转换为标准int类型的解决方案。
本文深入解析 Python lambda 匿名函数的定义、语法及工作原理。详细演示如何结合 filter、map 和 reduce 高阶函数处理数据,探讨其在 Pandas 中的应用。同时对比普通函数,总结 lambda 在代码简洁性与可读性方面的优缺点,并提供最佳实践建议。
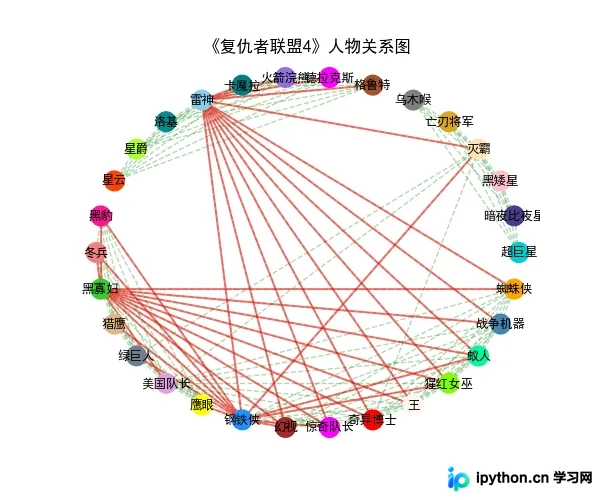
本文介绍如何利用Python的network模块构建《复仇者联盟4》人物关系图。通过pandas读取数据,使用Graph类添加节点与边,并展示两种布局算法:圆环布局与Fruchterman-Reingold力引导算法的效果对比,帮助读者掌握复杂网络可视化的基本方法。
PyScript 是 Anaconda 推出的开源项目,允许在 HTML 中嵌入 Python 代码并在浏览器端直接运行。基于 Pyodide 技术,它支持引入 numpy、pandas 等科学计算库,实现 Python 与 JavaScript 的双向通信。尽管目前加载速度较慢,但它为 Python 开发者提供了构建全栈应用的新可能,无需编写 JavaScript 即可实现前端交互。
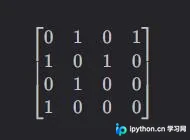
本文介绍如何使用Python将包含节点对的两列Excel或CSV文件转换为邻接矩阵,并进一步将其转化为COO(坐标)格式。文中提供了基于numpy和pandas的完整代码示例,详细解析了无权无向图的对称性处理、节点索引从0开始的规则,以及PyG中COO格式形状的计算逻辑,适用于复杂网络运算和图神经网络预处理。
本文深入解析多项贝叶斯(Multinomial Naive Bayes)模型的数学原理及其在Python环境中的实现。通过对比决策树模型的过拟合问题,展示了利用cuML库在GPU环境下构建多项贝叶斯模型的具体步骤。文章包含数据预处理、特征工程及ROC曲线评估,最终验证了该模型在特定气团变化预测任务中的高准确率表现。
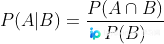
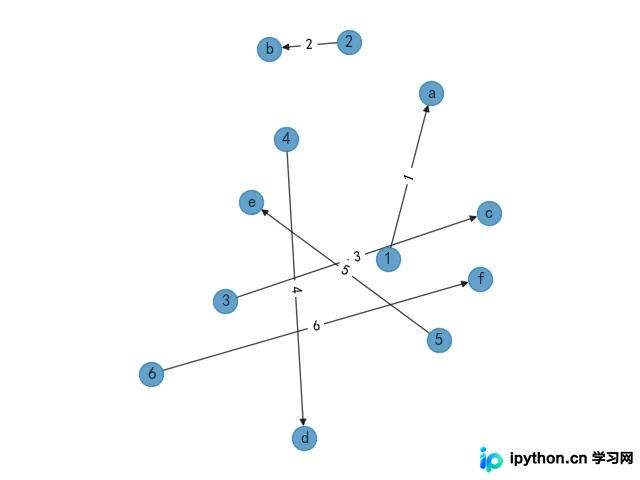
本文基于Python的NetworkX库,详细对比了四种关系图可视化布局的效果。通过模拟DataFrame数据,分别演示了随机分布、放射状、特征值向量及图形边缘化(壳层)模型。文章提供了完整的代码实现与参数设置,帮助开发者根据数据特性选择最合适的可视化方案,以清晰展示节点间的关联关系。