


Python多项贝叶斯模型实现原理与GPU环境下的应用实践

本文深入解析多项贝叶斯(Multinomial Naive Bayes)模型的数学原理及其在Python环境中的实现。通过对比决策树模型的过拟合问题,展示了利用cuML库在GPU环境下构建多项贝叶斯模型的具体步骤。文章包含数据预处理、特征工程及ROC曲线评估,最终验证了该模型在特定气团变化预测任务中的高准确率表现。
多项贝叶斯模型背景与基础原理
此前在与某客户交流期间,基于实际需求我开始研究多项贝叶斯(Multinomial Naive Bayes)这一机器学习模型。
在深入探讨多项贝叶斯之前,有必要先回顾基础概念:朴素贝叶斯(Naive Bayes)模型。
贝叶斯定理描述的是在抽象事件B发生的前提下,抽象事件A发生的概率,记作条件概率。
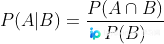
其中`P(B)`表示事件B单独发生的概率。贝叶斯定理计算的是事件A与事件B同时发生的联合概率与事件B单独发生概率的比值,这体现了事件发生的先后逻辑顺序。
若纯文字描述过于抽象,可参考以下示意图辅助理解:
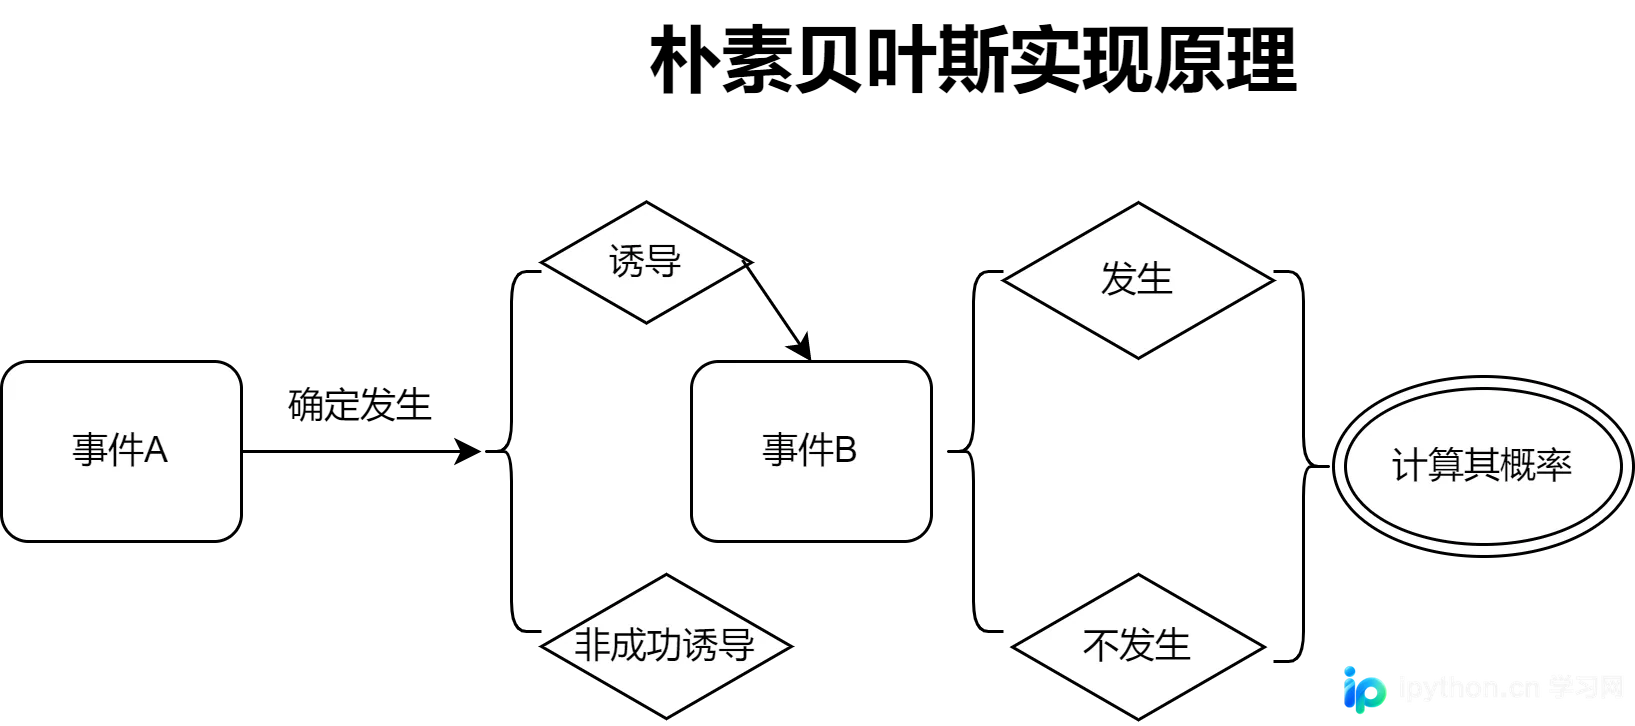
从流程图中可以看出:事件A是已确定的发生事件,在A发生后,它可能成功诱导事件B发生,也可能诱导失败。
我们仅讨论诱导成功的情况。尽管事件A成功诱导了事件B,但作为独立实体,事件B本身的发生概率仍是不确定的。因此,需要借助贝叶斯模型进行自动推理,以计算前置因素对后一事件发生的潜在诱导作用。
数据预处理与特征工程
接下来通过具体示例展示,首先查看数据框的现有列信息。
ModelData.columns
Index(['全局水平', '大气温度 [℃]', '风冷温度 [℃]', '露点温度 [℃]', '相对湿度 [%]', '平均十米内风速 [m/s]',
       '站点压力 [mBar]', '降水量 [mm]', '定点角度 [°]', '方位角度 [°]', '气团大小', '气团变化'],
      dtype='object')
在该模型数据集中,我们需要研究气团变化。这里使用cuDF内置的`.to_pandas()`函数将GPU数据框转换为Pandas数据框,并利用`.apply()`配合lambda匿名函数对气团大小的变化进行类别分类处理。
由于后续使用了DecisionTree决策树来训练第二个模型,因此数据被命名为df_train_Tree,但最终核心模型仍为多项贝叶斯模型。
# 使用.apply()函数来实现来为气团变化进行标签化处理
df_train_Tree['气团变化'] = df_train_Tree['气团大小'].to_pandas().apply(lambda x:0 if x == 0 else 1 if x < 0 else 2 if x > 0 else None)
对数据进行预处理后,使用cuML继承自sklearn的`train_test_split()`函数对数据进行分割。
# 进行绝对值翻转处理,以防止存在负值无法训练模型
ModelData = df_train_Tree.iloc[:,2:].to_pandas().apply(lambda x: x.abs())
ModelData = cf.DataFrame(ModelData)
# 构建训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(ModelData,ModelData['气团变化'], test_size=0.2, random_state=42)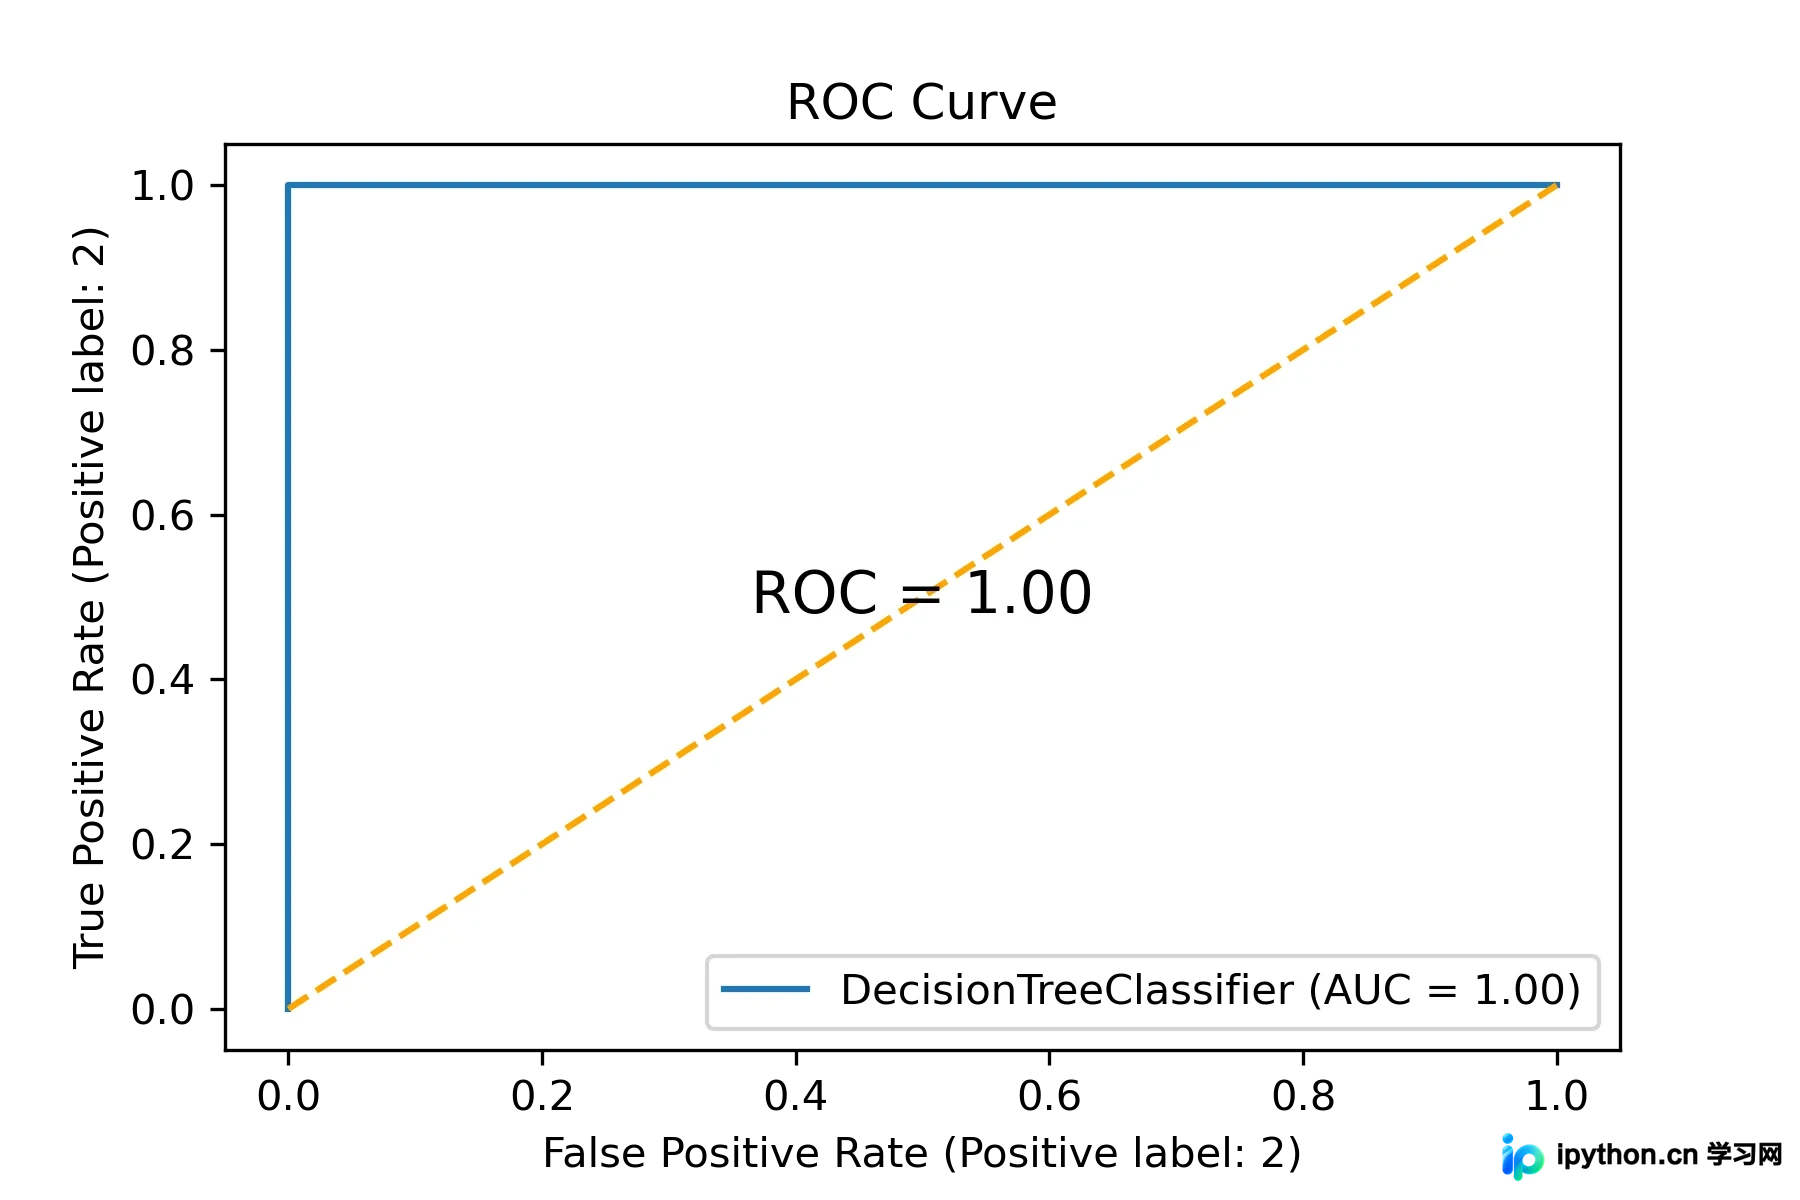
通过sklearn.metrics下的`plot_roc_curve()`函数绘制的ROC曲线和`roc_auc_score()`函数分析发现,此时的决策树模型存在严重过拟合。由于在树中未指定明确的二值化数据(即判断所需的基本真假条件),导致树在判断时将所有情况均视为真,从而造成严重过拟合。
通过之前的系列线性校验,我们得知:前置的所有属性均为`可能`诱导气团大小的`诱因`。
因此,在不确定性较高的情况下,我们将使用全部属性进行模型的初步测试。
GPU环境下的模型实现与评估
最终,我们需要使用多项贝叶斯模型来构建模型,以下是多项贝叶斯在GPU环境上的具体实现代码。
# 因为属性众多,因此我们需要引入多项分布朴素贝叶斯(Multinomial NB)
from sklearn.naive_bayes import MultinomialNB
clf = MultinomialNB()
# 将训练集进行训练
clf.fit(X_train.to_pandas(), y_train.to_numpy())
MultinomialNB()
# 绘制ROC曲线以验证预测结果
plot_roc_curve(clf, X_test.to_pandas(), y_test.to_numpy())
plt.title('ROC Curve')
plt.plot([0, 1], [0, 1], '--',color='orange')
plt.text(0.5, 0.5, 'ROC = %.2f' % roc_auc_score(y_test.to_pandas(),cp.asnumpy(y_pred)), ha='center', va='center', fontsize=14)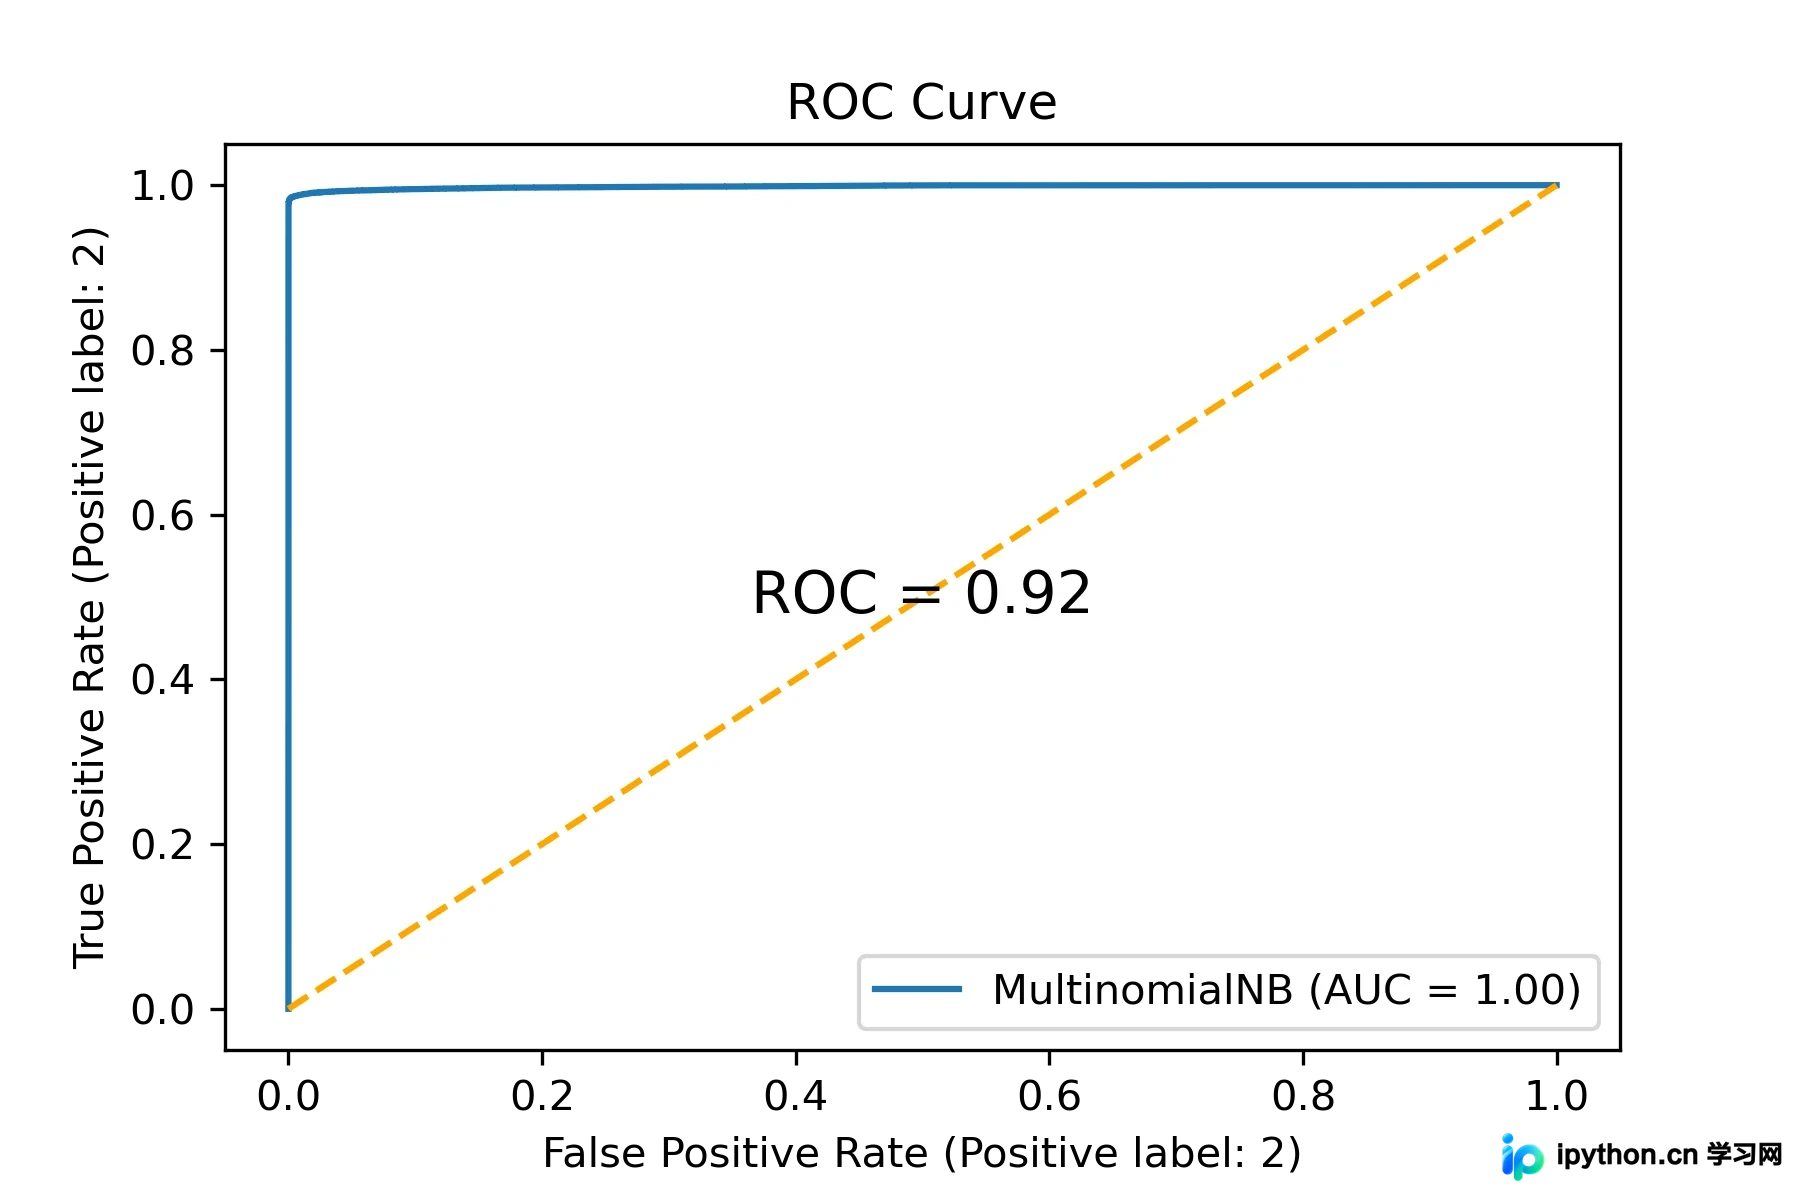
结果显示,在多项贝叶斯模型下,我们的表现非常优异,`roc_auc_score`分数达到0.92。这也进一步证明了之前训练的决策树模型确实存在显著过拟合问题。
模型对比与总结
总结:
当皮尔森系数较低但存在微弱线性相关性的分类问题时,我们可以尝试推测性方法:即贝叶斯类模型。在能够肯定前置因素可能会诱导后一事件的前提下,即可进行贝叶斯模型的尝试。
至此,关于Multinomial Naive Bayes多项贝叶斯模型实现原理的介绍已完成。更多相关Multinomial Naive Bayes内容请搜索本站以前的文章或继续浏览下面的相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















