


Python Seaborn绘制热力图实战:从数据预处理到高级可视化

本文详细介绍如何使用Python的Seaborn库绘制高质量热力图。内容涵盖从导入Pandas和Numpy进行数据预处理开始,通过corr()计算相关性矩阵,利用Mask矩阵去除冗余上三角区域,以及调整参数显示具体数值。此外,还深入讲解了如何使用diverging_palette优化发散型调色板,提升视觉表现力,最终生成带有标题和格式优化的专业级相关性热力图。
1. 引言
热力图的核心理念直观且简单,即利用颜色的深浅或色调变化来替代枯燥的数字展示。
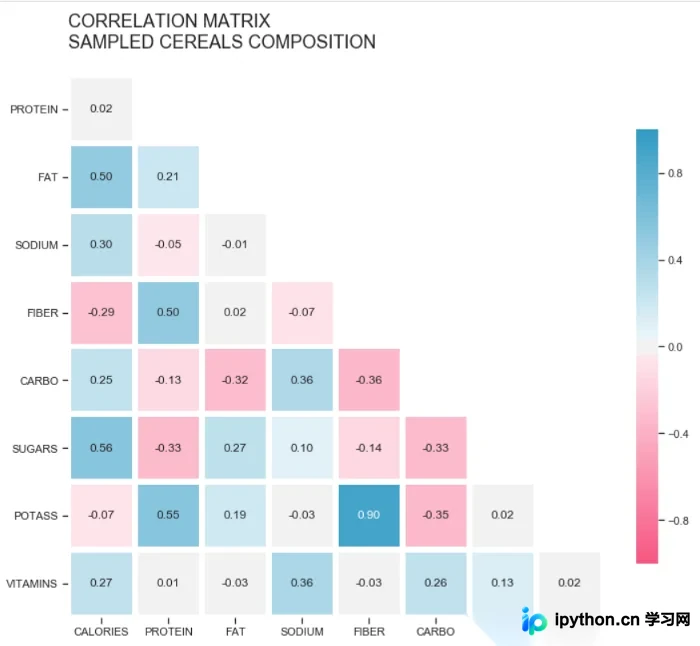
如今,这种可视化形式已超越了最初简单的颜色编码表格范畴,被广泛应用于地理空间数据的展示中。此类图表常用于描述变量的密度或强度分布、可视化数据模式、展示方差分布,甚至用于识别异常值。
鉴于热力图在数据分析中的广泛应用,本文将深入探讨如何利用Seaborn库来创建高效且美观的热力图。
2. 示例场景
首先,我们需要导入Pandas和Numpy这两个核心库,它们将为后续的数据预处理和数值计算提供坚实基础。
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sb
import numpy as np
为了进行具体演示,我们选用包含80种不同谷物样本的数据集,重点分析它们的营养成分构成。
该数据集的部分样例展示如下:
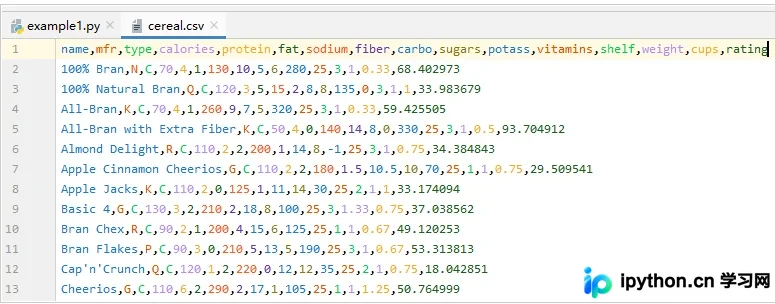
如上图中所示,第一行是表头信息。对于每一行数据,第一列标识谷物的名称,随后的第4列至第16列则记录了该谷物所含的13种主要成分的数值。
3. 数据预处理
接下来,我们将分析每种谷物中13种不同成分之间的相关性。为此,我们可以利用Pandas库提供的corr()函数来计算相关性矩阵。
具体实现代码如下:
# read dataset
df = pd.read_csv('data/cereal.csv')
# get correlations
df_corr = df.corr()  # 13X13
print(df_corr)
执行上述代码后,得到的结果如下:
calories protein fat ... weight cups rating calories 1.000000 0.019066 0.498610 ... 0.696091 0.087200 -0.689376 protein 0.019066 1.000000 0.208431 ... 0.216158 -0.244469 0.470618 fat 0.498610 0.208431 1.000000 ... 0.214625 -0.175892 -0.409284 sodium 0.300649 -0.054674 -0.005407 ... 0.308576 0.119665 -0.401295 fiber -0.293413 0.500330 0.016719 ... 0.247226 -0.513061 0.584160 carbo 0.250681 -0.130864 -0.318043 ... 0.135136 0.363932 0.052055 sugars 0.562340 -0.329142 0.270819 ... 0.450648 -0.032358 -0.759675 potass -0.066609 0.549407 0.193279 ... 0.416303 -0.495195 0.380165 vitamins 0.265356 0.007335 -0.031156 ... 0.320324 0.128405 -0.240544 shelf 0.097234 0.133865 0.263691 ... 0.190762 -0.335269 0.025159 weight 0.696091 0.216158 0.214625 ... 1.000000 -0.199583 -0.298124 cups 0.087200 -0.244469 -0.175892 ... -0.199583 1.000000 -0.203160 rating -0.689376 0.470618 -0.409284 ... -0.298124 -0.203160 1.000000
[13 rows x 13 columns]
随后,我们移除那些相关性较弱、对分析贡献不大的最后几个成分字段,相关代码如下:
# irrelevant fields
fields = ['rating', 'shelf', 'cups', 'weight']
# drop rows
df_corr.drop(fields, inplace=True) # 9X13
# drop cols
df_corr.drop(fields, axis=1, inplace=True) # 9X9
print(df_corr)
处理后的结果如下所示:
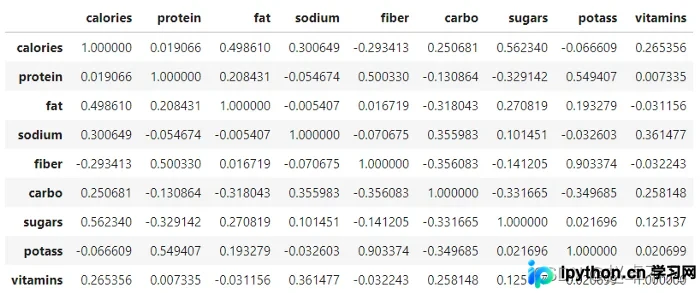
需要注意的是,相关性矩阵本质上是一个对称矩阵,其主对角线上方的三角区域与下方的值完全相同,这导致了大量的数据冗余。
4. 绘制热力图
幸运的是,我们可以利用Mask(遮罩)矩阵来生成Seaborn中的热力图,首先我们需要构建这个Mask矩阵。
np.ones_like(df_corr, dtype=np.bool)生成的Mask矩阵结果如下:
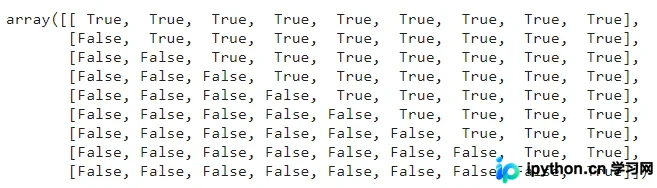
接下来,我们需要获取上三角矩阵部分。在Numpy库中,使用np.triu函数可以方便地返回对应于上三角矩阵的Mask。
具体表现如下:
mask = np.triu(np.ones_like(df_corr, dtype=np.bool))最终生成的Mask结果如下:
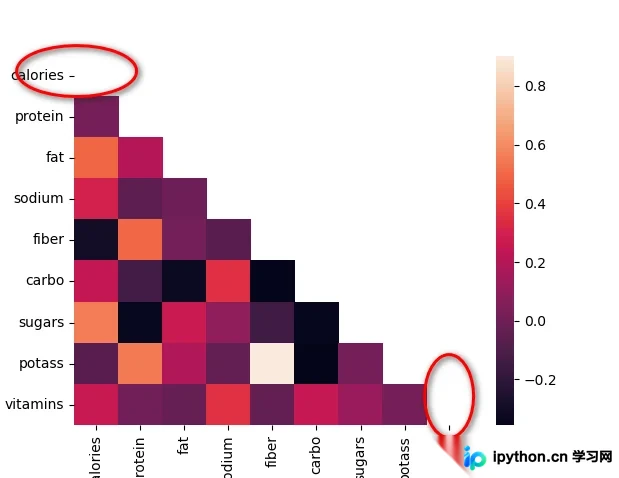
准备好Mask后,我们开始绘制热力图,实现代码如下:
sb.heatmap(df_corr,mask=mask)
plt.show()
此时的运行结果如下所示:
5. 添加数值标注
观察上述生成的图表,虽然我们已经使用Mask成功生成了热力图,但图像中仍存在两个空白单元格(如红色圆圈所示区域)。
我们可以在绘图过程中直接过滤掉这些空白部分,即分别对对应的mask矩阵和df_corr数据框进行切片处理。
相关过滤代码如下:
# adjust mask and df
mask = mask[1:, :-1]
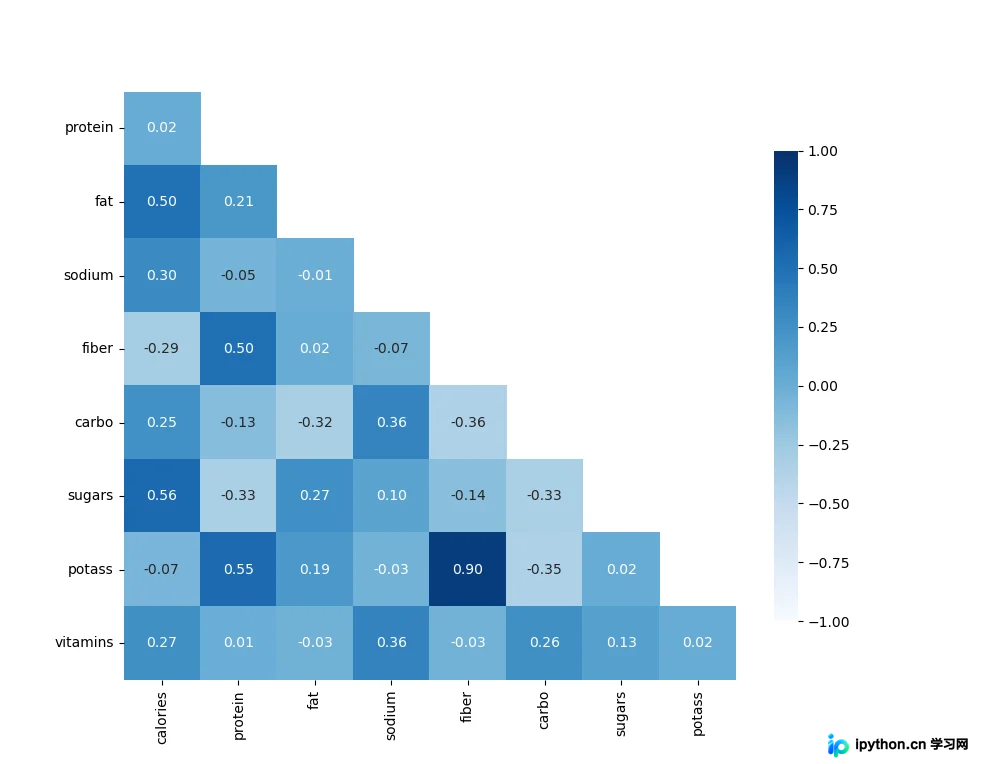
corr = df_corr.iloc[1:, :-1].copy()同时,我们可以配置heatmap函数的相应参数,以便在图表中直接显示具体的数值。
完整的实现代码如下:
def test2():
    # read dataset
    df = pd.read_csv('data/cereal.csv')
    # get correlations
    df_corr = df.corr()  # 13X13
    # irrelevant fields
    fields = ['rating', 'shelf', 'cups', 'weight']
    df_corr.drop(fields, inplace=True)  # 9X13
    # drop cols
    df_corr.drop(fields, axis=1, inplace=True)  # 9X9

    mask = np.triu(np.ones_like(df_corr, dtype=np.bool))

    # adjust mask and df
    mask = mask[1:, :-1]
    corr = df_corr.iloc[1:, :-1].copy()
    # plot heatmap
    sb.heatmap(corr, mask=mask, annot=True, fmt=".2f", cmap='Blues',
               vmin=-1, vmax=1, cbar_kws={"shrink": .8})
    # yticks
    plt.yticks(rotation=0)
    plt.show()
运行上述代码后的结果如下:
6. 调色板优化
为进一步优化可视化效果,考虑到相关系数的取值范围是-1到1,颜色变化具有双向性。因此,采用由中心向两侧发散的颜色方案,相比单一连续色阶,视觉效果更为出色。以下展示了一个发散型调色板的示例:
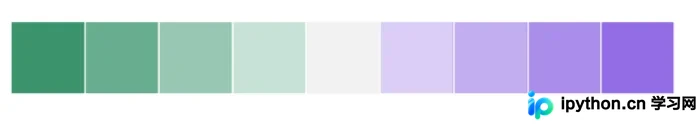
在Seaborn库中,存在一个用于生成发散型调色板的函数driverging_palette,,该函数专门用于构建colormaps,其特点是每侧使用一种颜色,并在中心汇聚成第三种颜色。
该函数的完整语法形式如下:
diverging_palette(h_neg, h_pos, s=75, l=50, sep=1,n=6, center=“light”, as_cmap=False)该函数采用的颜色表示形式为HUSL,即hue、Saturation和Lightness。建议查阅官方文档以选择适合后续设置的调色板颜色参数。
最后但同样至关重要的一点,务必在图像上设置标题,这可以通过title函数轻松实现。
包含标题设置的完整代码如下:
def test3():
    # read dataset
    df = pd.read_csv('data/cereal.csv')
    # get correlations
    df_corr = df.corr()  # 13X13
    # irrelevant fields
    fields = ['rating', 'shelf', 'cups', 'weight']
    df_corr.drop(fields, inplace=True)  # 9X13
    # drop cols
    df_corr.drop(fields, axis=1, inplace=True)  # 9X9

    fig, ax = plt.subplots(figsize=(12, 10))
    # mask
    mask = np.triu(np.ones_like(df_corr, dtype=np.bool))
    # adjust mask and df
    mask = mask[1:, :-1]
    corr = df_corr.iloc[1:, :-1].copy()
    # color map
    cmap = sb.diverging_palette(0, 230, 90, 60, as_cmap=True)
    # plot heatmap
    sb.heatmap(corr, mask=mask, annot=True, fmt=".2f",
               linewidths=5, cmap=cmap, vmin=-1, vmax=1,
               cbar_kws={"shrink": .8}, square=True)
    # ticks
    yticks = [i.upper() for i in corr.index]
    xticks = [i.upper() for i in corr.columns]
    plt.yticks(plt.yticks()[0], labels=yticks, rotation=0)
    plt.xticks(plt.xticks()[0], labels=xticks)
    # title
    title = 'CORRELATION MATRIX\nSAMPLED CEREALS COMPOSITION\n'
    plt.title(title, loc='left', fontsize=18)
    plt.show()
最终运行结果如下:
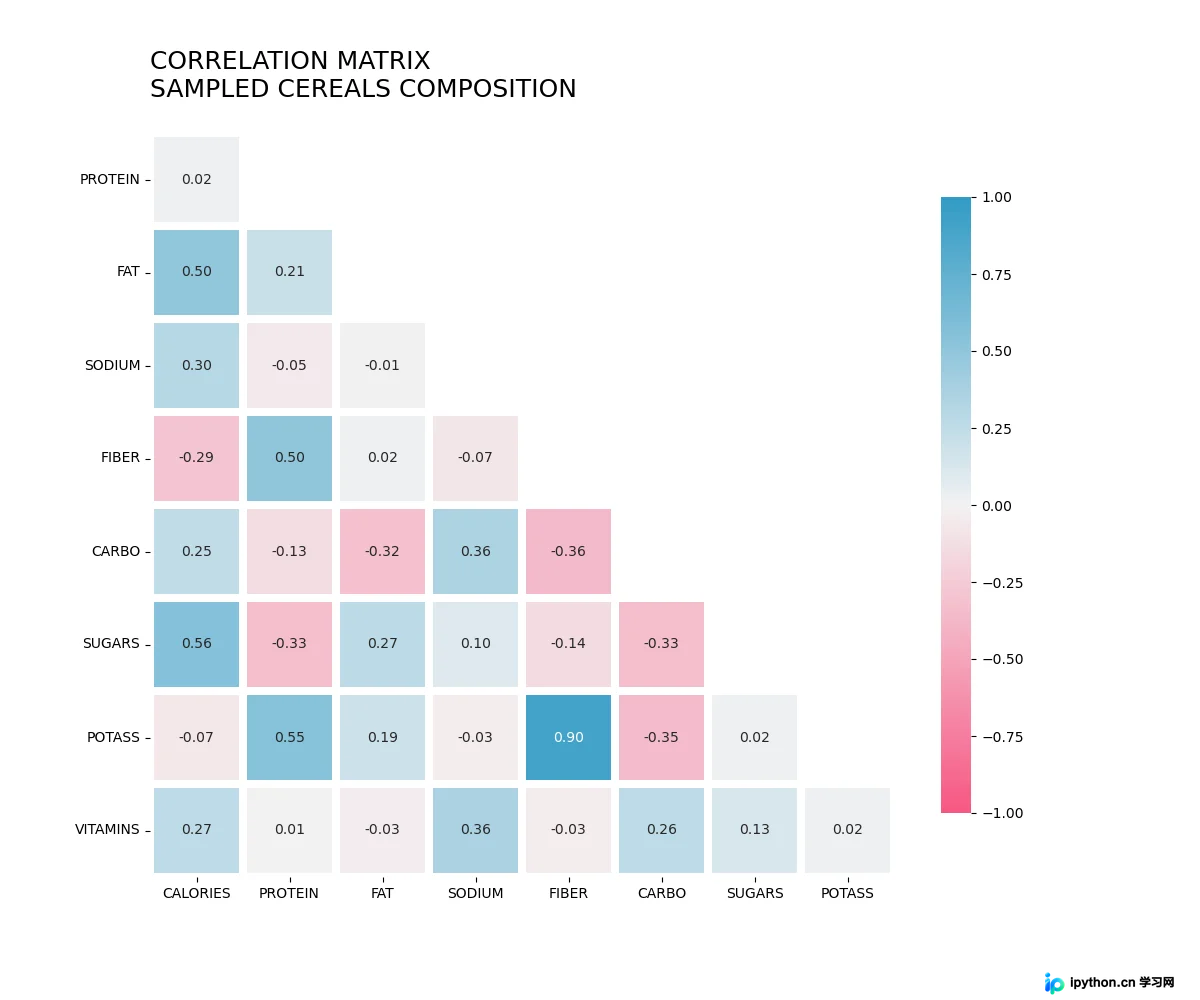
经过优化后的图表是否看起来更加专业和高大上?这充分说明了人类作为视觉动物的特性。
至此,关于数据可视化Seaborn绘制热力图的教程介绍完毕。如需了解更多关于Seaborn绘制热力图的内容,欢迎搜索本站历史文章或继续浏览后续相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















