Python CSV文件读写全指南:从内置csv库到Pandas实战
本文详细介绍Python中处理CSV文件的两种核心方式。首先解析内置csv库的reader与DictReader用法,涵盖delimiter、quotechar等关键参数及处理含逗号字段的技巧;随后深入Pandas库,演示如何快速读取、格式化日期及写入CSV文件,提供从基础到进阶的完整代码示例。
2026-10-16
0



本文详细介绍Python中处理CSV文件的两种核心方式。首先解析内置csv库的reader与DictReader用法,涵盖delimiter、quotechar等关键参数及处理含逗号字段的技巧;随后深入Pandas库,演示如何快速读取、格式化日期及写入CSV文件,提供从基础到进阶的完整代码示例。
本文详细介绍Python pandas中处理缺失值的三种核心方法:删除含缺失值的样本或特征列,以及使用具体数值或前后值进行填充。通过dropna、drop和fillna函数的参数详解与代码示例,帮助开发者快速掌握数据清洗技巧。
本文总结了使用Pandas处理Excel文件时常见的Sheet相关问题,包括如何一次性写入多个Sheet、向已存在文件追加Sheet,以及覆盖特定Sheet而不影响其他Sheet的正确操作方法。通过示例代码展示了ExcelWriter类的使用及openpyxl引擎的配置,解决了自动重命名和顺序错乱等问题。
在使用Pandas读取MySQL数据并进行处理后,若DataFrame中存在无穷大(inf)值,直接写入数据库会触发ProgrammingError。本文详细解析了inf产生的原因(如除以零),并提供了利用numpy和Pandas将正负无穷替换为空值或具体数值的具体代码方案,确保数据能顺利写入数据库。
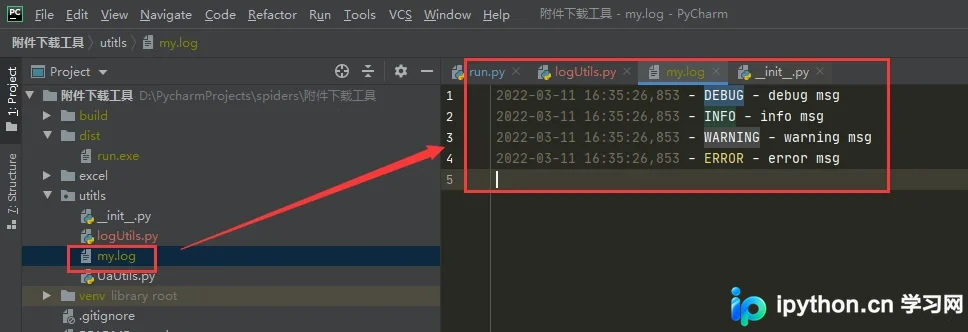
本文介绍如何使用Python和pandas编写命令行脚本处理Excel文件。内容包括封装logging日志模块、接收操作目录、检测并读取唯一Excel文件、自动备份、异常处理、动态添加列以及进度展示与阶段保存等实用技巧,帮助开发者高效完成数据批量处理任务。
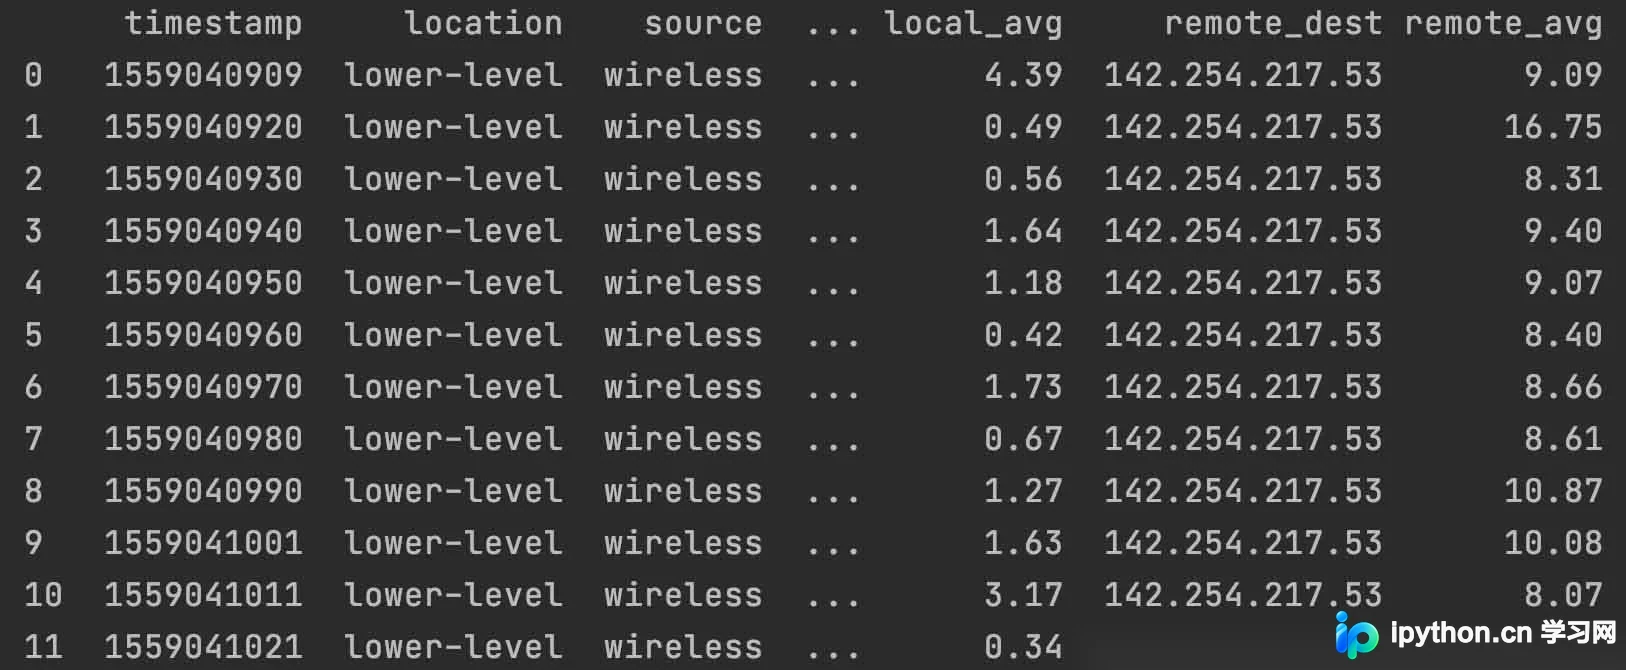
本文详解pandas库中to_datetime()函数的核心用法,重点讲解如何将CSV数据中的Unix时间戳(timestamp)通过指定unit='s'参数转换为标准的datetime格式,并附带代码示例与运行结果分析,帮助开发者高效处理时间序列数据。
本文详解pandas核心数据结构Series与DataFrame的创建、索引及排序操作,并介绍numpy高效存取硬盘数据的二进制文件格式。涵盖np.save与np.load的使用,以及np.savez保存多个未压缩数据的方法,帮助开发者掌握Python数据分析与存储的基础技能。
本文详解Python中True和False的使用陷阱,重点区分逻辑取反not与按位取反~的差异。解析if条件语句中非零值自动转为True的机制,以及pandas DataFrame.loc中布尔索引与Series取反行为的特殊性,帮助开发者避免常见错误。
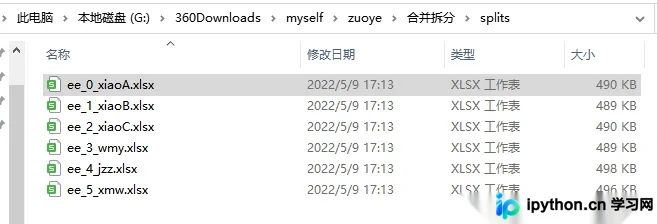
本文介绍如何利用Python Pandas库实现Excel文件的批量拆分与合并。首先演示如何将单个大型Excel按行数等分为多个子文件,并保存至指定目录;接着展示如何遍历文件夹读取多个小Excel,通过添加来源列并使用pd.concat进行合并,最终输出包含来源标记的完整大文件。
本文详细介绍Python3中Pandas库处理DataFrame缺失值(NaN/None)的四种核心方法。涵盖使用isnull和notnull进行判断,通过布尔索引过滤含缺失值数据,利用fillna方法按指定策略(如ffill/bfill)或数值填充,以及使用dropna按行或列删除缺失数据。文章包含具体参数说明与代码示例,帮助开发者高效完成数据清洗工作。
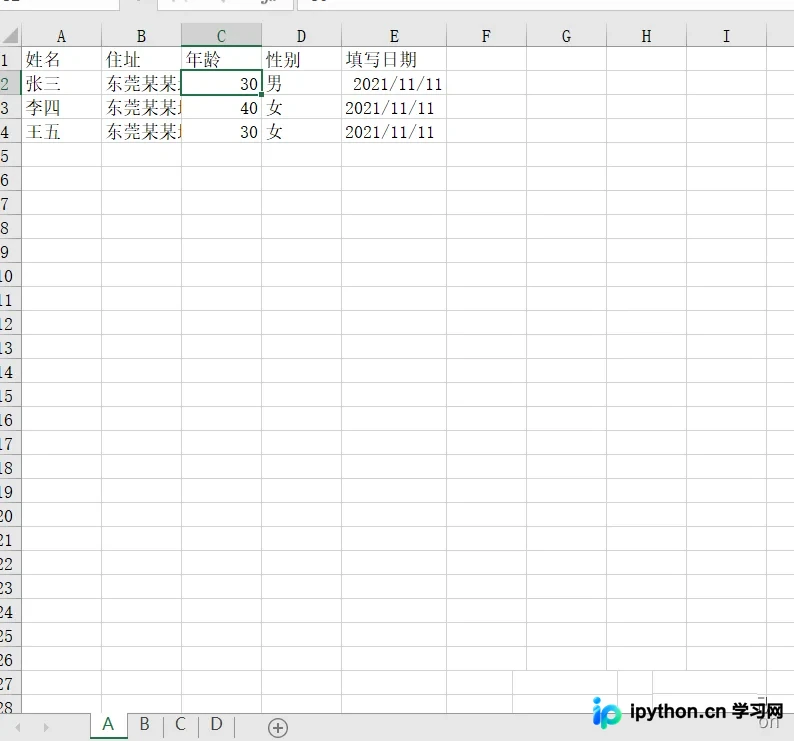
本文详解如何利用Python的Pandas库高效处理包含多个Sheet的Excel文件。通过sheet_name=None参数一次性读取所有工作表,遍历字典对象进行数据清洗(如新增列),并使用ExcelWriter将处理后的多份数据批量写入新Excel文件的对应Sheet中,实现自动化数据处理流程。
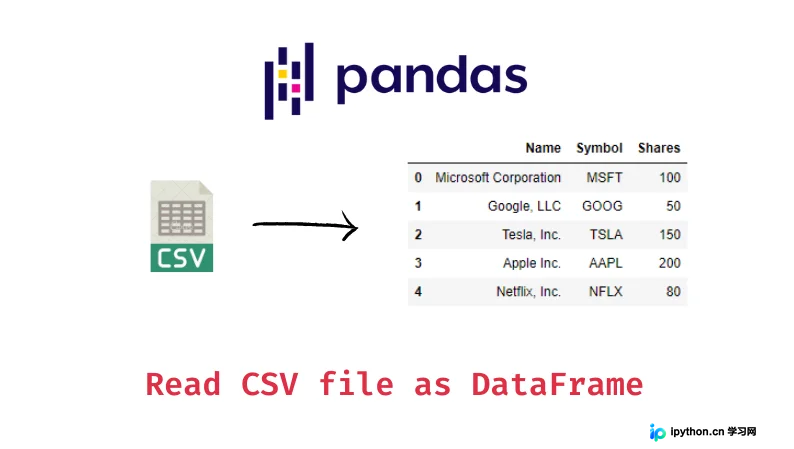
本文介绍在Pandas中删除指定列包含特定值行的两种常用方法。首先讲解dropna函数处理缺失值的参数配置,随后详解drop函数通过index参数精准删除指定行的操作。结合实例演示如何统计、定位并移除“ZH_Term_len”列为0的数据,最后重置索引完成数据清洗。