


Python Pandas批量拆分与合并Excel文件实战

发布时间:2026-10-15 |
5人浏览过
本文介绍如何利用Python Pandas库实现Excel文件的批量拆分与合并。首先演示如何将单个大型Excel按行数等分为多个子文件,并保存至指定目录;接着展示如何遍历文件夹读取多个小Excel,通过添加来源列并使用pd.concat进行合并,最终输出包含来源标记的完整大文件。
前言
本文主要记录使用Python进行Excel文件批量处理的核心逻辑,涵盖拆分与合并两个关键步骤。
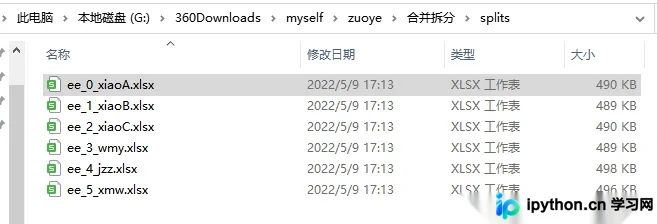
核心需求之一是将一个包含大量数据的Excel文件,按照固定规则等分为多个独立的Excel文件。
核心需求之二是将分散的多个小型Excel文件重新合并为一个大型Excel文件,并在合并过程中自动标记每个数据块的原始来源。
以下为具体的实现代码与操作示例,供读者参考学习。
一、拆分成小表格
具体实现代码如下所示:
import pandas as pd
import os
work_dir=r"G:\360Downloads\myself\zuoye\合并拆分"
splits_dir=f"{work_dir}\splits"
#如果不存在splits文件夹则创建它
if not os.path.exists(splits_dir):
    os.mkdir(splits_dir)
#引入源文件
df_source=pd.read_excel(f"{work_dir}/5月份台账.xlsx",sheet_name="5月份台账87334",skiprows=2)
df_source.head(3)
df_source.index
df_source.shape
total_row_count=df_source.shape[0]
total_row_count
#拆分成多个大小相同的excel
#1.使用df.iloc方法
#2.使用dataframe.to_excel保存到每个小excel中
#计算拆分后小excel的行数
user_names=["xiaoA","xiaoB","xiaoC","wmy","jzz","xmw"]
#每个人的任务数
split_size=total_row_count//len(user_names)
if total_row_count%len(user_names)!=0:
    split_size+=1
split_size
#拆分多个dataframe
df_subs=[]
#enumerate() 函数用于将一个可遍历的数据对象(如列表、元组或字符串)组合为一个索引序列
for idx,user_name in enumerate(user_names):
    #iloc的开始索引
    begin=idx*split_size
    #iloc的结束索引
    end=begin+split_size
    #实现df按照iloc拆分
    df_sub=df_source.iloc[begin:end]
    #将每个子df存入列表
    df_subs.append((idx,user_name,df_sub))
#将每个dataframe存入excel
for idx,user_name,df_sub in df_subs:
    filename=f"{splits_dir}/ee_{idx}_{user_name}.xlsx"
    df_sub.to_excel(filename,index=False)
二、合并excel
1.介绍
第一步,遍历目标文件夹,获取所有需要合并的Excel文件名列表。
第二步,依次读取每个Excel文件至DataFrame对象,并为每一行数据添加标识来源的列。
第三步,调用pd.concat函数对多个DataFrame进行批量合并。
第四步,将合并后的最终DataFrame结果导出保存为一个新的Excel文件。
2.代码
具体实现代码如下所示:
import pandas as pd
import os
work_dir=r"G:\360Downloads\myself\zuoye\合并拆分"
splits_dir=f"{work_dir}\splits"
#如果不存在splits文件夹则创建它
if not os.path.exists(splits_dir):
    os.mkdir(splits_dir)
#遍历文件夹,得到要合并的excel名称列表
excel_names=[]
for excel_name in os.listdir(splits_dir):
    excel_names.append(excel_name)
excel_names
df_list=[]
for excel_name in excel_names:
    #读取每个excel到df
    excel_path=f"{splits_dir}/{excel_name}"
    df_split=pd.read_excel(excel_path)
    username=excel_name.replace("ee_","").replace(".xlsx","")[2:]
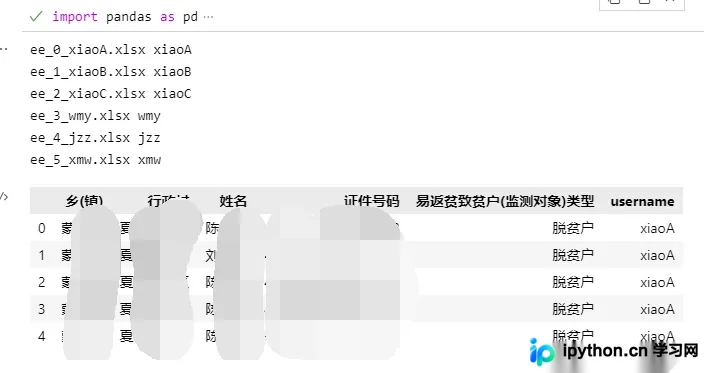
    print(excel_name,username)
    #添加列,用户名字
    df_split["username"]=username
    df_list.append(df_split)
#concat合并
df_merged=pd.concat(df_list)
df_merged.shape
df_merged.head()
df_merged["username"].value_counts()
#输出
df_merged.to_excel(f"{work_dir}/merged.xlsx",index=False)
至此,关于使用Pandas实现Excel批量拆分与合并的示例代码介绍完毕。如需了解更多相关技巧,可搜索本站往期文章或继续浏览后续内容,感谢支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















