Python数据分组与词频统计:从基础字典到Counter的高效实践
本文详解Python中数据分组的多种实现方式。通过对比手动构建字典、使用setdefault方法以及collections模块中的defaultdict和Counter类,展示如何优雅地处理分组与词频统计任务。文章涵盖具体代码示例、参数设置及去重技巧,帮助开发者选择最适合的场景方案。
2026-10-15
0



本文详解Python中数据分组的多种实现方式。通过对比手动构建字典、使用setdefault方法以及collections模块中的defaultdict和Counter类,展示如何优雅地处理分组与词频统计任务。文章涵盖具体代码示例、参数设置及去重技巧,帮助开发者选择最适合的场景方案。
本文详细介绍 Python 内置 logging 模块的使用方法。涵盖日志的五个等级(CRITICAL 至 DEBUG)及其默认行为,解析 logging.basicConfig 的基础配置参数。深入讲解 Logger、Handler、Filter 和 Formatter 四大核心组件的功能与交互,演示如何通过 StreamHandler、FileHandler 等将日志输出至不同目标,并提供 conf 和 yaml 两种配置文件的使用示例,对比 logging 与 print 的优势。
本文详细介绍Python第三方库Tenacity的高级重试功能。涵盖无条件重试、设置重试次数与时间限制、基于异常类型或结果的条件重试,以及重试失败后的错误重新抛出和回调函数配置。通过具体代码示例,帮助开发者优雅地处理网络请求超时等不可控因素。
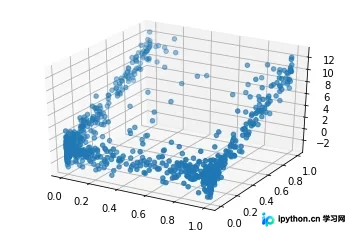
本文介绍如何使用 Python 的 Copula 库生成三维合成数据集并绘制散点图。通过 GaussianMultivariate 模型拟合边缘与联合分布,利用 sample 方法生成新样本,并对比真实与拟合数据的三维散点差异。同时详解模型的 save、load 及参数提取与重建流程,适用于需要高效采样与模型持久化的场景。
本文深入解析Python re模块中findall()函数的核心机制。详细阐述正则表达式中.*与.*?的贪婪及非贪婪匹配差异,解析括号分组对返回结果类型(元组或字符串)的影响,并说明re.S标志在处理含换行符字符串时的关键作用,帮助开发者精准控制正则匹配行为。
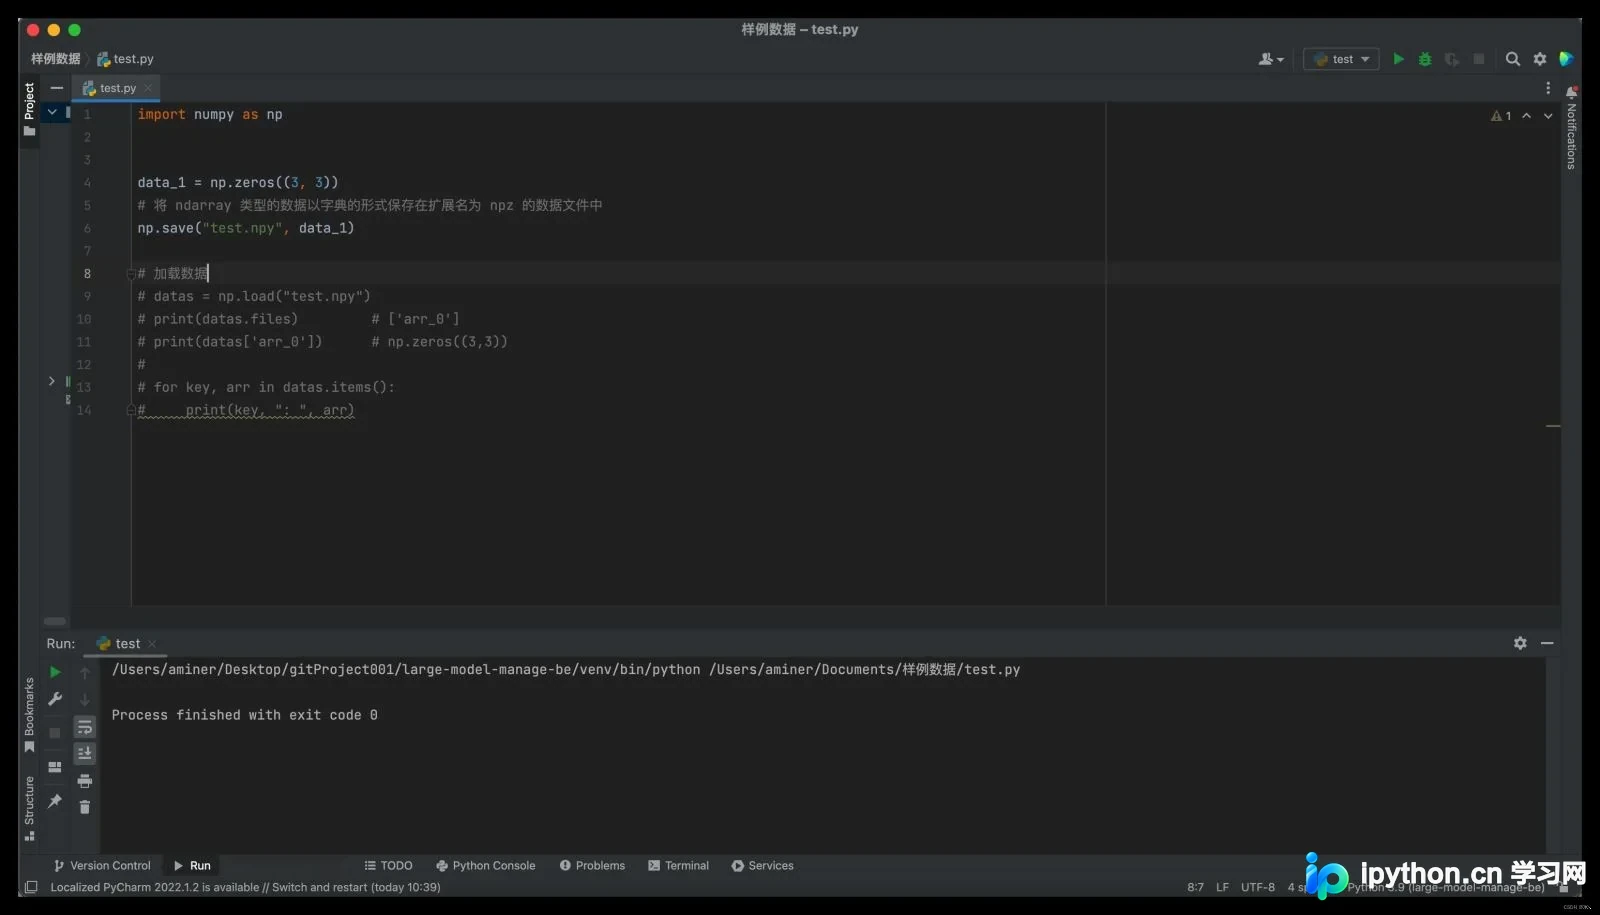
本文详细介绍Python中利用Numpy库将数据保存为npy和npz格式的方法,包括使用save和savez函数进行二进制存储,以及通过load函数读取数据并访问数组内容的完整代码示例。
本文深入解析Python并发场景下的线程锁机制。通过电商库存扣减实例,阐述加锁防止数据竞争的必要性。详细对比threading.Lock的两种实现方式:手动acquire/release与with语句,并指出忘记释放锁的风险。进一步介绍可重入锁RLock解决递归死锁的方案,帮助开发者避免常见并发陷阱。
本文详解如何利用Python和OpenCV实现视频帧的快速提取。通过引入threading库进行多线程处理,显著提升单线程下的处理速度。同时提供剔除中间指定帧数的代码示例,展示如何按条件跳过写入,适用于需要特定帧序列的视频处理场景。
本文详细介绍Python中如何使用内置csv库读取和写入CSV文件。涵盖以列表形式进行单行及批量写入、读取数据,以及利用字典形式写入表头与数据、直接解析为有序字典读取的方法。同时提供文件打开模式(r, w, a, r+, w+, a+, b)的详细说明,帮助开发者掌握CSV数据处理的核心技巧。
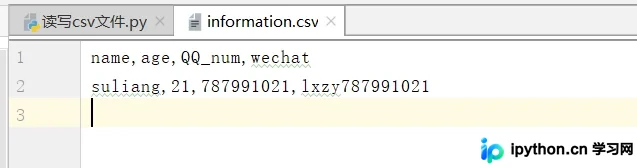
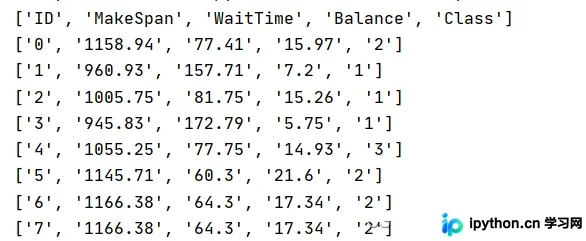
本文详细介绍Python中如何使用内置csv模块读取和写入CSV文件。重点讲解csv.reader()按行分割数据、通过索引访问元素,以及csv.DictReader()利用表头键值读取数据的方法。同时涵盖写入CSV时的open参数设置、csv.writer配置及writerow与writerows的具体用法,帮助开发者高效处理CSV数据。
本文详细介绍Python中help函数的使用方法。通过交互式命令行,开发者可以利用help()查看模块、类方法、变量及内置函数(如print)的详细文档。文章演示了如何通过命令查看pandas模块及其read_csv函数的接口说明,并指导用户通过回车键分页浏览长文档,解决英文文档阅读障碍,提升开发效率。
本文深入解析Python高阶函数的核心概念,阐述函数名作为变量的特性。详细讲解lambda匿名函数的语法,并逐一演示map、filter和reduce三个常用高阶函数的用法、参数传递及在Python 2与3中的版本差异,帮助开发者掌握函数式编程技巧。



