


Python Copula 实现绘制散点模型:从数据生成到模型持久化

发布时间:2026-10-15 |
6人浏览过
本文介绍如何使用 Python 的 Copula 库生成三维合成数据集并绘制散点图。通过 GaussianMultivariate 模型拟合边缘与联合分布,利用 sample 方法生成新样本,并对比真实与拟合数据的三维散点差异。同时详解模型的 save、load 及参数提取与重建流程,适用于需要高效采样与模型持久化的场景。
一、使用 Copula 生成合成数据集(synthetic dataset)
1. 三维数据描述
构建一个包含三维变量的数据表,并可视化其散点分布情况:
from copulas.datasets import sample_trivariate_xyz
data = sample_trivariate_xyz()
from copulas.visualization import scatter_3d
scatter_3d(data)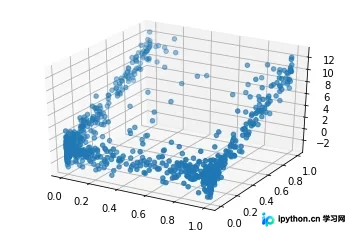
2. 使用高斯 Copula 对数据集建模
调用 GaussianMultivariate(自动)来估计 x、y、z 的边缘分布及联合分布,以此完成对数据集的建模过程。
from copulas.multivariate import GaussianMultivariate
copula = GaussianMultivariate()
copula.fit(data)
3. 使用拟合后的模型生成新的数据集
利用 sample 按照已拟合的边缘分布生成 1000 个新样本点(每个边缘分布生成 1000 个样本,3 个边缘分布共计生成 3000 个样本点)。
num_samples = 1000
synthetic_data = copula.sample(num_samples)
synthetic_data.head()
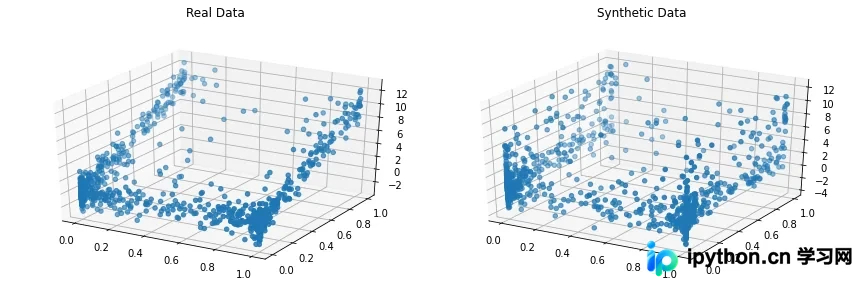
4. 观察三维散点图,比较拟合数据与真实数据的差异
from copulas.visualization import compare_3d
compare_3d(data, synthetic_data)
5. 保存与加载模型拟合路径
对于拟合 Copula 模型耗时较长的数据,可在获得合适模型后,使用 save 将其保存。后续在需要采样新数据时,通过 load 从磁盘加载已拟合好的模型。
model_path = 'mymodel.pkl'
copula.save(model_path)
new_copula = GaussianMultivariate.load(model_path)
new_samples = new_copula.sample(num_samples)
6. 提取和设置参数
在某些场景下,从拟合的模型中提取参数比从磁盘保存和加载更为便捷。可以使用 to_dict 方法获取 Copula 模型的参数:
copula_params = copula.to_dict()获得所有参数后,可通过 from_dict 创建一个新的、与原模型相同的 Copula 模型:
new_copula = GaussianMultivariate.from_dict(copula_params)
# 用新模型生成新的参数:
new_samples = new_copula.sample(num_samples)
至此,关于 Python Copula 实现绘制散点模型的介绍完毕。如需了解更多 Python Copula 相关内容,请搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















