Windows cmd输入Python无反应?手动配置Python 3环境变量教程
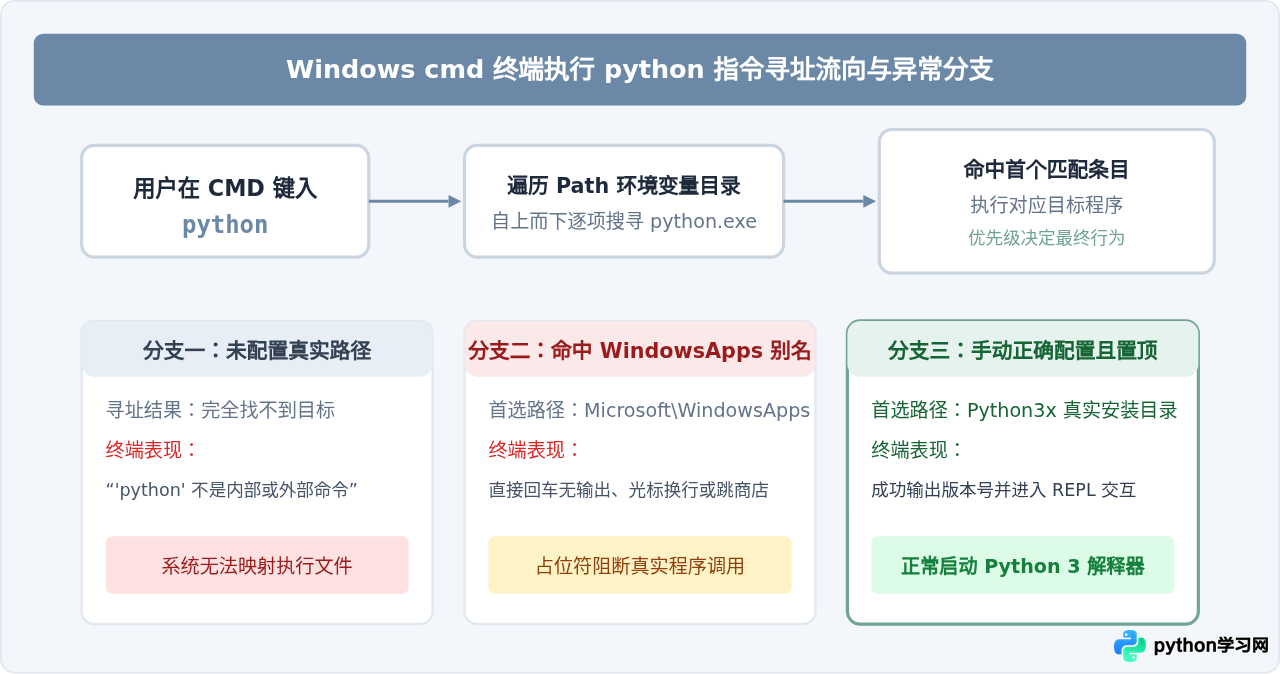
针对Windows命令提示符(cmd)中输入Python无反应、无输出或跳转应用商店的问题,系统梳理产生原因,并提供详细的手动配置Python 3及Scripts环境变量与关闭别名干扰的操作指南。
2026-10-20
0



针对Windows命令提示符(cmd)中输入Python无反应、无输出或跳转应用商店的问题,系统梳理产生原因,并提供详细的手动配置Python 3及Scripts环境变量与关闭别名干扰的操作指南。
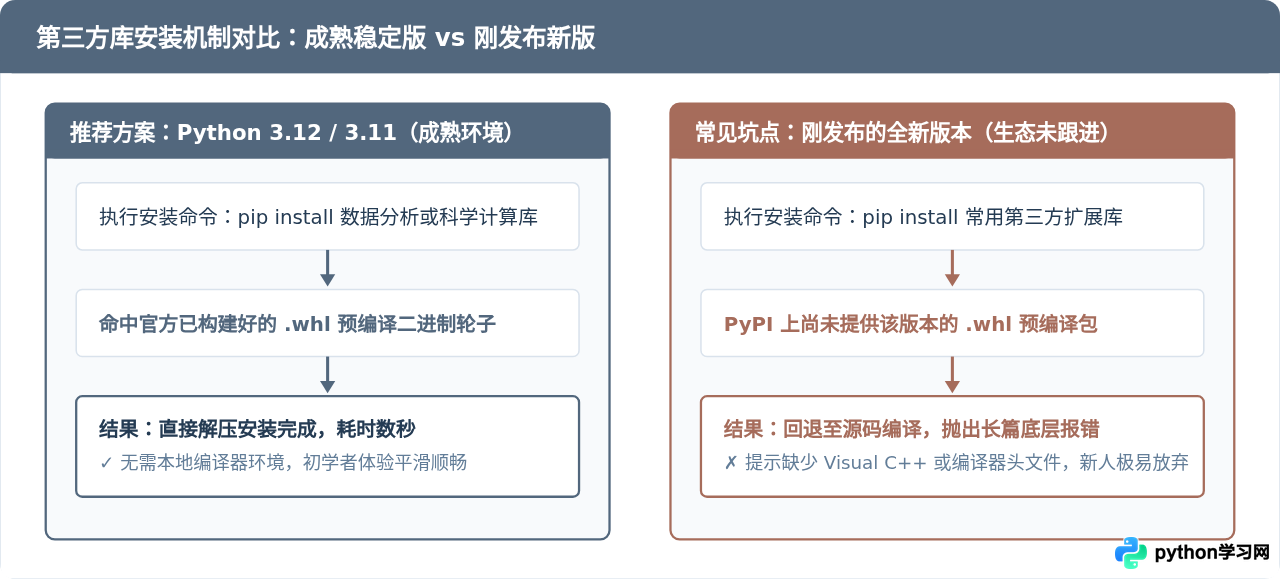
针对初学者的Python版本选择指南,详细分析为什么推荐安装3.12或3.11稳定版,剖析第三方库兼容性与wheel预编译原理,并提供清晰的安装与验证步骤。
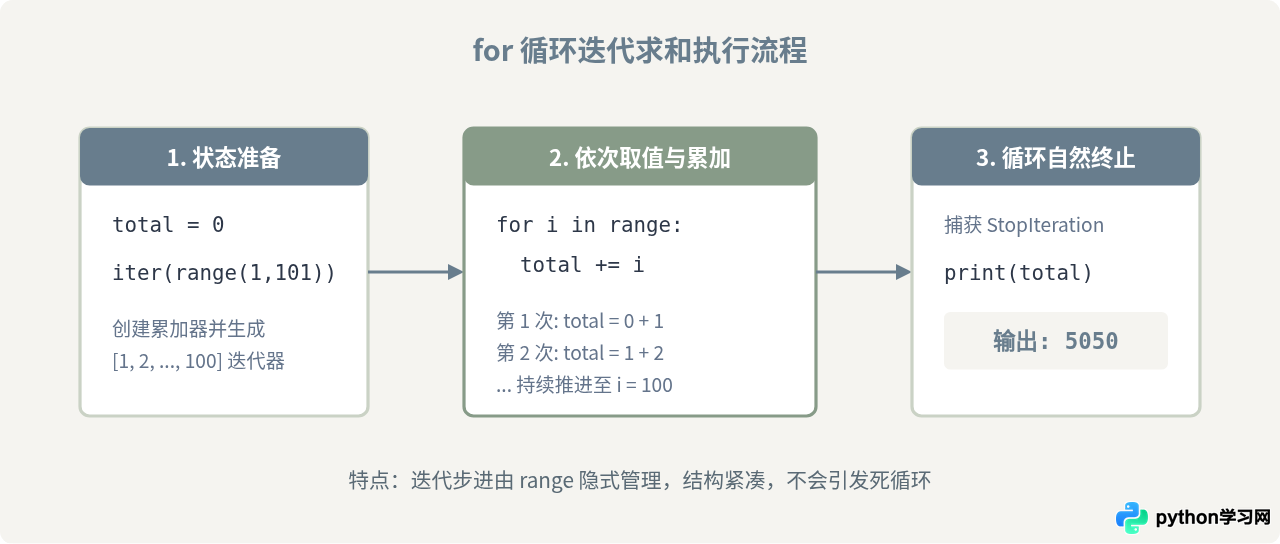
详细对比Python中实现1加到100的三种经典方法:for循环、while循环与内置sum函数。深入分析代码实现、执行机制、易错陷阱与选型场景,附高清晰架构图解。
本文详细介绍Numpy中np.array()函数的核心用法。涵盖ndarray对象特性、object与dtype参数的类型转换规则、copy参数对内存地址的影响、ndmin升维操作及subok参数对子类的处理。通过代码示例解析不同场景下的数组创建与行为差异,帮助开发者高效掌握Numpy数组基础操作。
本文详细解析Python pandas库中pd.cut()与pd.qcut()两个数据离散化函数的区别。pd.cut()基于固定区间或数量进行等距划分,而pd.qcut()基于分位数确保各区间样本数量一致。文章通过具体代码示例对比了参数如bins、q、right、include_lowest及duplicates的使用场景,帮助开发者根据数据分布特征选择合适的离散化方法。
本文通过实际 SQL 操作和 EXPLAIN 执行计划,详细验证 MySQL 联合索引的最左前缀匹配原则。文章对比了单一索引与联合索引在精确查询及 LIKE 模糊查询中的表现,揭示了范围查询中断索引匹配的规则,帮助开发者在日常 MySQL 调优中正确设计和使用复合索引。
本文通过对比Python和Ruby中for循环的实现机制,揭示两者在对象模型上的根本差异。Python采用迭代器协议,由对象提供迭代接口,循环体处理数据;而Ruby将循环视为对象方法,通过代码块传递执行逻辑。文章深入探讨了列表推导式、自定义迭代及方法可见性,阐述Python偏向过程式扩展,而Ruby坚持面向对象优先的设计哲学。
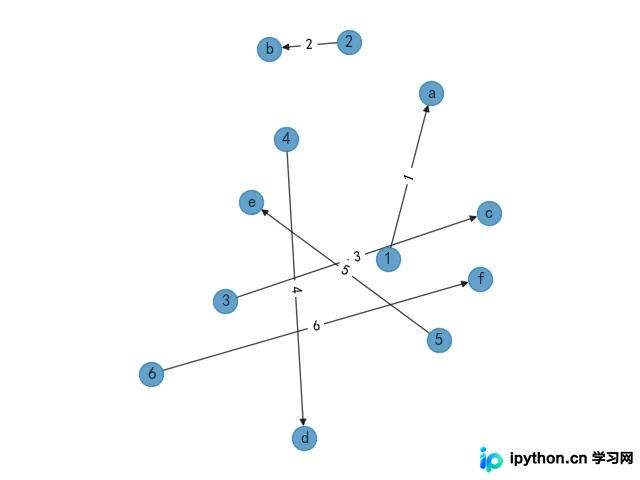
本文基于Python的NetworkX库,详细对比了四种关系图可视化布局的效果。通过模拟DataFrame数据,分别演示了随机分布、放射状、特征值向量及图形边缘化(壳层)模型。文章提供了完整的代码实现与参数设置,帮助开发者根据数据特性选择最合适的可视化方案,以清晰展示节点间的关联关系。
在Windows系统重装或更换MySQL版本前,需彻底清除残留配置以免冲突。核心步骤包括:通过计算机管理或命令行(net stop mysql)停止所有服务;利用控制面板卸载主程序;使用regedit删除HKEY_LOCAL_MACHINE下的相关注册表项;并手动清理ProgramData目录及隐藏的应用数据文件夹。操作前建议备份重要数据。
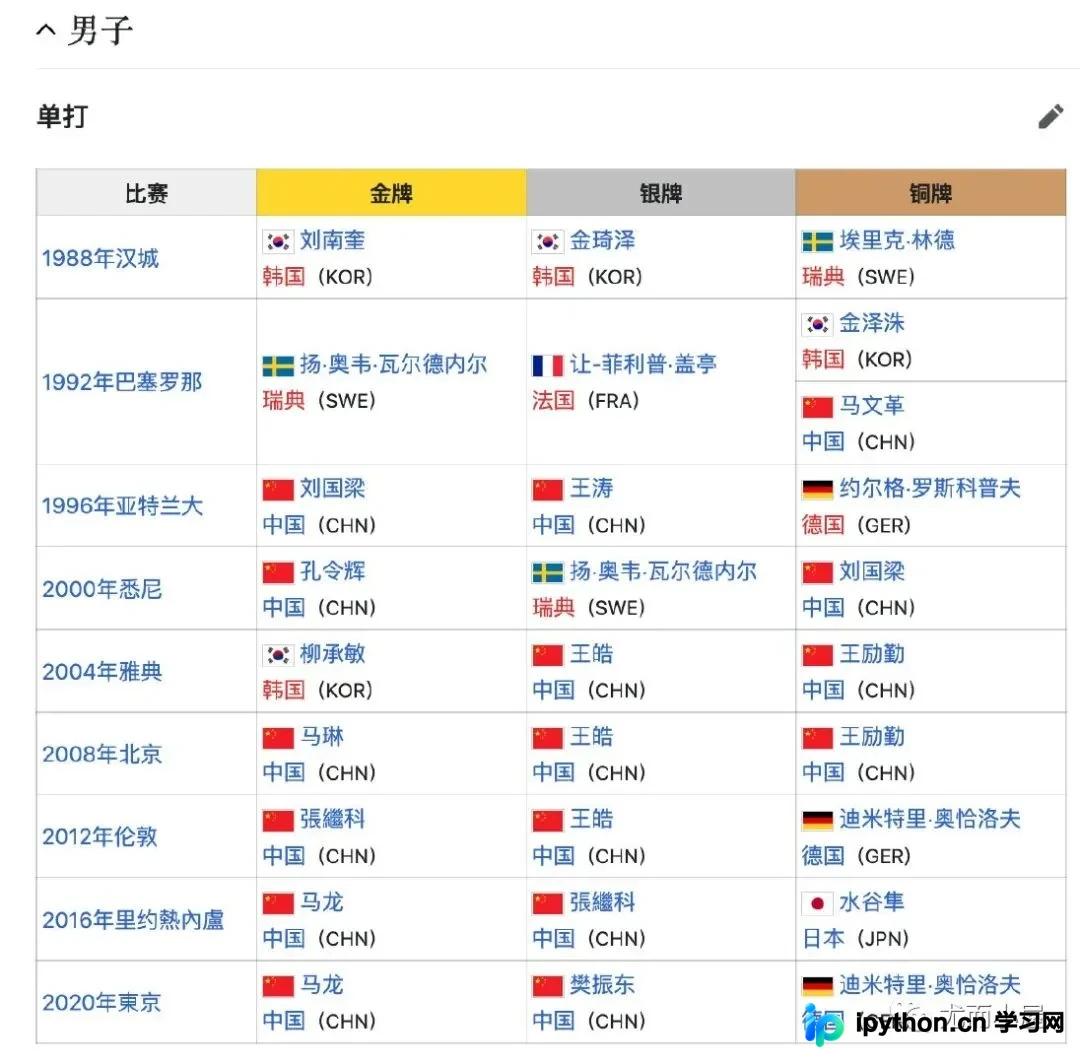
本文详细介绍Pandas中两种高效的数据读取方式:利用read_html直接解析网页表格,以及通过read_clipboard快速导入剪贴板数据。文章涵盖在线HTML与CSV文件的读取技巧,并提供具体代码示例与操作注意事项,帮助开发者简化数据获取流程。
Go语言中的string底层是由[]byte构成的字节序列,具有不可变性。修改字符串需先转换为byte或rune切片再转回,其中rune代表UTF-8字符,能有效处理包含中文字符在内的多字节编码问题,避免乱码。

本文详细解析NumPy中两个数组的叠加操作,包括逐元素相加、沿指定维度拼接及增加维度的堆叠方法。同时厘清size、ndim与shape三个易混淆概念的定义与区别,通过代码示例说明不同操作对数组维度和形状的影响,帮助开发者准确掌握NumPy数组处理技巧。