Python itertools模块常用函数详解与使用指南
本文详细介绍Python内置模块itertools的核心功能与常用函数。涵盖chain串联迭代、groupby分组、count/cycle/repeat无穷迭代,以及product、permutations、combinations等排列组合工具。通过具体代码示例解析语法与参数,帮助开发者高效处理数据迭代任务,无需额外安装即可直接使用。
10-16
5




本文详细介绍Python内置模块itertools的核心功能与常用函数。涵盖chain串联迭代、groupby分组、count/cycle/repeat无穷迭代,以及product、permutations、combinations等排列组合工具。通过具体代码示例解析语法与参数,帮助开发者高效处理数据迭代任务,无需额外安装即可直接使用。
本文详解Python 3中zip()函数的核心机制与常见应用场景。重点解析zip返回的迭代器特性及其与Python 2返回列表的区别,介绍如何利用zip构建字典、对多序列进行排序及计算,并演示使用*操作符解压zip对象的技巧。
本文详解Python内置函数enumerate(),讲解其语法、参数及返回值。通过for循环示例展示如何同时获取数据与下标,并介绍start参数指定起始索引的方法,帮助开发者更高效地处理可遍历对象。
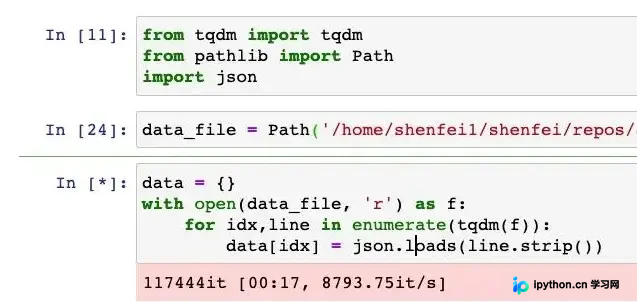
本文分析 Python 中使用 tqdm 模块处理大文件读取时进度条不显示的原因,指出因文件迭代器无法提供总长度导致的问题。通过预计算文件行数的方法,将结果赋值给 tqdm 的 total 参数,成功实现大文件读取进度的实时监控与显示。
本文详细介绍Python标准库itertools中的内置无限迭代器,包括count()生成自然数序列、cycle()循环序列、repeat()重复元素以及takewhile()截取有限序列的方法,并演示chain()串联和groupby()分组技巧,帮助开发者高效处理迭代对象。
本文深入解析Python在遍历列表和字典时直接修改数据导致的漏项或RuntimeError错误。通过剖析迭代器机制,详细演示了利用reversed()翻转列表、copy()浅拷贝列表以及tuple()提取键名三种安全方案,确保在遍历过程中完整处理所有元素而不引发异常。
本文通过对比Python和Ruby中for循环的实现机制,揭示两者在对象模型上的根本差异。Python采用迭代器协议,由对象提供迭代接口,循环体处理数据;而Ruby将循环视为对象方法,通过代码块传递执行逻辑。文章深入探讨了列表推导式、自定义迭代及方法可见性,阐述Python偏向过程式扩展,而Ruby坚持面向对象优先的设计哲学。
本文深入解析Python中range函数的运行机制,澄清其生成的是可迭代对象而非迭代器。详细阐述range作为不可变序列类型的特性,包括其左闭右开区间、参数限制及不支持拼接与重复的原因。结合Python2到Python3的演进历史,探讨range设计背后的性能考量与规范意义,帮助开发者深入理解Python迭代机制。
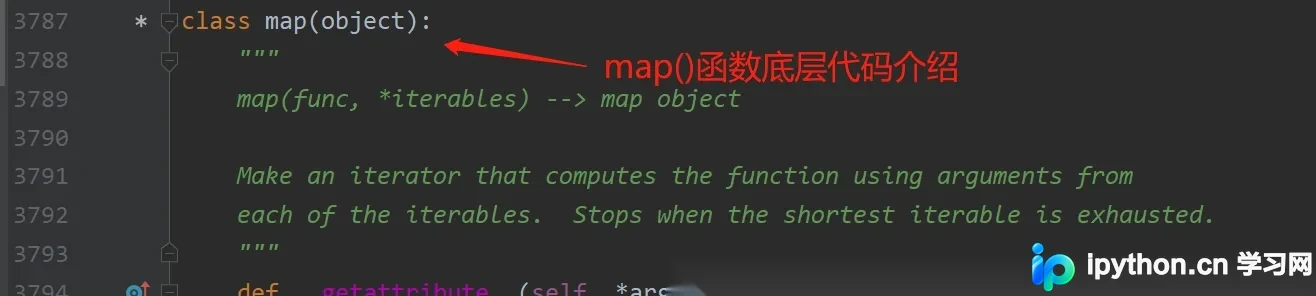
本文详解Python中map()函数的底层原理与使用方法。map(func, *iterables)接收一个函数和多个可迭代对象,将函数作用于每个元素并返回迭代器。文章通过四个示例展示了单列表转换、多列表并行处理及不同函数签名下的行为,重点解析Python 2与3在返回值上的差异,帮助开发者高效利用该内置函数进行数据映射。
本文详解在Python递归函数中如何使用迭代器优化内存占用,分析直接yield返回迭代器对象导致的逻辑错误,并提供next()调用与for循环两种正确写法。同时针对未找到目标文件时触发的StopIteration异常,给出添加空yield或try-except块的两种修复方案,确保递归遍历的稳定性。
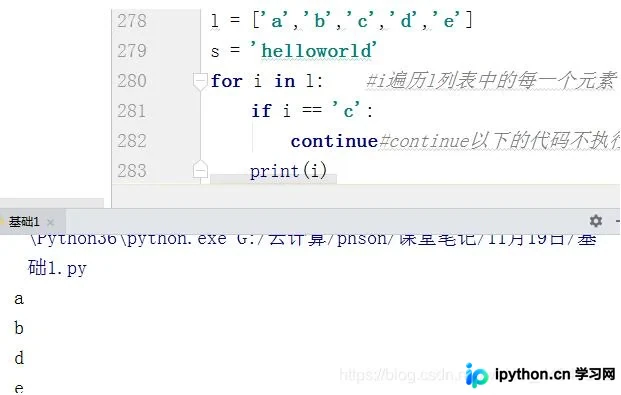
本文探讨在Python的for循环中直接调用pop方法删除元素时,为何会意外跳过某些元素。核心原因在于for循环基于迭代器机制,删除元素后索引偏移导致迭代器指向下一个元素,从而跳过原相邻项。文章提供了使用切片副本nums[:]遍历的解决方案,并简要回顾了continue、break和pass在循环中的基本用法。
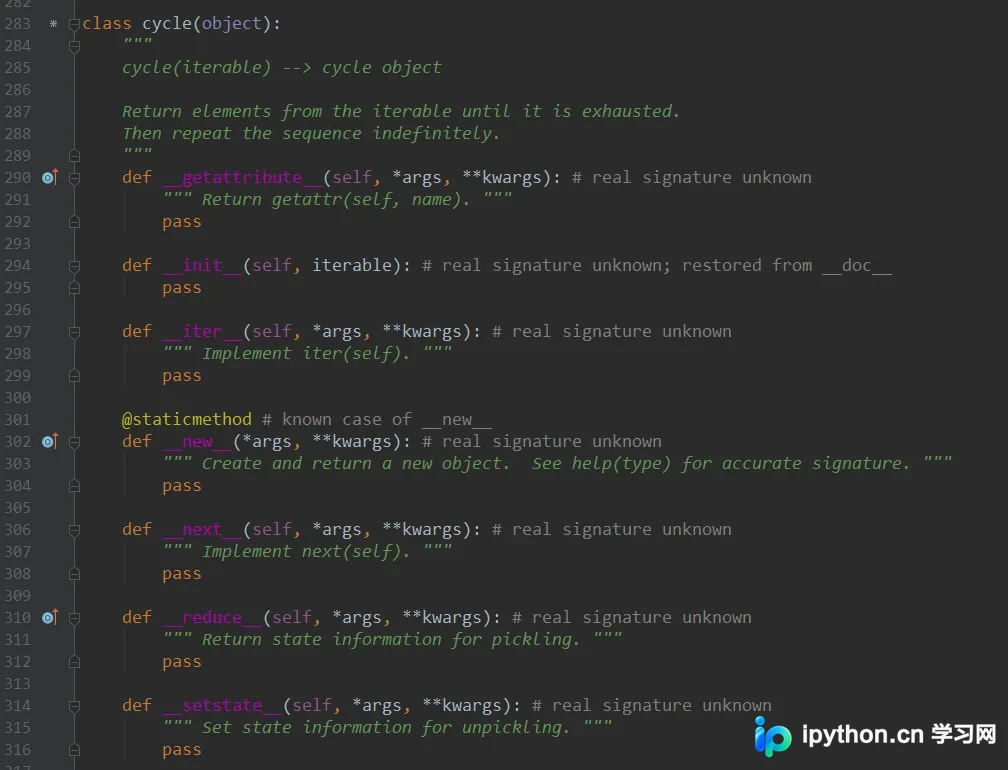
本文详细介绍Python标准库itertools中cycle函数的用法。通过对比普通列表遍历,演示如何利用cycle构造无限循环迭代器,并解析其__iter__与__next__实现原理。结合爬虫场景中Cookie池顺序调用的实例,展示如何在遵守法律前提下高效管理请求频率,实现资源的循环复用。