pandas数据读写详解:CSV/TXT格式处理与参数配置
本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。
2026-10-16
0



本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。
本文介绍在Pandas中修改DataFrame值时如何避免链式索引(Chained Indexing)导致的SettingWithCopyWarning。通过对比直接链式访问与使用loc方法的差异,说明直接标签访问的潜在问题,并推荐正确的赋值方式以确保数据修改生效。
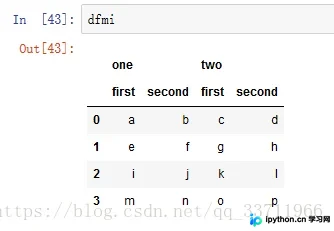
本文详解Python pandas库中数据合并与拼接的三种核心方法:merge、join和concat。重点解析merge基于列的内、外、左、右连接参数,join基于索引的连接方式,以及concat对Series和DataFrame的行/列拼接操作,涵盖多列连接、索引处理及常见报错解决方案。
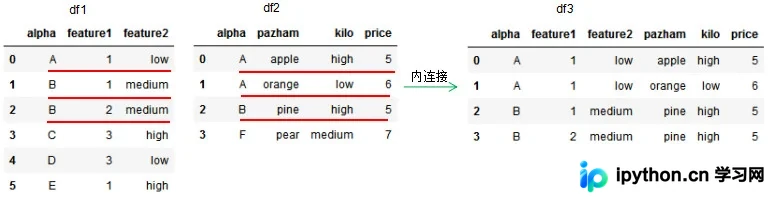
本文深入解析pandas库中df.iloc[]索引器的核心用法。与df.loc[]基于标签不同,iloc[]严格依据数据在DataFrame中的位置坐标进行提取。文章详细说明了其支持的参数类型,包括整数、列表及切片操作,并通过具体代码示例展示了如何获取特定单元格、整行数据、子集以及实现行列倒序排列,帮助开发者高效进行数据筛选与处理。
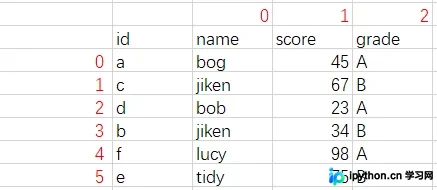
本文详细介绍 pandas 中 DataFrame.sample() 函数的用法,涵盖 n、axis、weights 和 frac 等关键参数。通过具体代码示例演示如何随机获取行、列、指定数量或按比例抽样,帮助开发者快速掌握数据随机采样技巧。
本文详细介绍pandas中DataFrame.rename()方法的使用。该方法用于更改行列标签(索引),支持传入字典或函数。文章解析了mapper、index、columns、axis、copy、inplace、level及errors等关键参数,并通过代码示例演示了如何修改行索引、列名以及处理多层索引和错误情况。
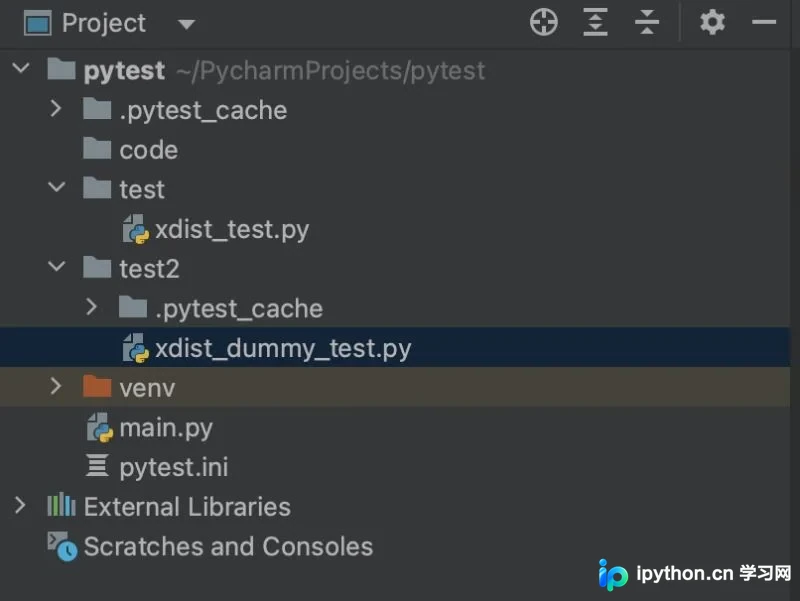
本文深入解析 pytest-xdist 插件的高级用法,涵盖使用 -n 参数调用多核资源,以及 --dist 命令参数的四种分发模式:load、loadscope、loadfile 和 loadgroup。重点介绍如何通过 xdist_group 标记实现测试用例的灵活分组,确保特定测试在同一 Worker 中运行,适用于需要共享 Fixture 或状态的场景。
本文通过出租车计价场景,演示如何使用飞桨PaddlePaddle构建线性回归模型。从定义数学关系Y=2x+10生成数据集,到使用paddle.nn.Linear搭建网络,结合MSELoss与SGD优化器进行5000次迭代训练。代码完整展示了张量转换、前向传播、反向传播及参数更新的全过程,帮助开发者理解机器学习基础流程。
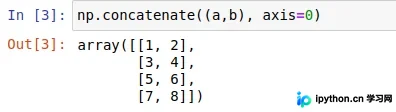
本文详解NumPy中数组叠加的多种实现方式,包括使用np.r_和np.c_进行行列堆叠,以及hstack和vstack函数的具体应用。重点解析一维数组在叠加时自动转为二维的机制,以及不同维度数组混合叠加时的行为差异,帮助开发者掌握高效的数组处理技巧。
本文详细解析NumPy中两个数组的叠加操作,包括逐元素相加、沿指定维度拼接及增加维度的堆叠方法。同时厘清size、ndim与shape三个易混淆概念的定义与区别,通过代码示例说明不同操作对数组维度和形状的影响,帮助开发者准确掌握NumPy数组处理技巧。
本文通过OpenCV实例详解如何校正倾斜图片。重点解析cv2.minAreaRect()函数的返回值结构,包括中心点、边长顺序及角度含义,并提供完整的Python代码实现从灰度二值化、轮廓筛选到旋转抠图的全过程。
本文详解如何在Flask框架中集成flasgger库,自动生成符合OpenAPI规范的在线接口文档。通过Python代码与YAML配置文件的配合,实现复杂JSON参数的自动解析与可视化展示。文章提供了从环境安装、代码编写到在线调试的完整流程,帮助开发者提升前后端协作效率,无需手动维护文档即可实现接口的实时同步与在线测试。