


pandas数据合并与拼接:merge、join与concat详解

本文详解Python pandas库中数据合并与拼接的三种核心方法:merge、join和concat。重点解析merge基于列的内、外、左、右连接参数,join基于索引的连接方式,以及concat对Series和DataFrame的行/列拼接操作,涵盖多列连接、索引处理及常见报错解决方案。
pandas库提供了merge、join和concat三种方法来实现数据的合并与拼接。其中,merge方法主要依据两个DataFrame的共同列进行合并;join方法侧重于基于索引进行合并;而concat方法则用于对Series或DataFrame执行行或列方向的拼接操作。
1. Merge方法
pandas的merge函数通过指定的共同列将两个DataFrame连接在一起。该函数的主要参数包括:
- left/right:分别指定左侧和右侧的DataFrame对象。
- how:定义数据合并的模式。可选值包括'left'(基于左DataFrame列)、'right'(基于右DataFrame列)、'outer'(基于列的并集)以及'inner'(基于列的交集,默认值)。
- on:指定用于合并的列名,要求两个DataFrame中必须存在相同的列名。
- left_on/right_on:分别指定左、右DataFrame中用于合并的列名,这些列也可以是索引、数组或列表。
- left_index/right_index:布尔值,若设为True,则表示使用索引作为合并的依据列。
- sort:是否根据合并键keys对结果进行排序,默认值为True。
- suffixes:当存在未作为合并键的重复列时,通过此参数(通常为元组或列表)为这些列添加后缀以作区分。
通过设置how参数,merge方法支持内连接、外连接、左连接和右连接四种模式。下文将通过具体示例阐释各连接方式的含义。
1.1 内连接
当how='inner'时,执行内连接操作。这相当于基于共同列的交集进行数据匹配,需通过on参数指定共有的列名。
# 单列的内连接
# 定义df1
import pandas as pd
import numpy as np

df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'feature1':[1,1,2,3,3,1],
            'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'pazham':['apple','orange','pine','pear'],
            'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
# print(df1)
# print(df2)
# 基于共同列alpha的内连接
df3 = pd.merge(df1,df2,how='inner',on='alpha')
df3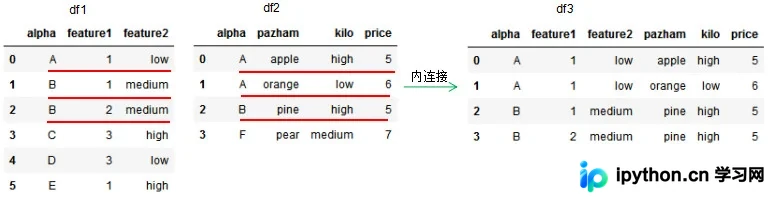
此处取共同列alpha值的交集进行连接。
1.2 外连接
当how='outer'时,执行外连接操作。这相当于基于共同列的并集进行数据匹配,需通过on参数指定共有的列名。
# 单列的外连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'feature1':[1,1,2,3,3,1],
                'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
# 基于共同列alpha的内连接
df4 = pd.merge(df1,df2,how='outer',on='alpha')
df4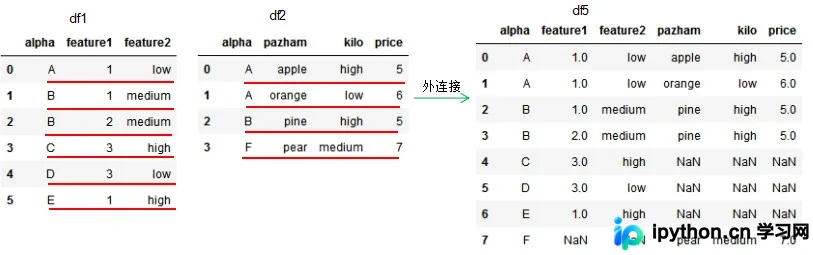
若两个DataFrame除on指定的连接列外无其他相同列,则相关列的值将显示为NaN。
1.3 左连接
当how='left'时,执行左连接操作。这相当于基于左侧DataFrame的列进行数据匹配,需通过on参数指定共有的列名。
# 单列的左连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'feature1':[1,1,2,3,3,1],
    'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
# 基于共同列alpha的左连接
df5 = pd.merge(df1,df2,how='left',on='alpha')
df5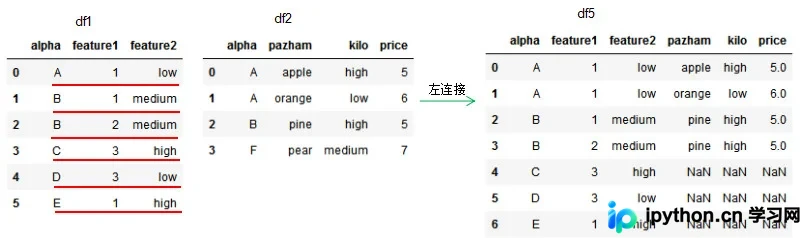
由于df2的连接列alpha包含两个'A'值,左连接后的df5结果中也对应出现两个'A'值。若两个DataFrame除on指定的连接列外无其他相同列,则相关列的值将显示为NaN。
1.4 右连接
当how='right'时,执行右连接操作。这相当于基于右侧DataFrame的列进行数据匹配,需通过on参数指定共有的列名。
# 单列的右连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'feature1':[1,1,2,3,3,1],
'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
# 基于共同列alpha的右连接
df6 = pd.merge(df1,df2,how='right',on='alpha')
df6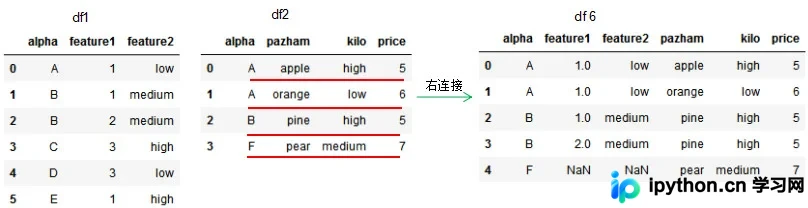
由于df1的连接列alpha包含两个'B'值,右连接后的df6结果中也对应出现两个'B'值。若两个DataFrame除on指定的连接列外无其他相同列,则相关列的值将显示为NaN。
1.5 基于多列的连接算法
多列连接的逻辑与单列连接一致。本节仅展示基于多列的内连接和右连接示例,读者可自行编写代码,并参照本文图解理解外连接和左连接的处理方式。
多列的内连接示例如下:
# 多列的内连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'beta':['a','a','b','c','c','e'],
                    'feature1':[1,1,2,3,3,1],'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'beta':['d','d','b','f'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
# 基于共同列alpha和beta的内连接
df7 = pd.merge(df1,df2,on=['alpha','beta'],how='inner')
df7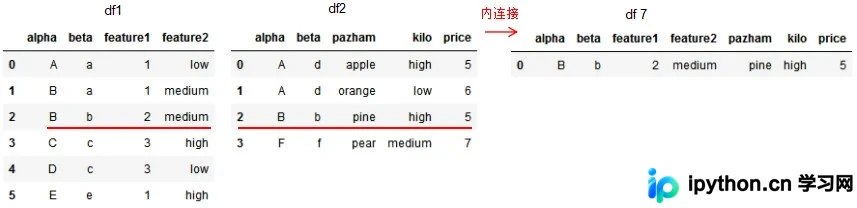
多列的右连接示例如下:
# 多列的右连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'beta':['a','a','b','c','c','e'],
                    'feature1':[1,1,2,3,3,1],'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'beta':['d','d','b','f'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])})
print(df1)
print(df2)

# 基于共同列alpha和beta的右连接
df8 = pd.merge(df1,df2,on=['alpha','beta'],how='right')
df8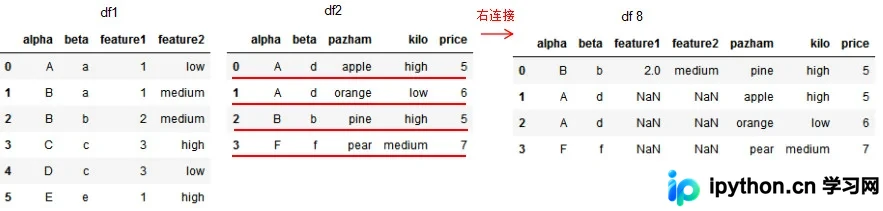
1.6 基于index的连接方法
前述内容介绍了基于列的连接方式,merge方法同样支持基于索引连接DataFrame。
# 基于column和index的右连接
# 定义df1
df1 = pd.DataFrame({'alpha':['A','B','B','C','D','E'],'beta':['a','a','b','c','c','e'],
                    'feature1':[1,1,2,3,3,1],'feature2':['low','medium','medium','high','low','high']})
# 定义df2
df2 = pd.DataFrame({'alpha':['A','A','B','F'],'pazham':['apple','orange','pine','pear'],
                        'kilo':['high','low','high','medium'],'price':np.array([5,6,5,7])},index=['d','d','b','f'])
print(df1)
print(df2)

# 基于df1的beta列和df2的index连接
df9 = pd.merge(df1,df2,how='inner',left_on='beta',right_index=True)
df9
以下是基于index和column进行内连接的图解说明:
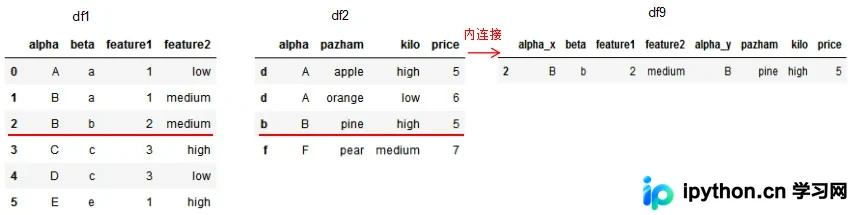
可通过设置参数suffixes来修改除连接列以外相同列的后缀名。
# 基于df1的alpha列和df2的index内连接
df9 = pd.merge(df1,df2,how='inner',left_on='beta',right_index=True,suffixes=('_df1','_df2'))
df9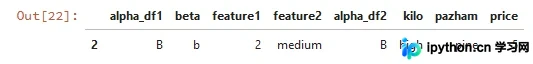
2. join方法
join方法主要基于索引连接DataFrame,而merge方法基于列连接。两者的连接模式均包含内连接、外连接、左连接和右连接,逻辑与merge一致。
以下是index与index连接的示例:
caller = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3', 'K4', 'K5'], 'A': ['A0', 'A1', 'A2', 'A3', 'A4', 'A5']})
other = pd.DataFrame({'key': ['K0', 'K1', 'K2'],'B': ['B0', 'B1', 'B2']})
print(caller)print(other)# lsuffix和rsuffix设置连接的后缀名
caller.join(other,lsuffix='_caller', rsuffix='_other',how='inner')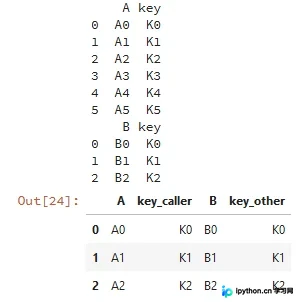
join方法也支持基于列进行连接:
caller = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3', 'K4', 'K5'], 'A': ['A0', 'A1', 'A2', 'A3', 'A4', 'A5']})
other = pd.DataFrame({'key': ['K0', 'K1', 'K2'],'B': ['B0', 'B1', 'B2']})
print(caller)
print(other)

# 基于key列进行连接
caller.set_index('key').join(other.set_index('key'),how='inner')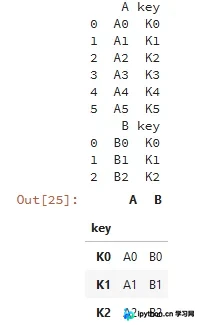
由于join与merge的连接机制相似,此处不再展开join方法的详细讨论,建议优先使用merge方法。
3. concat方法
concat是用于拼接数据的函数,支持行拼接和列拼接,默认行为为行拼接。拼接模式默认为外拼接(即并集),操作对象为pandas数据类型。
3.1 series类型的拼接方法
行拼接示例如下:
df1 = pd.Series([1.1,2.2,3.3],index=['i1','i2','i3'])
df2 = pd.Series([4.4,5.5,6.6],index=['i2','i3','i4'])
print(df1)
print(df2)

# 行拼接
pd.concat([df1,df2])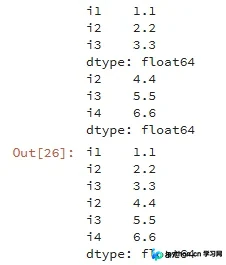
若行拼接中存在相同索引,为区分来源,可在最外层定义索引的分组情况。
# 对行拼接分组
pd.concat([df1,df2],keys=['fea1','fea2'])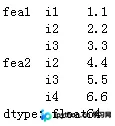
列拼接示例如下:
默认情况下以并集方式拼接:
# 列拼接,默认是并集
pd.concat([df1,df2],axis=1)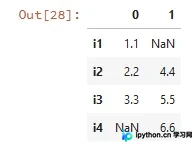
以交集方式拼接:
# 列拼接的内连接(交)
pd.concat([df1,df2],axis=1,join='inner')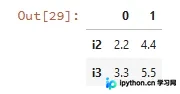
设置列拼接时的列名:
# 列拼接的内连接(交)
pd.concat([df1,df2],axis=1,join='inner',keys=['fea1','fea2'])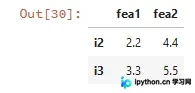
对指定索引进行拼接:
# 指定索引[i1,i2,i3]的列拼接
pd.concat([df1,df2],axis=1,join_axes=[['i1','i2','i3']])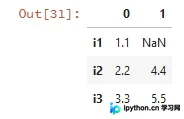
3.2 dataframe类型的拼接方法
行拼接示例如下:
df1 = pd.DataFrame({'key': ['K0', 'K1', 'K2', 'K3', 'K4', 'K5'], 'A': ['A0', 'A1', 'A2', 'A3', 'A4', 'A5']})
df2 = pd.DataFrame({'key': ['K0', 'K1', 'K2'],'B': ['B0', 'B1', 'B2']})
print(df1)
print(df2)

# 行拼接
pd.concat([df1,df2])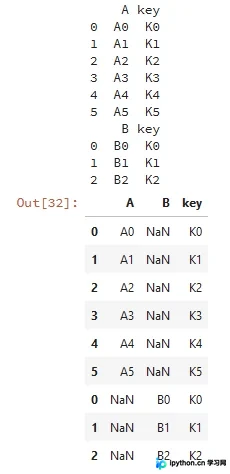
列拼接示例如下:
# 列拼接
pd.concat([df1,df2],axis=1)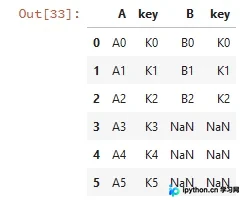
若列拼接或行拼接中出现重复的列名和行名,程序将报错:
# 判断是否有重复的列名,若有则报错
pd.concat([df1,df2],axis=1,verify_integrity = True)
ValueError: Indexes have overlapping values: ['key']
4. 小结
merge和join方法在功能上基本重叠,建议在实际使用中优先选择merge方法。
至此,关于pandas数据合并与拼接的实现介绍完毕。如需了解更多相关pandas数据合并与拼接内容,请搜索本站历史文章或继续浏览后续相关文章,希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















