


pandas数据读写详解:CSV/TXT格式处理与参数配置

本文详解pandas中read_csv与read_table函数的数据读取方法,涵盖分隔符指定、表头处理、索引设置及缺失值标识配置。同时介绍to_csv导出技巧、header与index_col参数用法,以及利用chunksize实现大文件分块读取和聚合操作,帮助高效处理文本格式数据。
1.文本格式数据的读写
使用read_csv()函数可从文件、URL或类文件对象中读取分隔数据,默认分隔符为逗号。
使用read_table()函数同样可从文件、URL或类文件对象读取分隔数据,其默认分隔符为制表符('\t')。
Windows用户在查看文件原始内容时,可通过命令行打印文件内容。
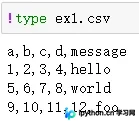
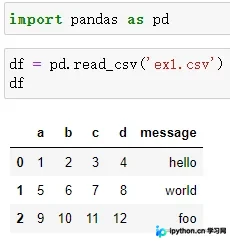
由于该文件采用逗号分隔,我们可以调用read_csv将其加载至DataFrame中。
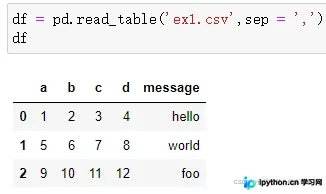
同样可以使用read_table函数,并通过指定分隔符参数来实现读取。
上述示例假设文件包含表头行,但部分文件并不包含表头信息,例如:
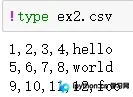
若直接读取此类文件,pandas默认将第一行视为表头,即默认设置header=0,表示第一行为标题行。
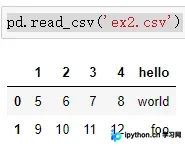
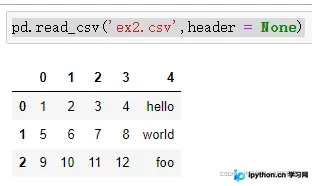
针对无表头文件,有两种处理方案:
第一种方法是允许pandas自动分配默认的列名。
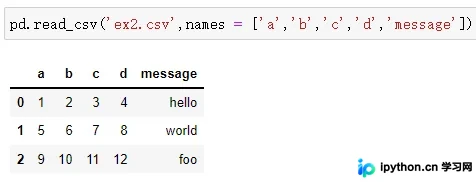
第二种方法是手动指定具体的列名。
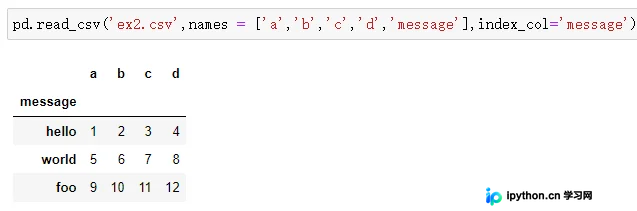
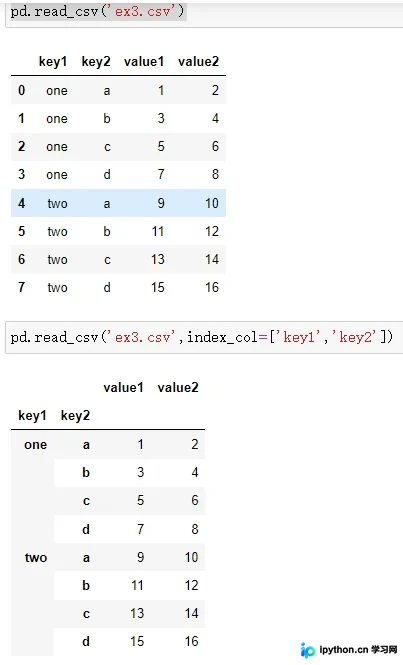
若希望将'message'列设为返回DataFrame的索引,可以指定位置为4的列作为索引,或者直接将'message'字符串传递给index_col参数。
此外,还可以从多个列构建分层索引(MultiIndex)。
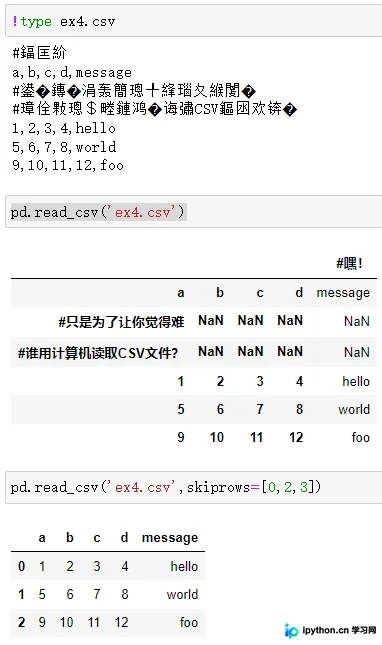
解析函数提供了丰富的附加参数以处理各种异常文件格式,例如,可以使用skiprows参数来跳过指定的行,如跳过第一行、第三行和第四行。
处理缺失值
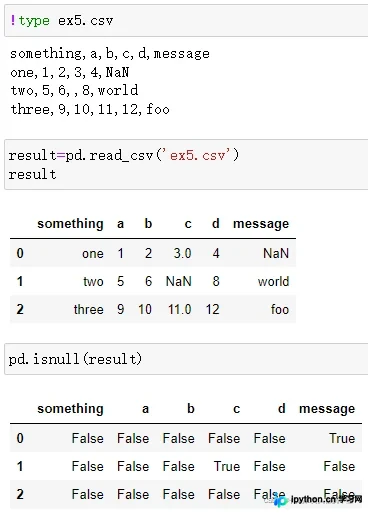
通常情况下,缺失值可能表现为不显示(即空字符串)或使用特定的标识值。
默认情况下,pandas会使用常见的缺失值标识符,如NaN和NULL。
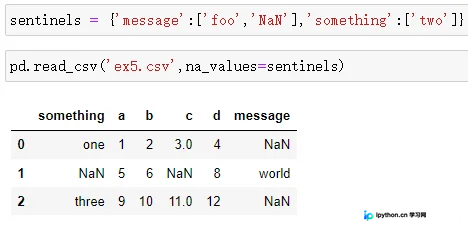
通过na_values选项,可以传入一个字符串列表或集合来定义特定的缺失值标识。
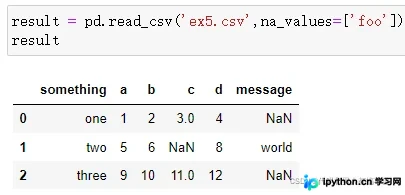
在字典格式中,可以为每一列单独指定不同的缺失值标识符。
1.1 分块读入文本文件
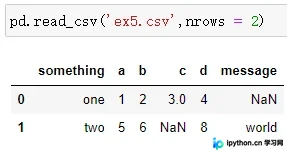
如果仅需读取文件的一小部分以避免加载整个大文件,可以指定nrows参数。
为了实现分块读取文件,可以指定chunksize参数,定义每个数据块包含的行数。
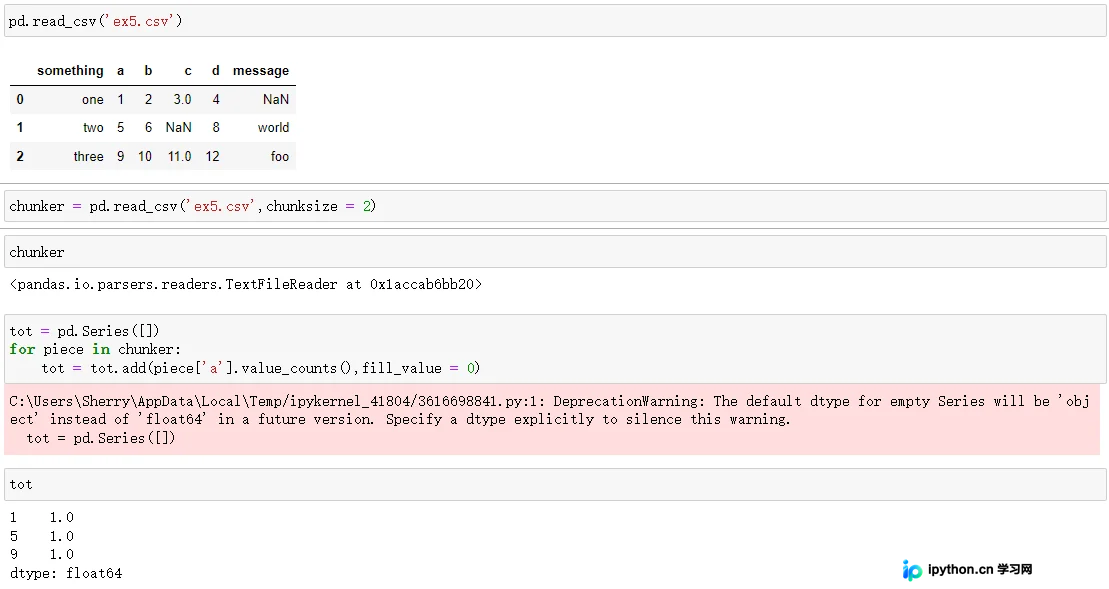
read_csv返回的TextParser对象支持根据chunksize大小遍历文件,并可对'a'列进行聚合操作以获取计数值。
1.2 将数据写入文本格式
利用DataFrame的to_csv方法,可将数据导出为逗号分隔值(CSV)文件。
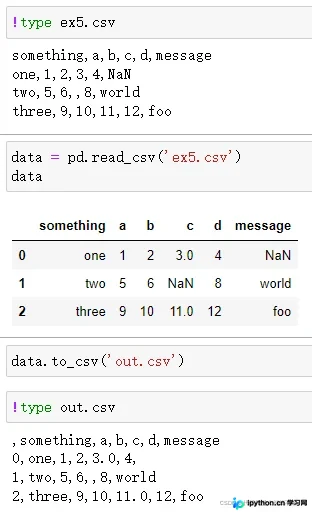
若未指定其他选项,默认会将行索引和列标签写入文件,但这两者均可选择禁止写入。
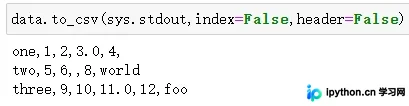
还可以仅写入列的子集,并按照指定的顺序进行输出。
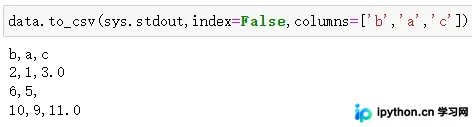
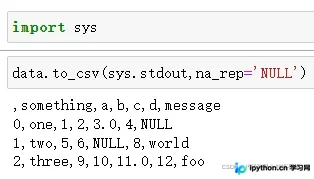
默认情况下,输出中的缺失值以空字符串表示,也可以使用其他标识值对缺失值进行标注。
(当写入目标为sys.stdout时,控制台将打印文本结果)。
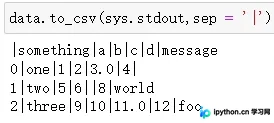
默认分隔符为逗号,可以通过sep选项选择其他分隔符。
Series对象同样具备to_csv方法。
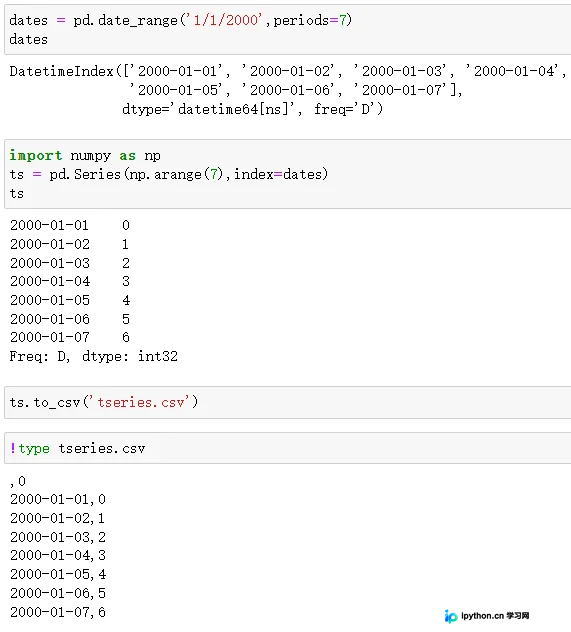
关于最后写入结果中包含索引为0的行,具体原因尚不明确。
总结
本文内容至此结束,希望能为读者提供帮助,同时也欢迎大家关注本站以获取更多精彩内容!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















