C# 实现希尔排序算法:原理、代码与性能解析
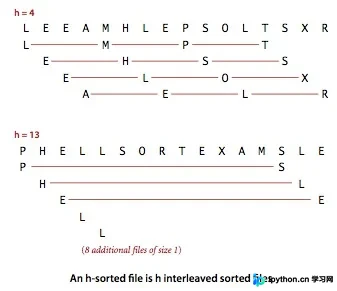
本文介绍如何使用 C# 实现希尔排序算法。通过逐步减少增量 h,将数组划分为多个子序列进行插入排序,从而实现“局部有序”。提供了完整的 C# 代码实现,包含 Swaopwatch 计时测试,并分析了其在百万级数据下的性能表现及适用场景。
2026-10-16
0



本文介绍如何使用 C# 实现希尔排序算法。通过逐步减少增量 h,将数组划分为多个子序列进行插入排序,从而实现“局部有序”。提供了完整的 C# 代码实现,包含 Swaopwatch 计时测试,并分析了其在百万级数据下的性能表现及适用场景。
本文详解如何识别并破解前端 webpack 打包的加密 JS 代码。通过分析典型模块执行逻辑,实战演示如何通过浏览器开发者工具定位关键函数(如 encode),构建局部运行环境,剥离核心加解密代码到本地 JavaScript 文件中独立执行,从而实现数据抓取中的算法复现。
本文探讨NumPy中强制类型转换的机制,重点分析整数数组赋值浮点数时的隐式截断风险。通过示例演示如何正确使用dtype查看类型,并利用astype方法进行显式类型转换,包括浮点转整数及字符串数组转数值型,帮助开发者避免数据精度丢失问题。
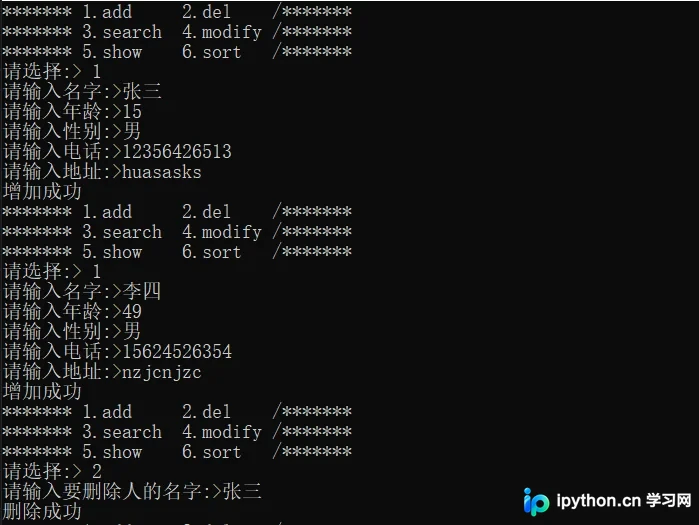
本文通过C语言项目实战,演示如何实现具备增删改查、排序功能的通讯录。重点讲解如何突破静态数组限制,使用realloc实现内存动态扩容,以及通过fwrite/fread将数据持久化至本地文件。包含完整的test.c、contact.c及contact.h代码示例与运行效果分析。
本文介绍如何利用Python标准库collections.Counter快速统计序列中元素的出现次数。通过演示随机整数列表与英文文章单词的统计案例,展示如何调用most_common方法获取出现频率最高的前N个元素及其具体频次,适用于数据清洗与文本分析场景。
本文详细解析在Python Django项目中如何使用djangorestframework-jwt库实现JWT认证机制。内容涵盖JWT优缺点分析、库的安装配置、后端登录接口开发、自定义认证成功返回数据以及settings.py中的关键参数设置,帮助开发者快速搭建安全高效的分布式认证系统。
本文详解如何使用Python实现图像隐写术,通过在RGB像素的最低有效位中修改奇偶性来隐藏文本数据。文章介绍了基于ASCII转二进制的编码算法,演示了如何逐个像素修改数值以存储信息,并提供了完整的解码逻辑。此外,还分析了该技术在JPEG等有损压缩格式下的局限性,适合希望了解基础数据隐藏技术的开发者参考。
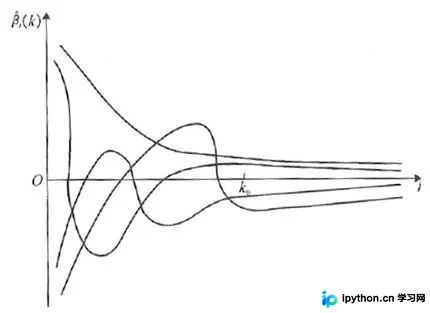
本文介绍如何在R语言中使用MASS包的longley数据集进行岭回归分析,以解决变量间的多重共线性问题。内容涵盖岭参数的选择原则、岭迹图的绘制与解读、Lambda值的最优估计方法,以及使用ridge包时可能遇到的兼容性错误及其排查建议。
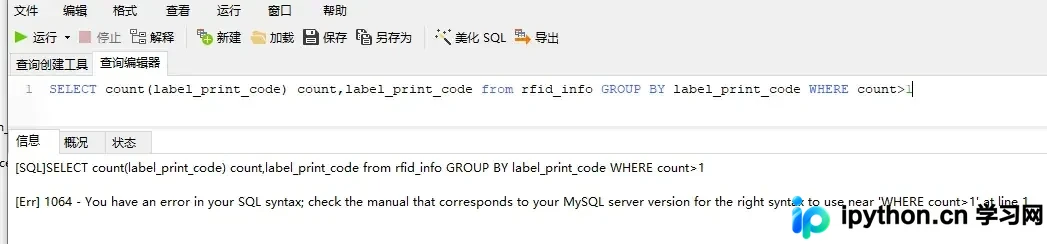
在生产环境中遇到数据重复(如标签重复)时,可利用MySQL的GROUP BY和HAVING语句快速定位问题。本文通过实际案例,演示如何编写SQL查询提取重复记录,结合临时表进行数量统计与频次占比分析,并详细解析WHERE与HAVING的区别,帮助开发者高效排查数据库异常。
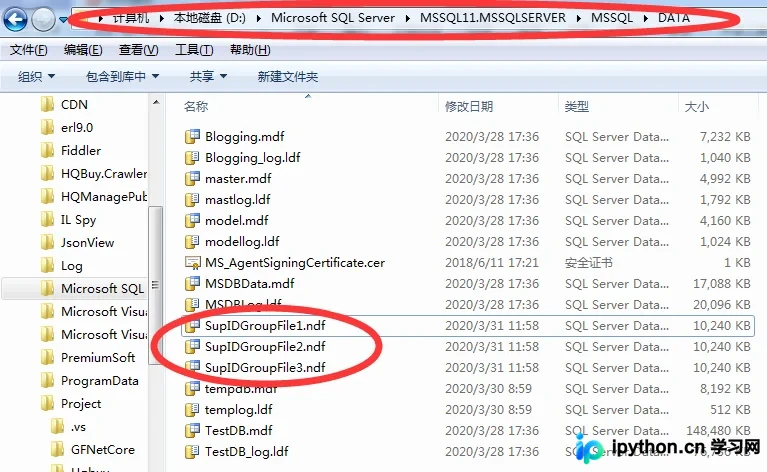
SQL Server表分区通过逻辑隔离数据提升大表读写性能。本文演示如何根据业务场景(如供应商ID)划分边界,依次创建文件组、指定存储路径、建立分区函数与方案,并通过SS图形界面或T-SQL完成表及索引分区。同时涵盖查看分区分布与维护优缺点分析。
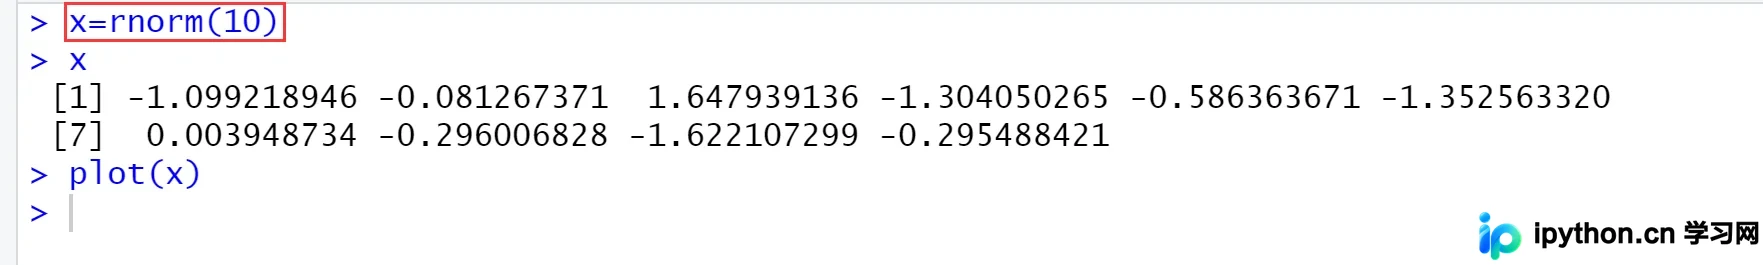
R语言中的set.seed()函数用于固定随机数生成器的种子,确保多次运行代码时生成的伪随机序列完全一致。本文将通过对比无seed设置和有seed设置下的rnorm运行结果,演示如何利用该函数实现数据分析和机器学习实验中的结果可复现性。
本文针对PHP开发中在循环内执行数据库查询导致的性能瓶颈,提供从单点优化到批量处理的完整解决方案。通过对比分析,展示如何将N次查询降为1-3次,利用前置批量获取数据并在内存中组装,显著提升响应速度并降低服务器压力。



