


R语言岭回归实战:解决多重共线性与lambda选择

本文介绍如何在R语言中使用MASS包的longley数据集进行岭回归分析,以解决变量间的多重共线性问题。内容涵盖岭参数的选择原则、岭迹图的绘制与解读、Lambda值的最优估计方法,以及使用ridge包时可能遇到的兼容性错误及其排查建议。
结果或目标:为什么需要岭回归
在使用普通最小二乘法(OLS)进行线性回归时,如果自变量之间存在严重的多重共线性,会导致回归系数估计方差增大,符号甚至可能出现与实际意义不符的情况。为了解决这一问题,引入岭回归(Ridge Regression)通过引入L2正则化项来缩小系数,提高模型的稳定性。
准备条件:数据加载与初步诊断
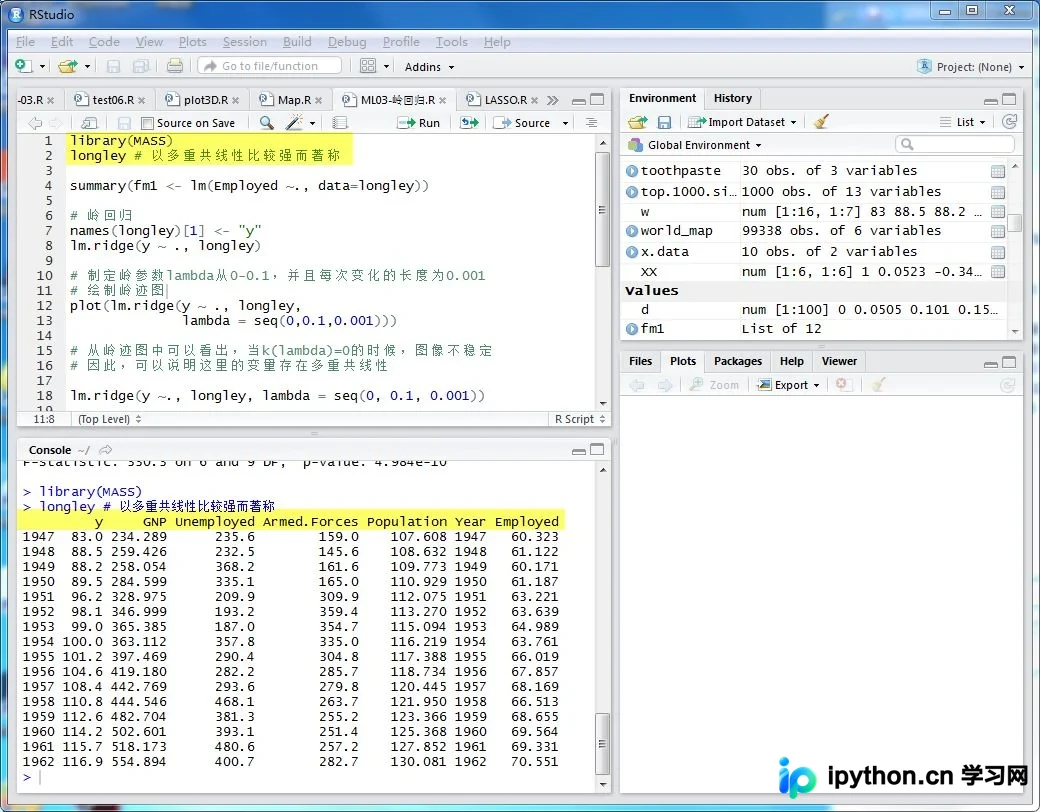
我们将使用 MASS 包中内置的 longley 数据集。该数据集包含了1947-1962年美国的经济指标,其变量间存在显著的多重共线性。
首先,我们需要定义因变量 y 和自变量矩阵 X,并查看普通线性模型的拟合效果。
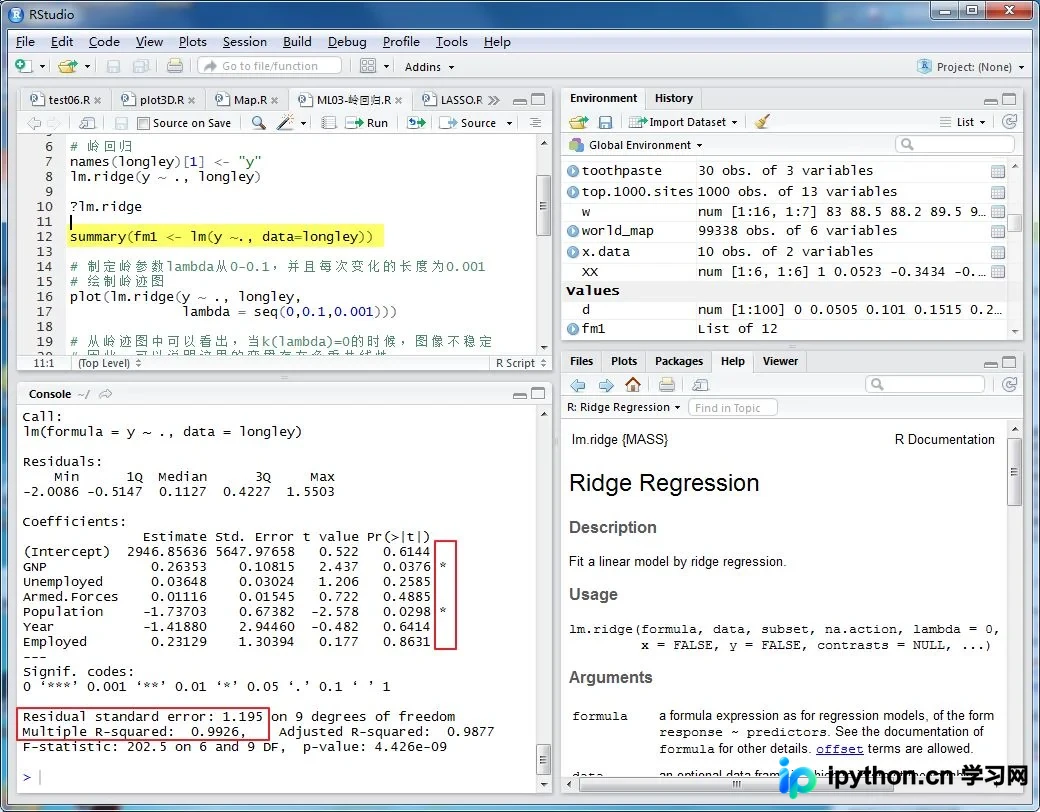
在构建岭回归之前,先运行标准线性回归,观察统计结果:
从输出结果可见,虽然模型的 R-squared 高达0.9926,拟合程度看似极佳,但各个自变量的显著性检验(t检验)往往不显著,且部分系数符号可能与经济常识相悖。这是多重共线性的典型表现,表明直接使用线性模型的效果并不理想。
真实操作顺序:岭回归实施步骤
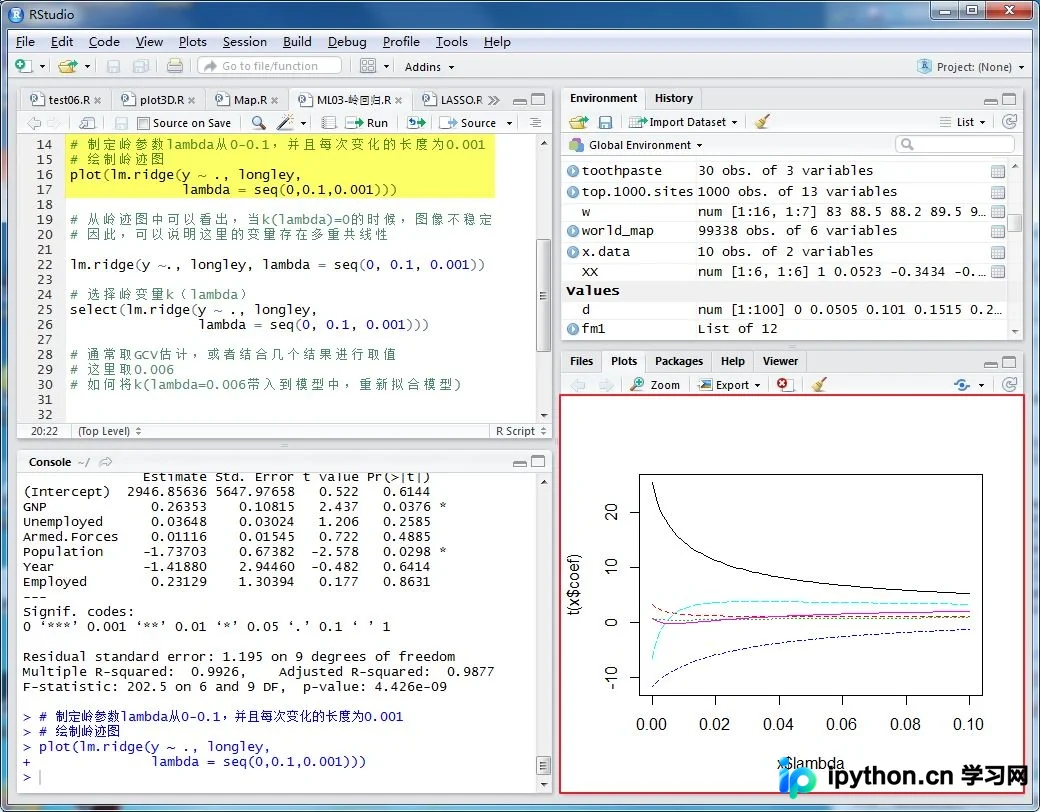
第一步:绘制岭迹图识别共线性
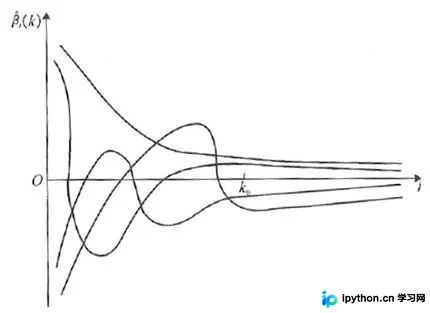
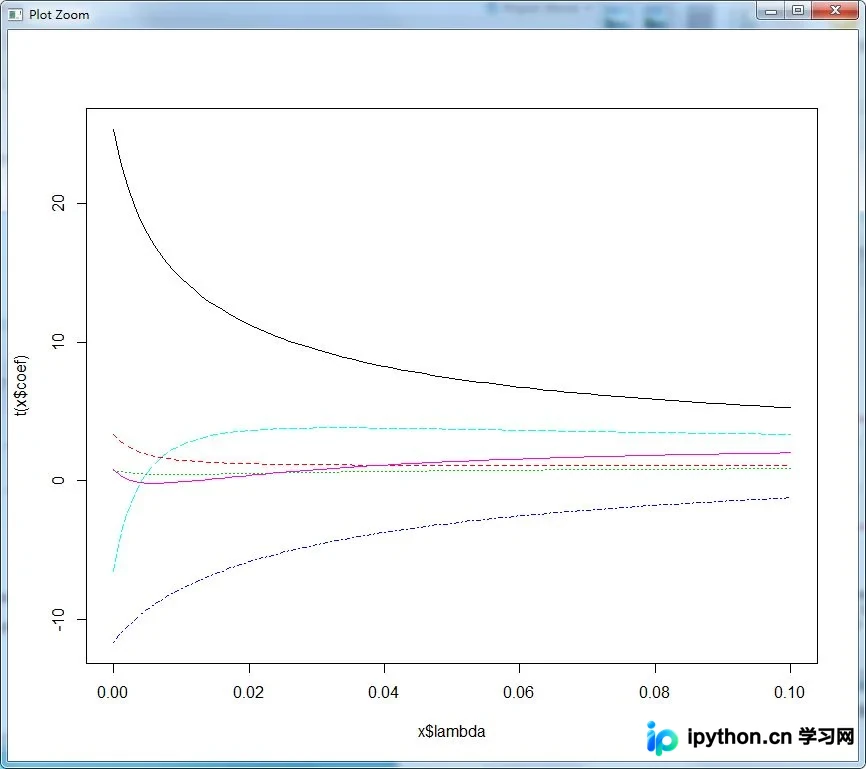
岭迹图展示了回归系数随正则化参数 lambda 变化的轨迹。通过观察系数的稳定性,可以初步判断是否存在多重共线性。
在R中,可以使用 MASS::rlm 或专门的 ridgelm 相关功能,或者手动计算不同 lambda 下的系数。通常 lambda 从0开始逐渐增加。
绘制完整的岭迹图:
解读完成状态: 当 lambda=0 时,若各条系数曲线波动剧烈,说明存在多重共线性。随着 lambda 增大,系数趋于稳定,即达到了“基本稳定”的状态。
第二步:确定最优岭参数 lambda
选择合适的 lambda 是岭回归的关键。一般遵循以下原则:
- 使得各回归系数的岭估计基本稳定。
- 使原本符号不合理的回归系数变得合理。
- 回归系数没有出现不符合实际意义的绝对值。
- 残差平方和增大的幅度在可接受范围内。
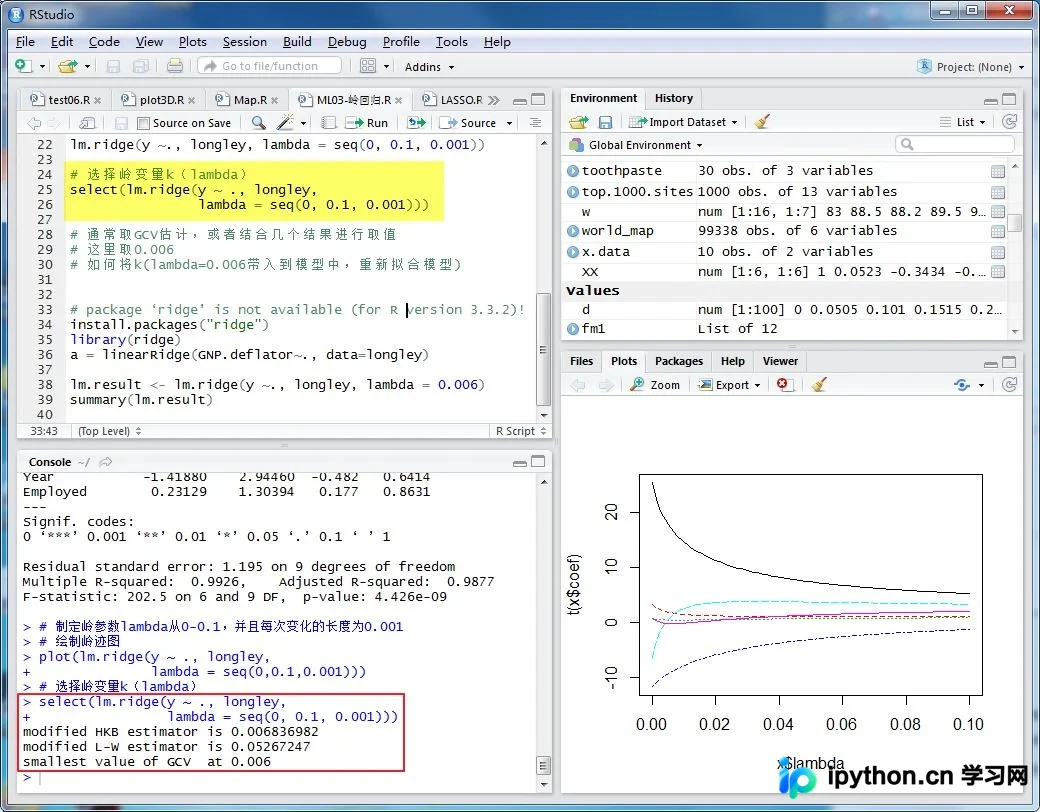
为了定量选择 lambda,我们可以计算不同 lambda 下的广义交叉验证(GCV)值或其他准则。
详细展示岭参数选择过程:
从岭参数估计图中可以看出,由于使用了不同的估计方法(如最小残差、GCV等),可能会得到几个候选值。通常优先参考 GCV 估计,或者结合多个结果综合取值。在本例中,选取 lambda = 0.006 作为一个较好的平衡点。
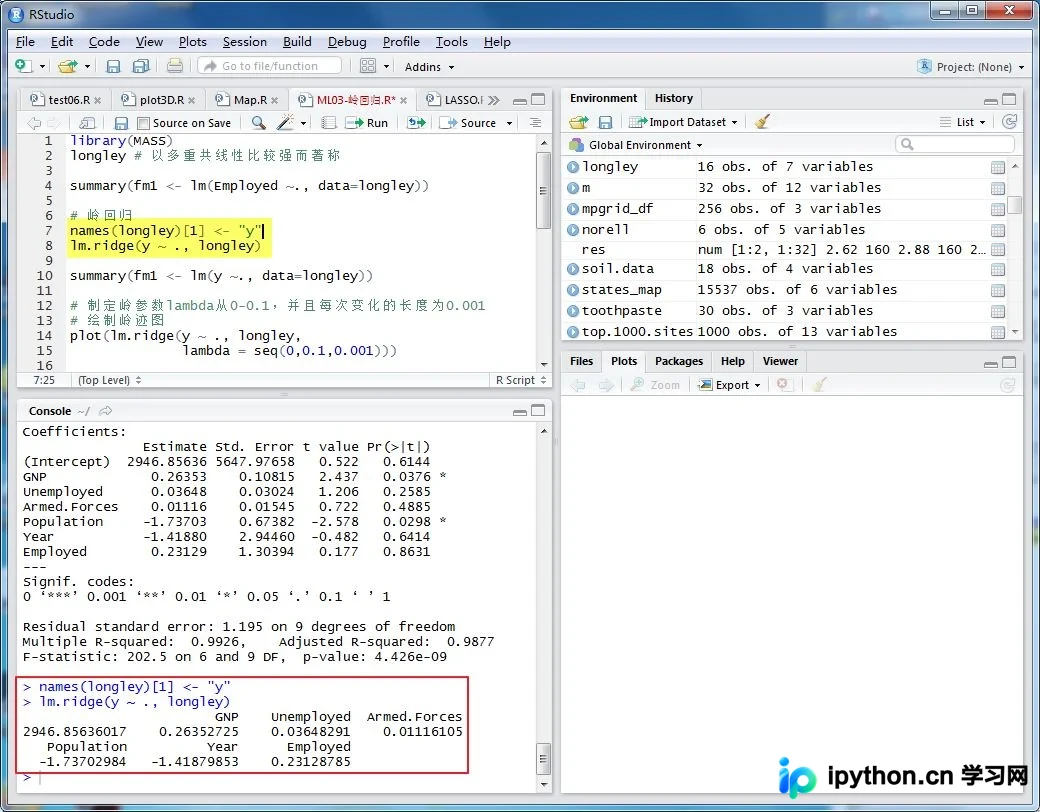
第三步:构建最终岭回归模型
选定 lambda 后,使用选定的 lambda 值重新拟合模型,得到最终的系数估计。
排错:使用 ridgemodel 或 ridge 包的常见问题
在实际操作中,除了基础逻辑,还常遇到第三方包的使用问题。例如在使用 ridge 包时,可能会因为版本兼容性或函数调用方式出现报错。
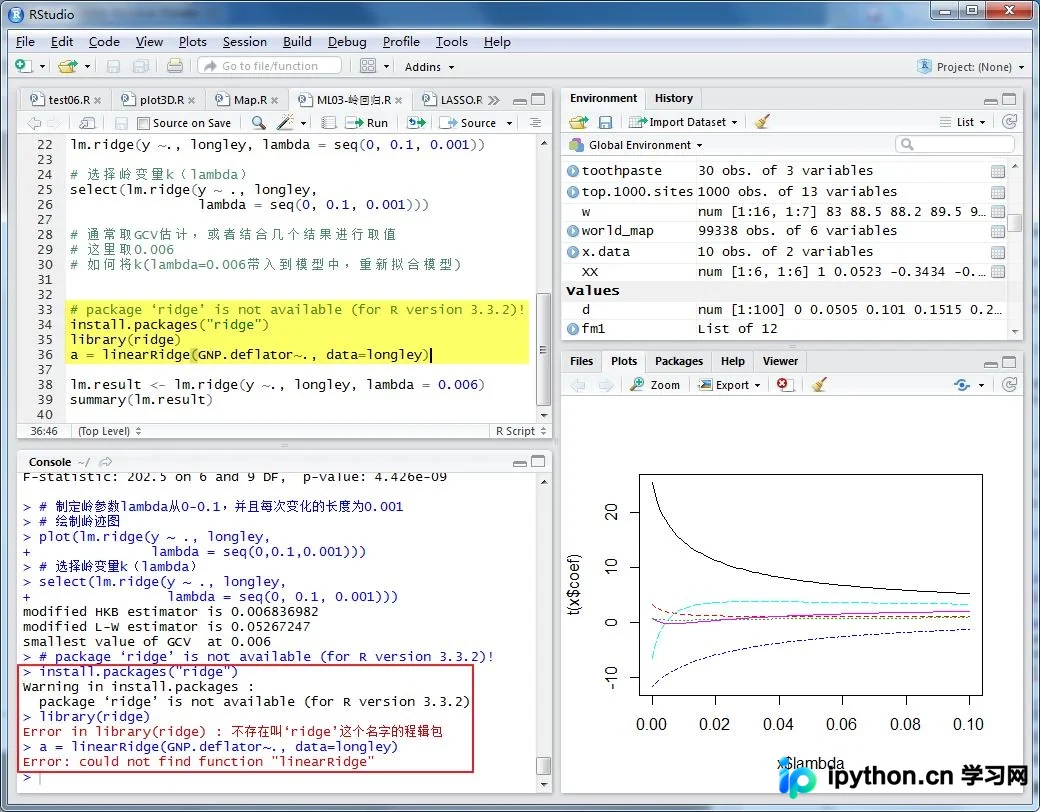
注意事项: 如果当前使用的包报错,请检查:
1. 是否安装了最新版本的 ridge 或 glmnet。
2. 输入数据是否为矩阵格式,而非数据框。
3. 确认函数参数 lambda 的传递方式是否符合文档要求。
简要总结
岭回归通过引入偏误来降低方差,有效缓解了多重共线性带来的影响。虽然岭参数的计算方法多样,岭迹图的变量筛选也具有一定的主观性,但结合GCV等客观准则进行选择,仍能显著提升模型的稳健性。对于包含所有变量的岭回归模型,需注意其解释性与普通变量选择方法的区别,它更适合预测而非严格的因果推断。
以上就是R语言实现岭回归解决多重共线性的详细内容,更多关于R语言统计分析、岭回归算法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















