MySQL 索引失效的常见场景与有效性验证
本文详解 MySQL 中导致索引失效的典型场景,包括不等于查询、函数处理、隐式类型转换、左模糊匹配及低区分度字段等。通过 EXPLAIN 命令验证执行计划,并结合实际测试优化 SQL 语句,提升查询效率。
2026-10-14
0



本文详解 MySQL 中导致索引失效的典型场景,包括不等于查询、函数处理、隐式类型转换、左模糊匹配及低区分度字段等。通过 EXPLAIN 命令验证执行计划,并结合实际测试优化 SQL 语句,提升查询效率。
MySQL 执行 GROUP BY 时通常需创建临时表,但可通过索引优化避免。本文详解两种高级扫描方式:松散索引扫描(要求全最左前缀且仅用 MIN/MAX)和紧凑索引扫描(利用范围条件或常量覆盖填补索引漏洞)。通过具体 SQL 示例分析适用条件与禁忌,帮助提升查询效率。
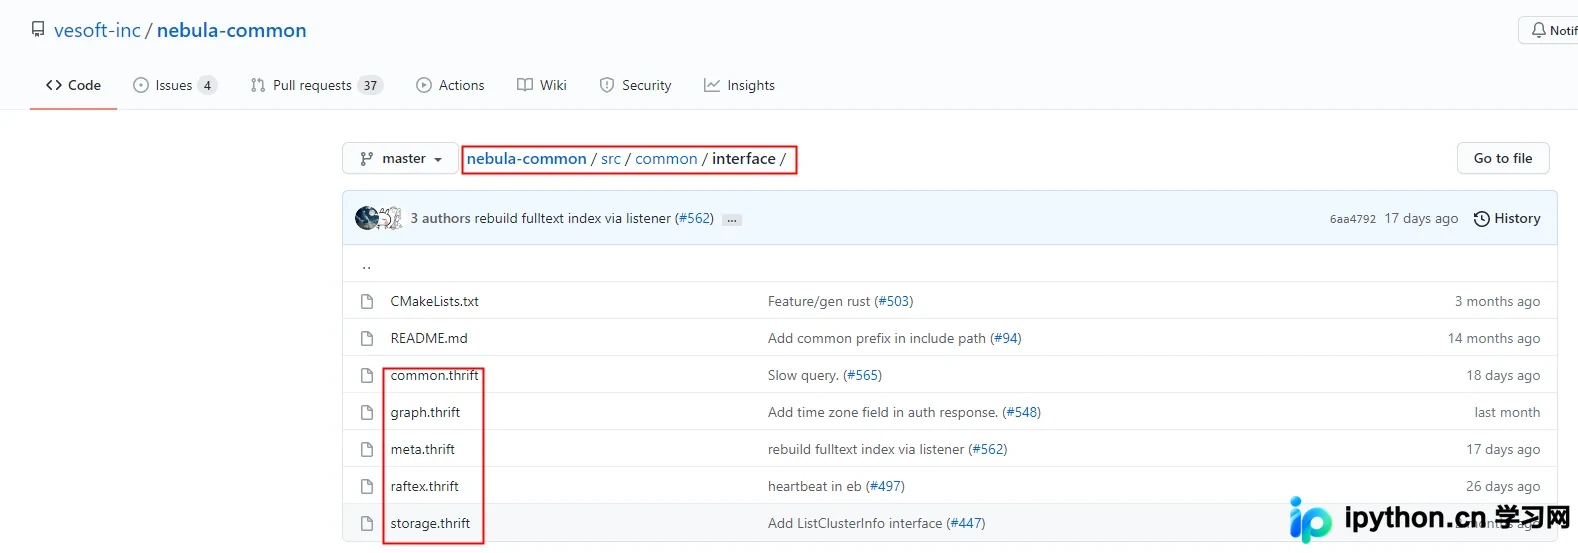
由于Nebula Graph官方未提供C#客户端,可通过源码中的Thrift模板自行生成。核心步骤包括准备Linux环境、安装特定版本的GCC与CMake、使用Fbthrift编译器对nebula-common进行编译,从而提取生成的C#接口定义文件。本文详述从零开始的环境搭建与编译流程。
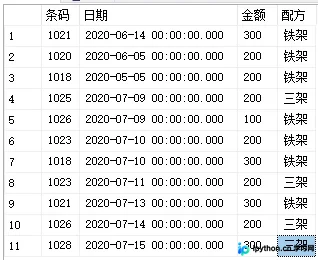
在 SQL Server 中无法直接使用类似 Oracle 的 rownum 来删除前 N 行。本文介绍了三种实现方式:利用 CTE 配合 ROW_NUMBER() 函数(推荐,无需建表)、通过创建临时视图或临时表删除、以及直接删除 Top N 记录(需注意去重风险)。重点说明如何通过排序字段确保删除的是真正的前N条业务数据,避免误删。
解决MyBatis-Plus默认忽略null值导致修改失败的问题,通过在实体类添加@TableField(strategy=FieldStrategy.IGNORED)实现空值覆盖。同时提供使用updateForSet方法进行SQL直写的代码示例,以完成指定字段的精确更新操作。
本文详细介绍MySQL中LOCATE和POSITION函数的用法,涵盖基本语法、参数说明及大小写敏感特性。通过具体SQL示例演示如何查找子串首次出现位置及指定起始位置后的索引,帮助开发者高效处理字符串匹配查询任务。
本文详解SQL Server中两种常用的表数据复制语句:INSERT INTO SELECT和SELECT INTO。前者需目标表已存在,支持指定列或全部列复制;后者自动创建目标表,但要求目标表不存在且通常只能执行一次。通过具体代码案例对比两者优先级、适用场景及语法细节,帮助开发者高效进行数据备份与迁移。
本文详解 MySQL 中回表(二次查询)导致的性能损耗机制,以及利用覆盖索引实现“只查索引”的优化策略。通过对比聚簇索引与普通二级索引的执行过程,结合 EXPLAIN 结果分析,展示如何通过联合索引避免回表,提升 SQL 执行效率并降低全表扫描风险。
本文详解 SQL Server 中触发器的基本概念、DML 与 DDL 分类,以及 AFTER 和 INSTEAD OF 的区别。重点解析 inserted 与 deleted 虚拟表在不同操作中的数据表现,并通过 Insert、Delete、Update 及级联更新的具体代码示例,演示如何创建和维护触发器以实现数据校验与审计日志。
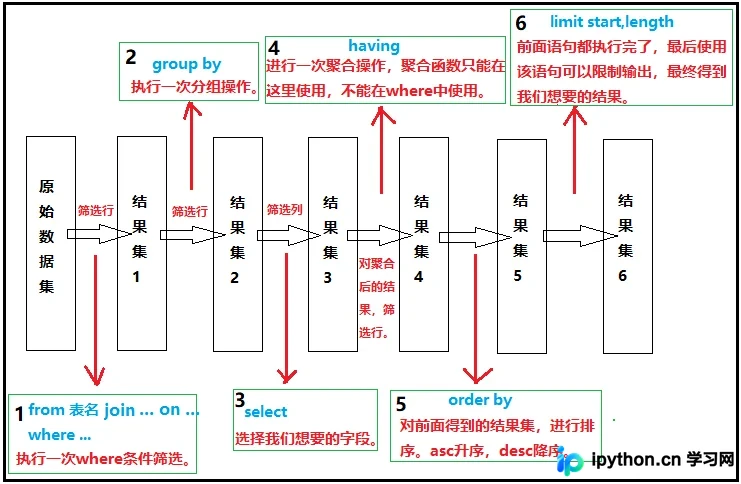
本文详细解析MySQL SQL查询语句的书写顺序与底层执行顺序。通过对比 SELECT、FROM、WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 关键字,阐明两者为何不同及其背后的逻辑。同时重点探讨 HAVING 与 SELECT 的执行先后争议及优化建议,帮助开发者写出更高效的SQL代码。
详解MySQL联合索引的最左前缀匹配原则。通过实验对比(a,b,c)与(a,c)在查询province和district时的执行计划差异,揭示为何跳过中间字段会导致索引失效。总结范围查询对后续索引的影响,并提供SQL索引设计的最佳实践建议。

本文详细解析 SQL Server 中的核心数据类型,涵盖整型(int/tinyint)、精确数值(decimal/numeric)、近似数值(float/real)、货币(money)、日期时间(datetime)以及字符二进制类型(char/varchar/binary)。通过对比各类型的存储范围、精度特性及字节占用,帮助开发者在数据库设计时选择最适合的数据类型,以优化存储空间并保证数据准确性。



