


MySQL SQL查询语句书写顺序与执行顺序详解

MySQL中SQL语句的书写顺序与执行顺序并不一致,理解两者的差异对于编写高效、准确的查询至关重要。本文将逐层拆解从SELECT到LIMIT的完整流程,并通过图解说明各步骤的处理时机,重点分析WHERE与HAVING的区别及SELECT与HAVING的执行关系。
完整的SQL语句书写顺序
在编写MySQL查询时,我们需要遵循一定的语法结构,这个结构即为“书写顺序”。一个标准的SELECT查询通常包含以下关键字段,按书写逻辑排列如下:
SELECT:指定需要返回的列或表达式。FROM:指定数据来源表或子查询结果集。WHERE:对行进行初步过滤(不支持聚合函数)。GROUP BY:将数据分组,为聚合做准备。HAVING:对分组后的数据进行过滤(支持聚合函数)。ORDER BY:对最终结果集进行排序。LIMIT:限制返回的行数。
其中 SELECT ... FROM 是最基本的语法构成,必须存在;而 WHERE、GROUP BY、HAVING、ORDER BY 和 LIMIT 则是可选部分,可以根据实际需求组合使用。
SQL语句的实际执行顺序
虽然我们在代码中是按书写顺序排列关键字,但数据库引擎在处理SQL时,会按照完全不同的逻辑顺序来执行。理解执行顺序有助于我们排查错误和优化性能。
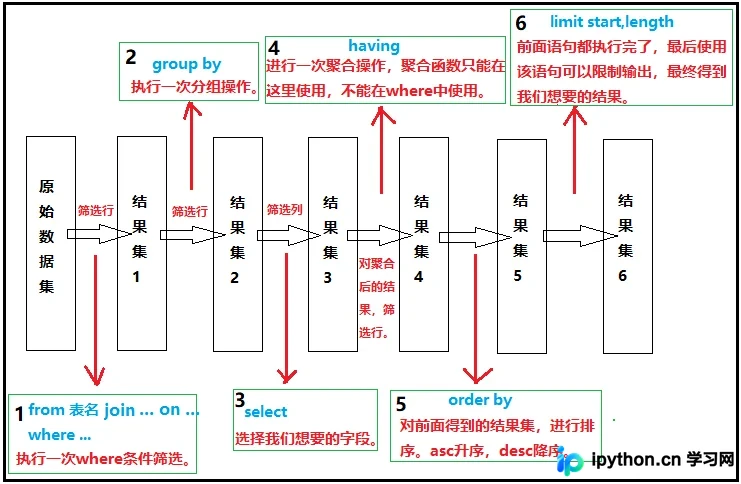
以下是具体的执行步骤解析:
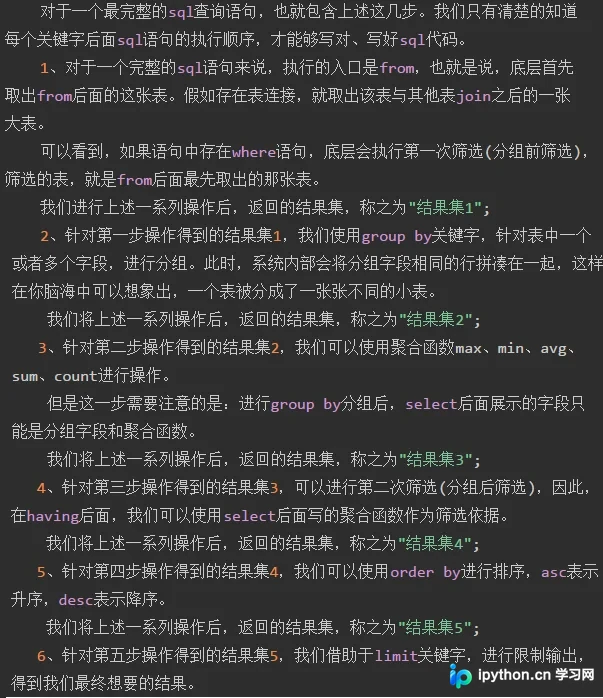
1. FROM阶段:首先确定数据来源,如果是多表关联,先完成笛卡尔积连接,并根据连接条件过滤掉不匹配的行。
2. WHERE阶段:在连接好的临时表中,根据 WHERE 子句的条件进行行级过滤,去掉不符合条件的记录。
3. GROUP BY阶段:将经过过滤的数据按照指定的列进行分组。
4. HAVING阶段:在分组的基础上,使用 HAVING 条件过滤掉不符合条件的组。注意这里可以使用聚合函数。
5. SELECT阶段:计算 SELECT 列表中定义的列、表达式以及别名。这是最后一步确定最终输出内容的环节。
6. DISTINCT阶段:如果使用了 DISTINCT 关键字,此时会将重复的行去除。
7. ORDER BY阶段:按照 ORDER BY 指定的列进行排序。
8. LIMIT阶段:最后截取指定数量的数据返回给用户。
关于SELECT和HAVING执行顺序的说明
在实际使用中,许多开发者会对 HAVING 和 SELECT 之间的执行先后产生困惑,特别是当两者涉及相同的字段或别名时。由于 HAVING 是对分组结果的过滤,而 SELECT 是确定输出内容,数据库引擎必须在处理完分组数据后才能判断哪些组保留,随后才去生成最终的输出列表。
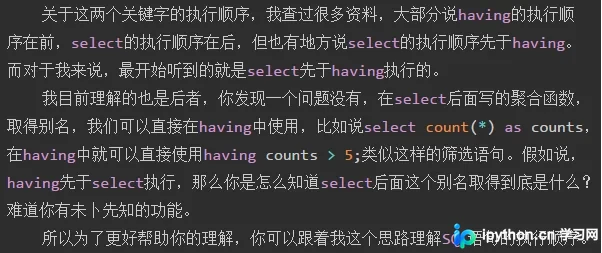
尽管在执行流上 HAVING 往往早于或部分并行于 SELECT 的计算,但由于 MySQL 在某些版本中对别名的处理方式可能存在差异,建议在涉及复杂聚合逻辑时,尽量避免在 HAVING 中直接使用未在 SELECT 中显式计算的别名,而是使用原始表达式以确保兼容性。
总结
掌握 SQL 的书写顺序有助于我们规范代码风格,而理解执行顺序则是优化查询性能和解决语法错误的根本。简单来说:先找到数据源,再筛选行,接着分组并筛选组,最后选出展示的内容并排序限制。遵循这一逻辑,能够写出更加健壮和高效的 MySQL 查询语句。
以上就是MySQL系列SQL查询语句书写顺序及执行顺序详解的详细内容,更多关于SQL查询语句书写顺序及执行顺序的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















